VAMB
宏基因组分箱VAMB(宏基因组分箱变异自编码器)使用深度变异自编码器学习重叠群(contigs)的潜在表示,基于其四核苷酸频率和多个样本间的共丰度谱,实现准确的宏基因组分箱。 [1]
如何获取输出模型文件
以下是团队运行的简要工作流,用于获取我们在工具页面上呈现的输出模型示例。
输入
共组装重叠群(FASTA)+ 样本级 BAM 比对文件
输出
TSV,包含每个簇的指标:簇名称、半径、峰谷比、类型(正常/孤立/备用)、总碱基对数、重叠群计数、代表重叠群
conda install -c bioconda vamb
Docker 镜像: quay.io/biocontainers/vamb:4.1.3--pyhdfd78af_0
样本 1 肠道菌群(来自 PRJNA795985 的 3 个样本,每个 1M reads 对)使用 组装 共组装,使用 VAMB v5.0.4 分箱,产生 7,212 个簇。
- 1
从 PRJNA795985 下载 3 个样本
for SRR in SRR17531757 SRR17531762 SRR17531772; do fastq-dump --split-files --gzip -X 1000000 --outdir reads/ $SRR; done
从"健康美国成人的饮食和抗菌素耐药性"研究(Shrestha 等人,mBio 2022)下载每个样本 1M reads 对(每个约 70 MB 压缩)。
- 2
使用 MEGAHIT 共组装所有样本
megahit -1 reads/SRR17531757_1.fastq.gz,reads/SRR17531762_1.fastq.gz,reads/SRR17531772_1.fastq.gz -2 reads/SRR17531757_2.fastq.gz,reads/SRR17531762_2.fastq.gz,reads/SRR17531772_2.fastq.gz -o assembly --min-contig-len 1500 -t 8 --presets meta-sensitive
产生 14,934 个重叠群(≥1,500 bp)。
- 3
将每个样本映射到重叠群
for SRR in SRR17531757 SRR17531762 SRR17531772; do minimap2 -ax sr -t 8 assembly/final.contigs.fa reads/${SRR}_1.fastq.gz reads/${SRR}_2.fastq.gz | samtools sort -@ 4 -o bams/${SRR}.sorted.bam && samtools index bams/${SRR}.sorted.bam; done - 4
运行 VAMB v5.0.4
vamb bin default --outdir vamb_out --fasta assembly/final.contigs.fa --bamdir bams/ -m 1500 --minfasta 200000 -p 8
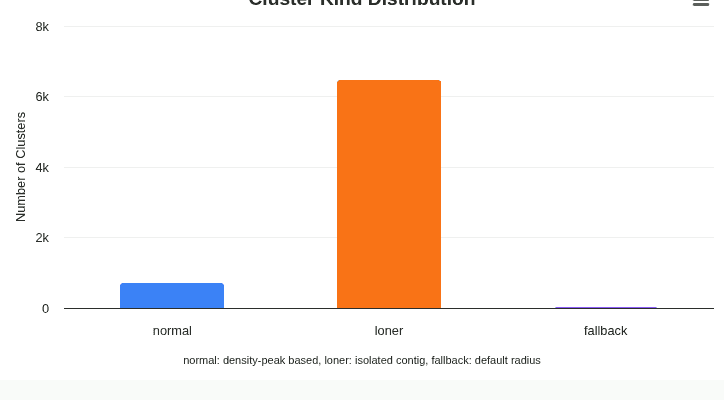
产生 vae_clusters_metadata.tsv,包含 7,212 个簇(715 个正常,6,472 个孤立,25 个备用)。
使用的材料
示例输出文件
下载工具页面演示中使用的输出文件。您可以直接上传到 IntMeta 来探索可视化。
单个和比较
分组分析
图表参考
IntMeta 中 VAMB 生成的所有 22 个可视化的详细描述。
cluster-kind-distribution
显示来自'type'列的簇类型分布的饼图:正常(由潜在空间中的密度峰值分离)、孤立(单个重叠群的隔离簇)和备用(分配默认聚类半径)。健康的组装产生主要是正常簇;大量备用簇表明分离度差。
genome-size-distribution
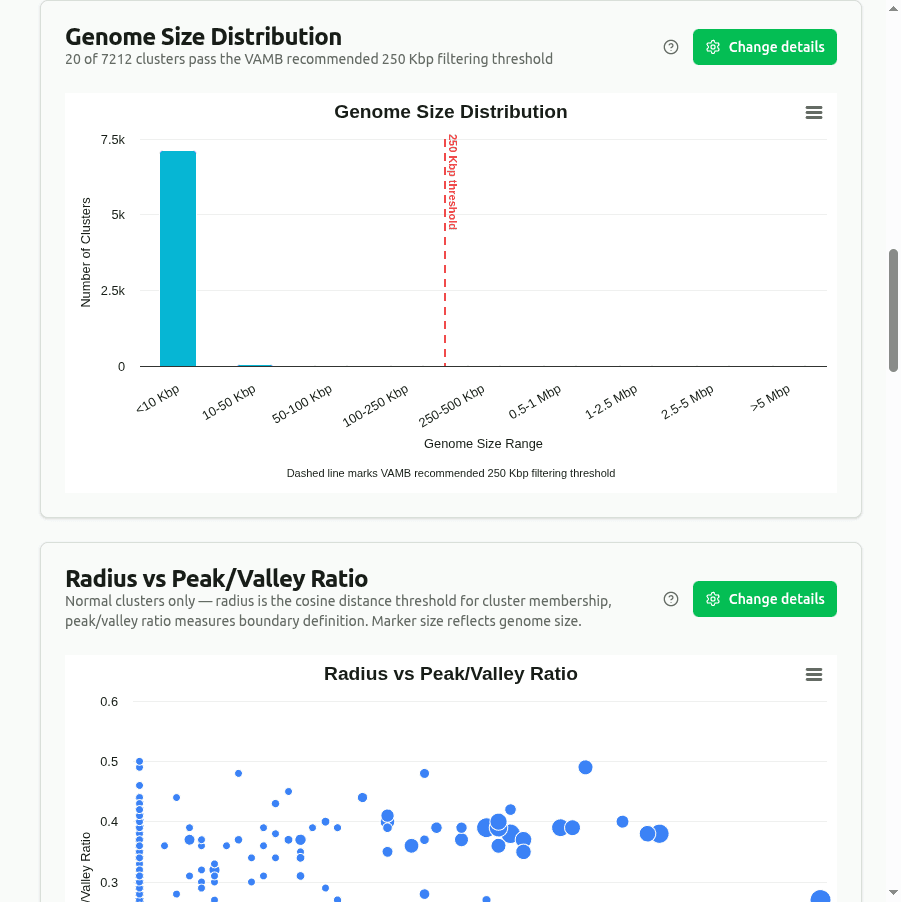
显示每个簇的总碱基对数的柱状图,按大小排序并按类型着色。VAMB 建议过滤 250 Kbp 以下的簇并丢弃备用簇以进行下游分析。
radius-vs-pvr
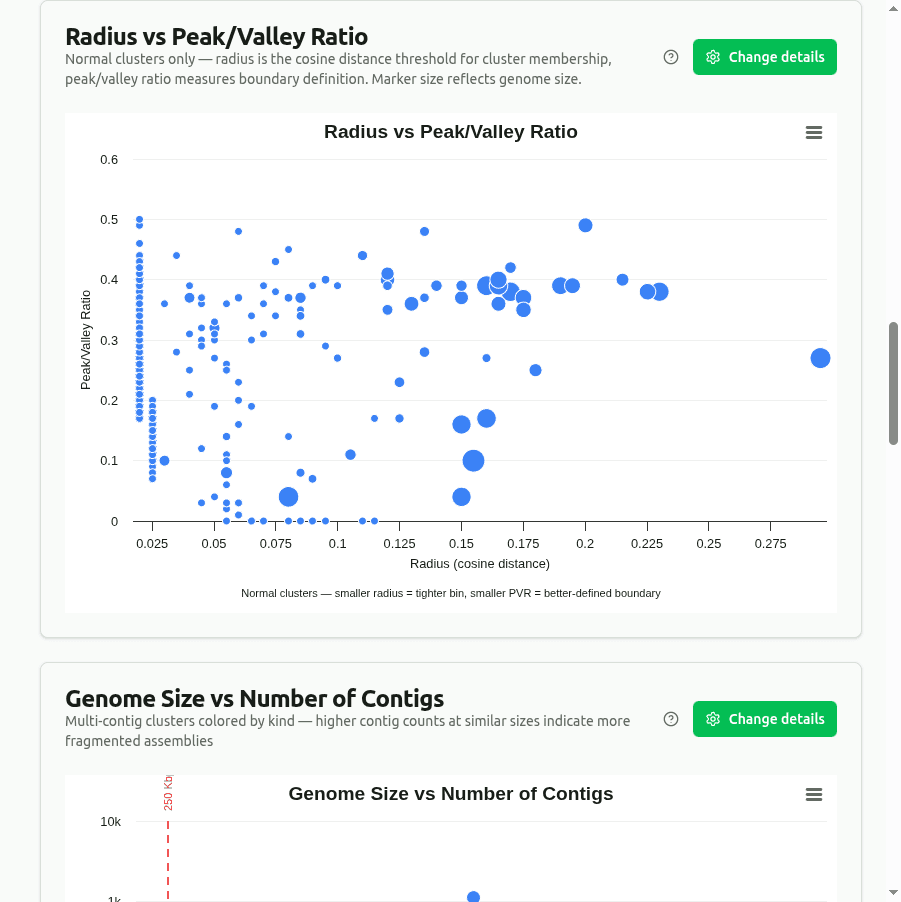
聚类半径与峰谷比(PVR,来自'peak valley ratio'列)的散点图,按类型着色。正常簇通常具有更高的 PVR(更清晰的密度分离)和更紧的半径。低 PVR 与大半径表示分离度差的簇。
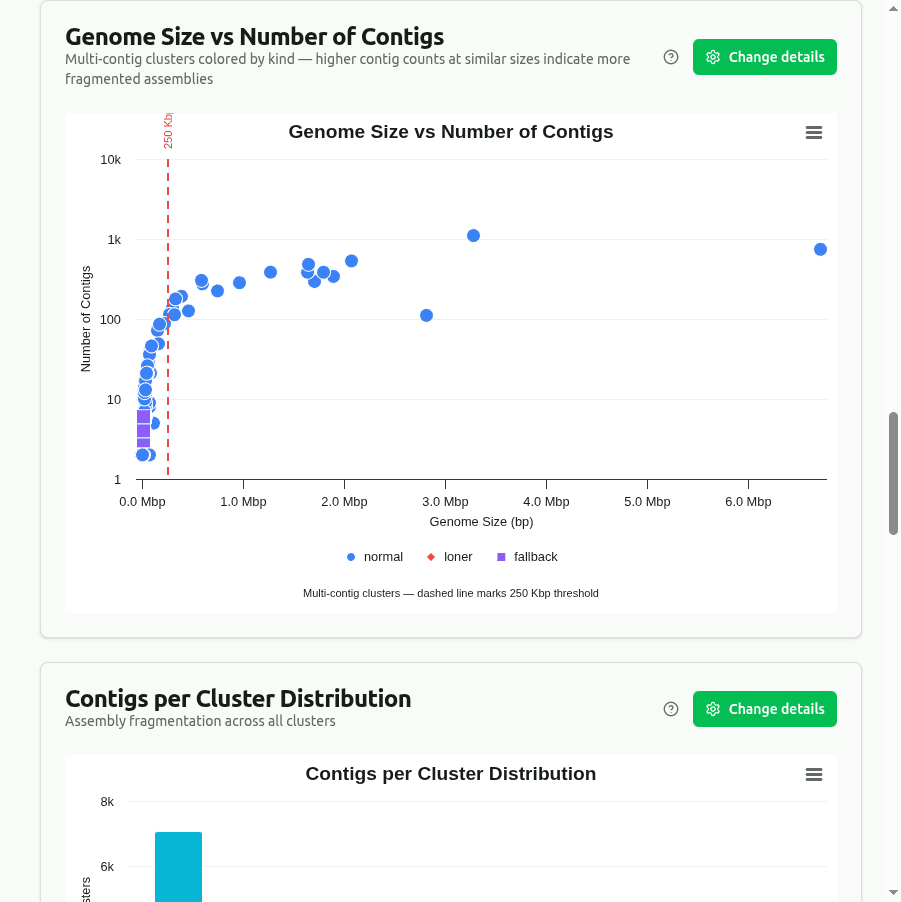
genome-size-vs-contigs
总碱基对数(基因组大小)与每个簇的 ncontigs 的散点图。分离良好的 bin 在中等重叠群计数和实质性基因组大小处聚集。左上方的点(许多重叠群,小基因组)可能表示嵌合簇。
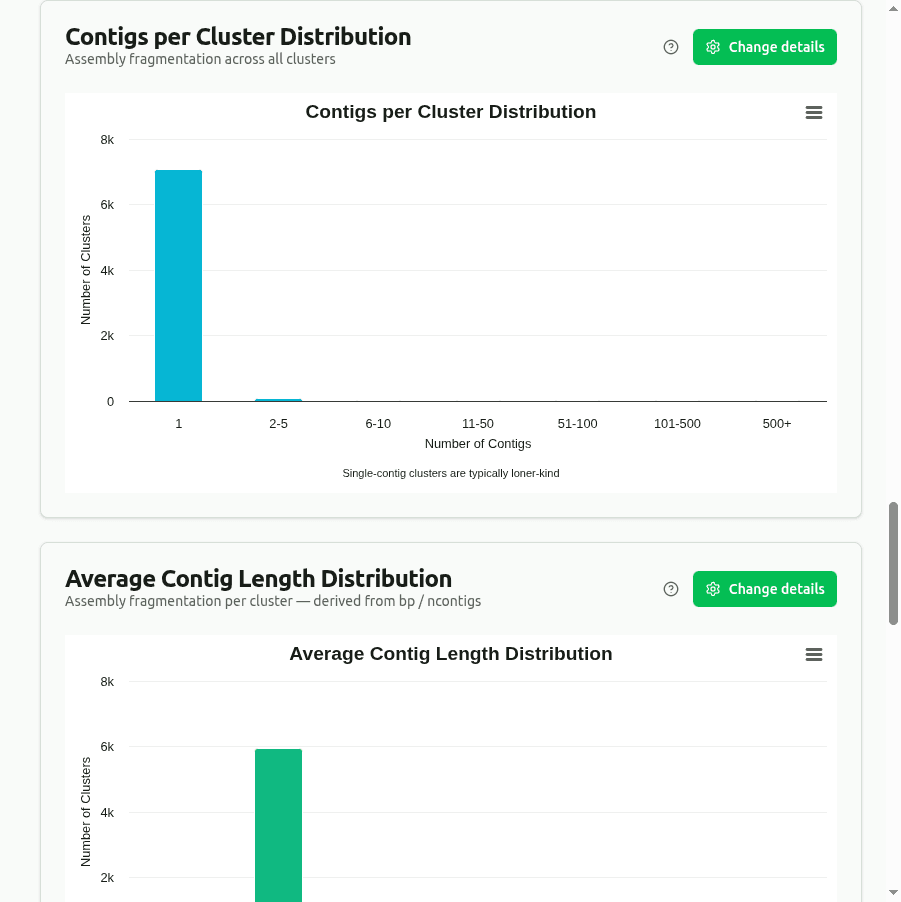
contigs-per-cluster
每个簇的 ncontigs 柱状图,按类型着色。非常高的重叠群计数可能表示过度破碎或嵌合簇合并了不相关的重叠群。
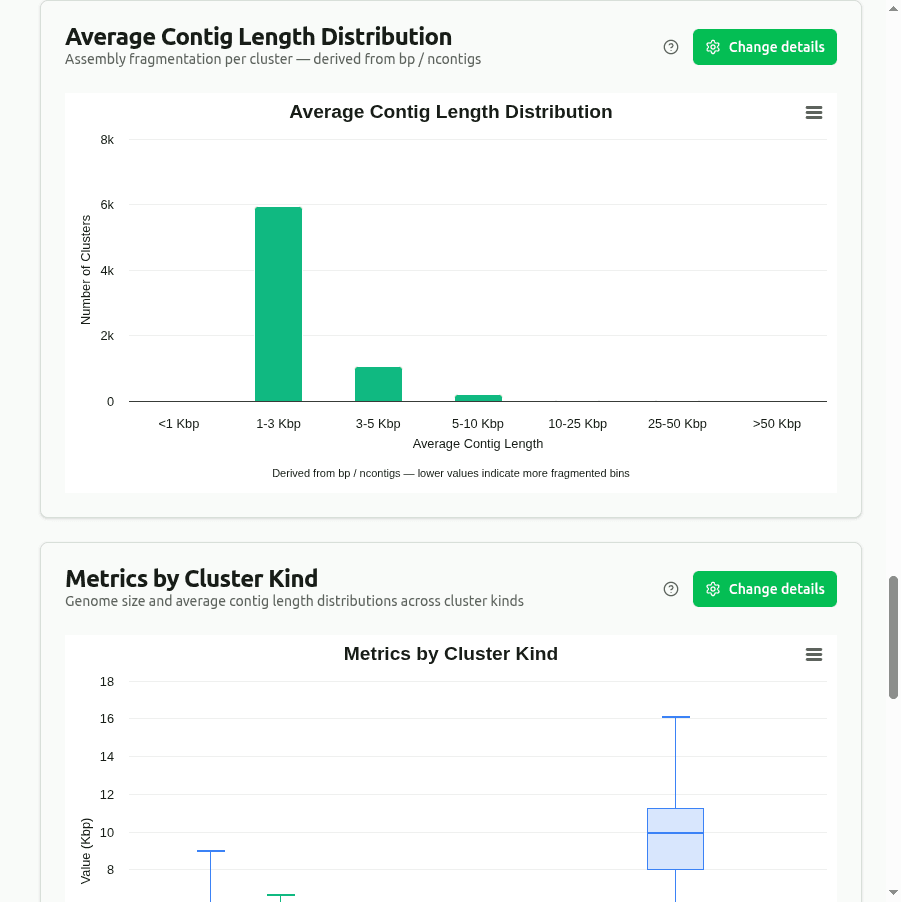
avg-contig-length
每个簇的平均重叠群长度(总碱基对数 / ncontigs)的柱状图。较高的值表示具有较长单个重叠群的更好组装基因组。低平均值表示高度破碎的组装。
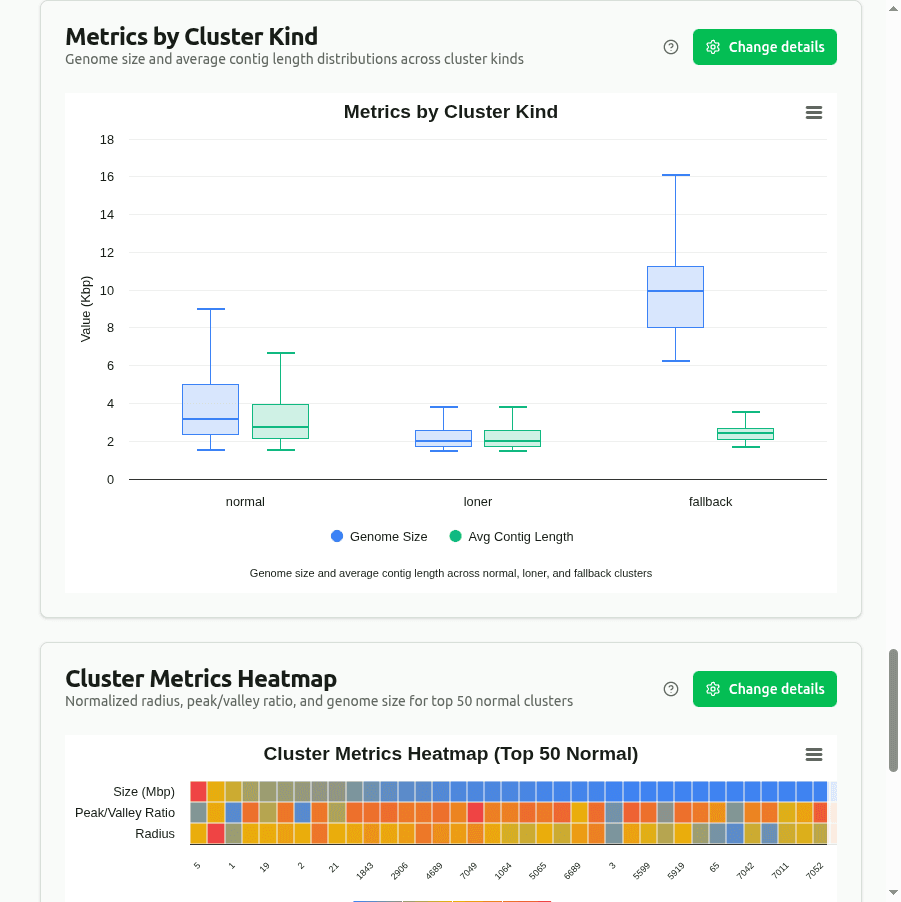
metrics-by-kind
比较基因组大小(bp)、重叠群计数和半径在三种簇类型(正常、孤立、备用)间分布的分组箱线图。揭示系统差异,例如孤立簇往往更小,只有单个重叠群。
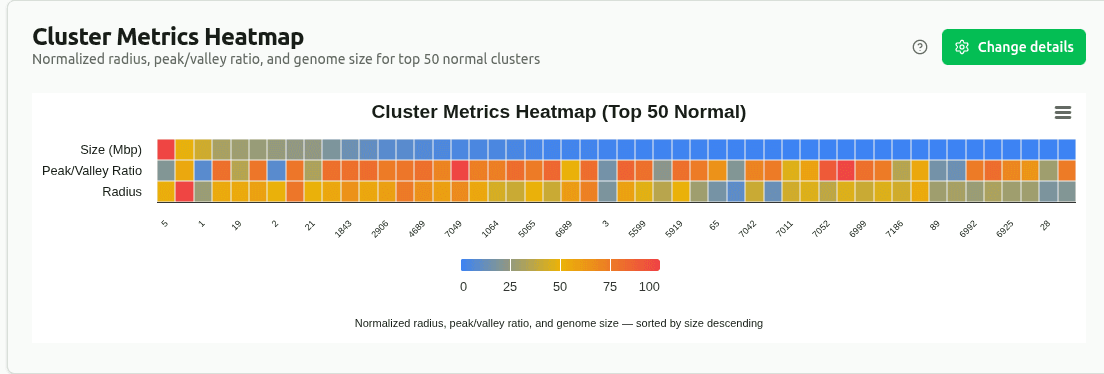
cluster-metrics-heatmap
显示前面簇的最大最小标准化指标(bp、ncontigs、半径、峰谷比)的热图。每个指标在其列内缩放至 0–1;深色单元 = 更高的相对值。有利于识别异常簇。
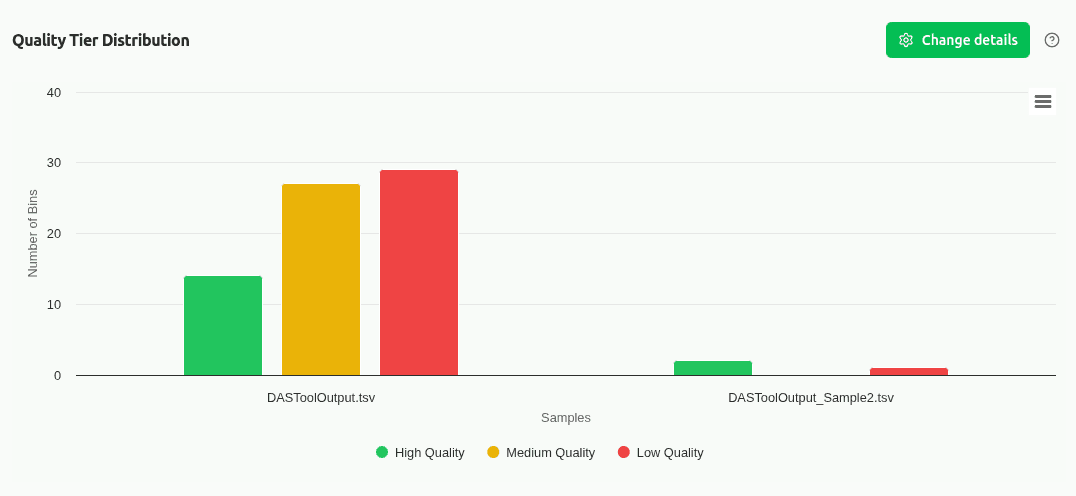
comp-quality-tiers
比较启发式质量等级(基于基因组大小和 N50 阈值的高/中/低)分布跨样本的分组柱状图。揭示哪个样本产生了更多高质量的 VAMB 簇。
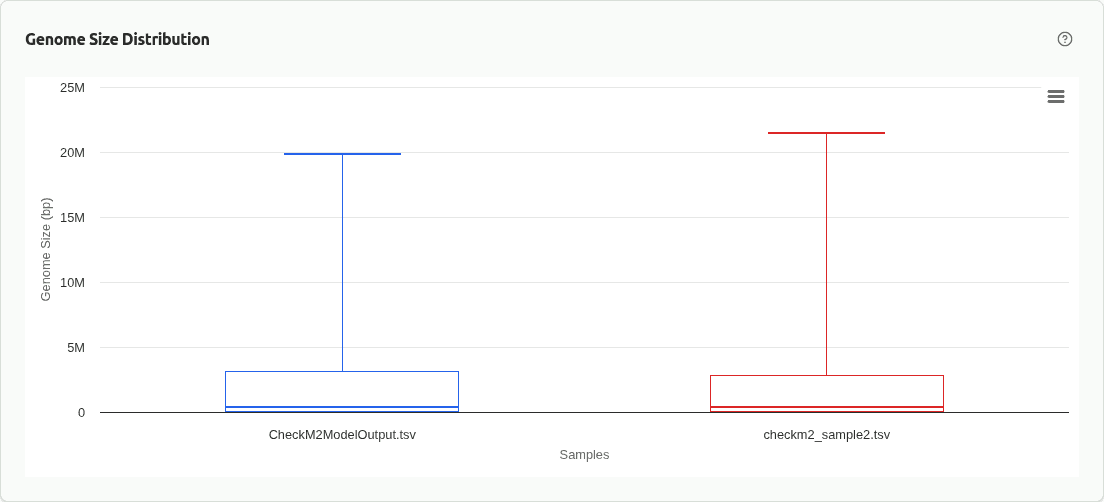
comp-genome-size
比较 VAMB 簇跨样本的基因组大小(总碱基对)分布的箱线图或分组柱状图。差异可能反映不同的群落复杂性或共组装深度。
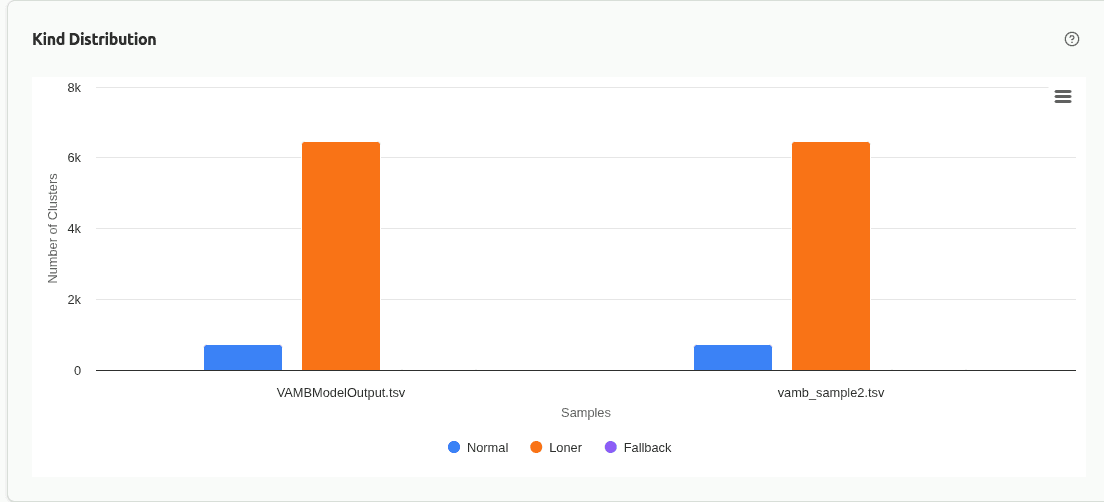
comp-kind-distribution
比较跨样本的正常、孤立和备用簇比例的堆叠或分组柱状图。正常簇比例更高表示潜在空间分离更好和分箱更可靠。
comp-quality-pct
显示每个样本的高/中/低质量簇比例的 100% 堆叠柱状图。按簇计数标准化,实现分箱质量的直接比较。在 CAMI 挑战基准测试中标准。
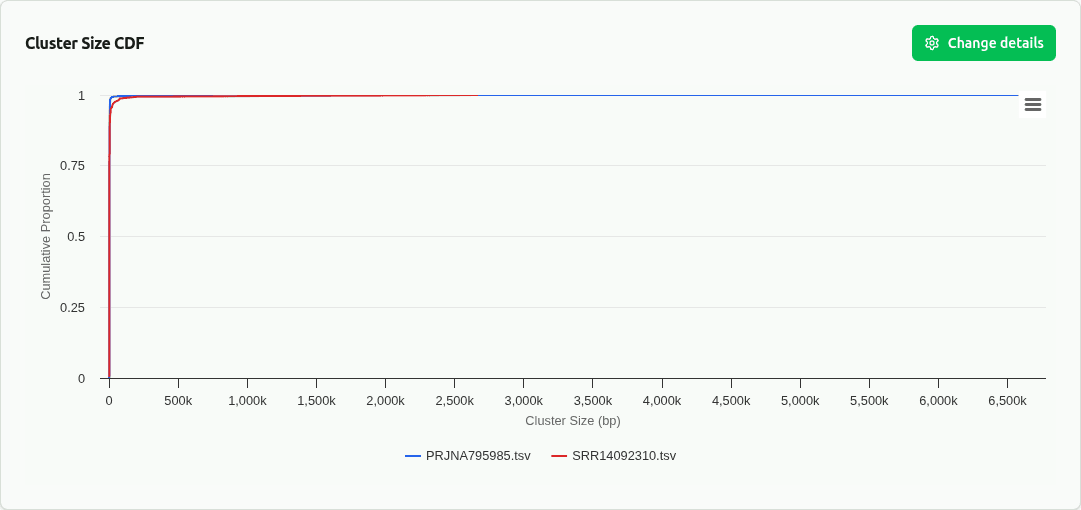
comp-cdf
簇大小的经验累积分布函数(CDF)按样本叠加。超越箱线图摘要揭示完整分布形状。在 CAMI 基准测试中标准。
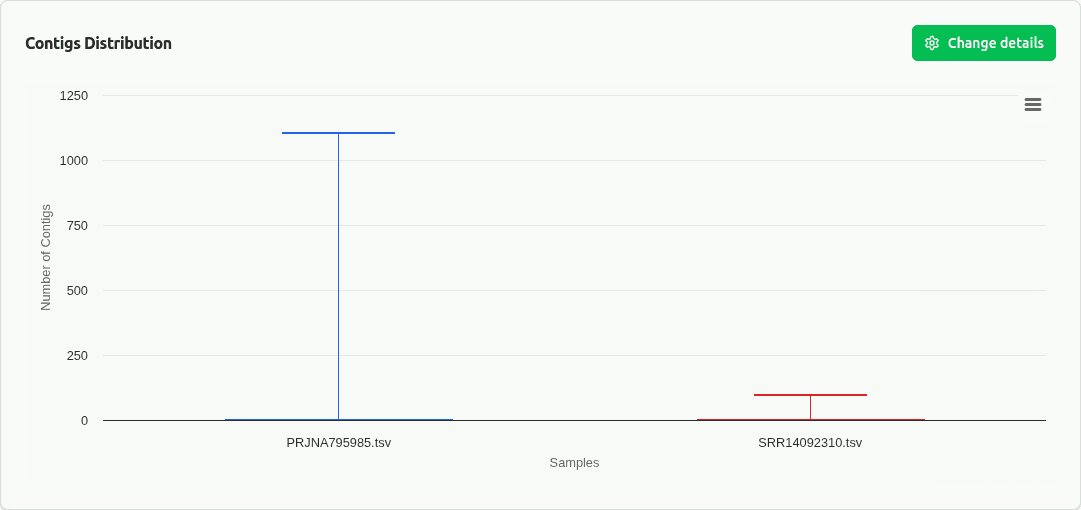
comp-contigs
跨样本每个簇的重叠群计数箱线图。较高的重叠群计数表示更破碎的组装,可能来自更低的测序深度或复杂的群落组成。
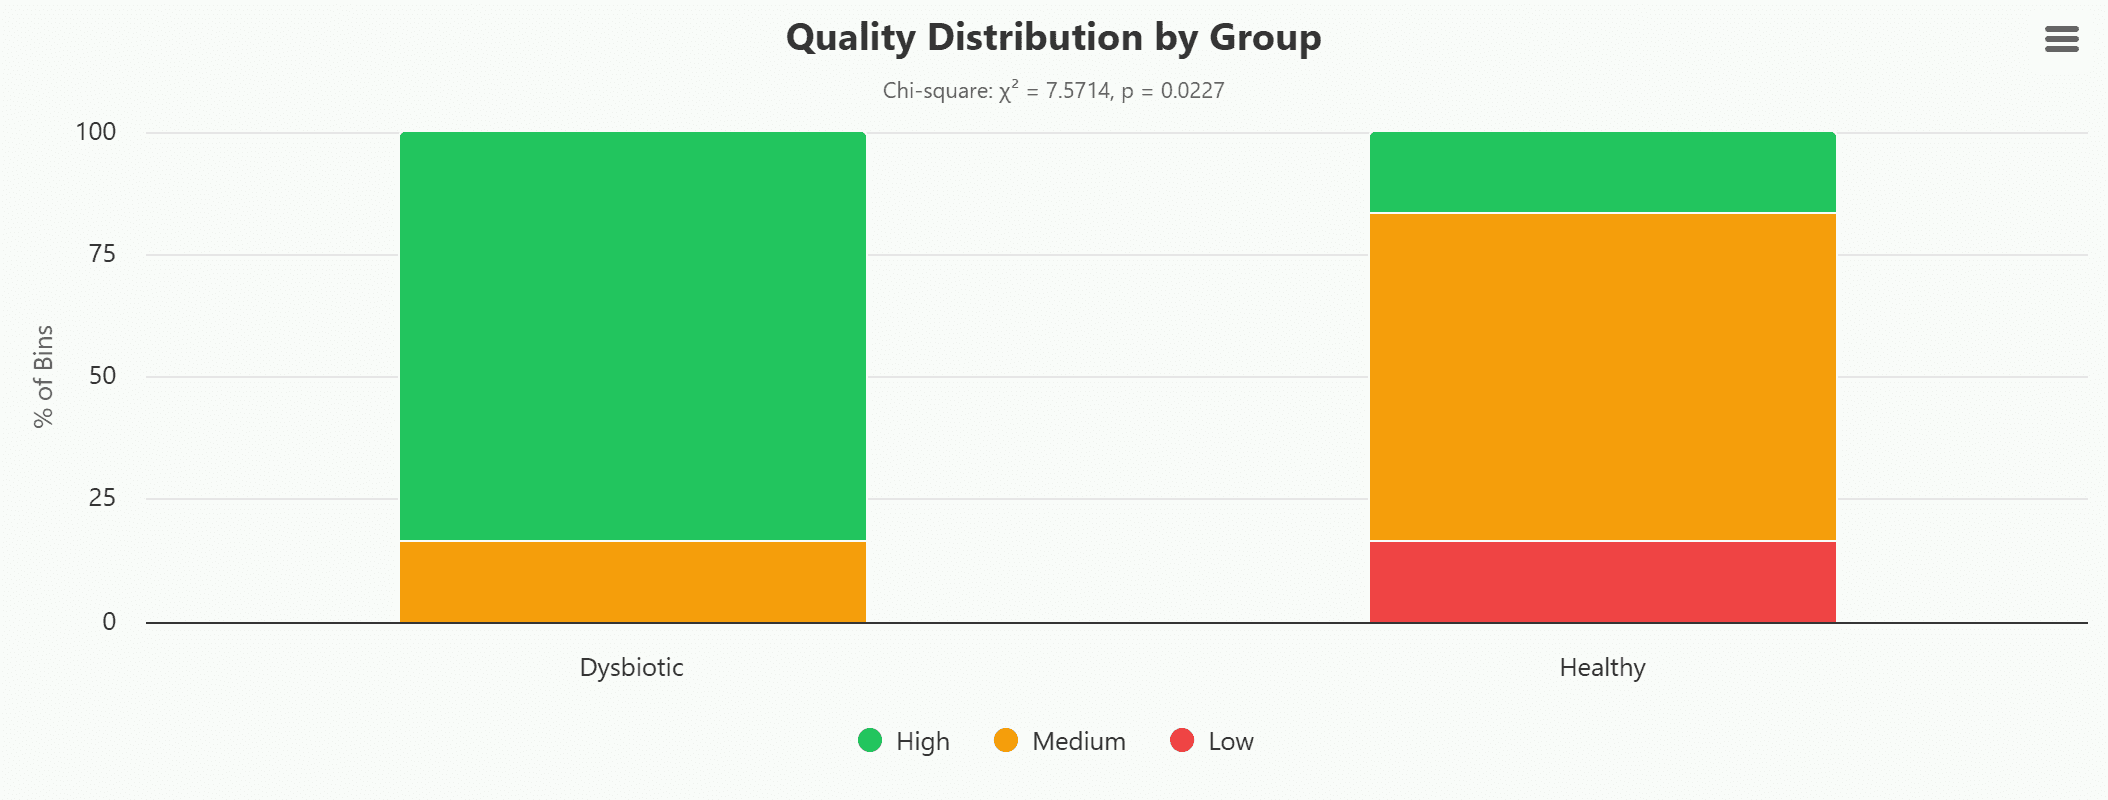
binning-group-quality-tiers
每个实验组的启发式质量等级计数(高/中/低)分组柱状图,进行卡方检验。等级基于簇类型和基因组大小:高 = 正常 + ≥500 Kbp,中 = 正常 ≥100 Kbp 或备用 ≥500 Kbp,低 = 其他所有。注:这些是组装指标启发式,不是 MIMAG 分类—— VAMB 不输出完整度或污染度。
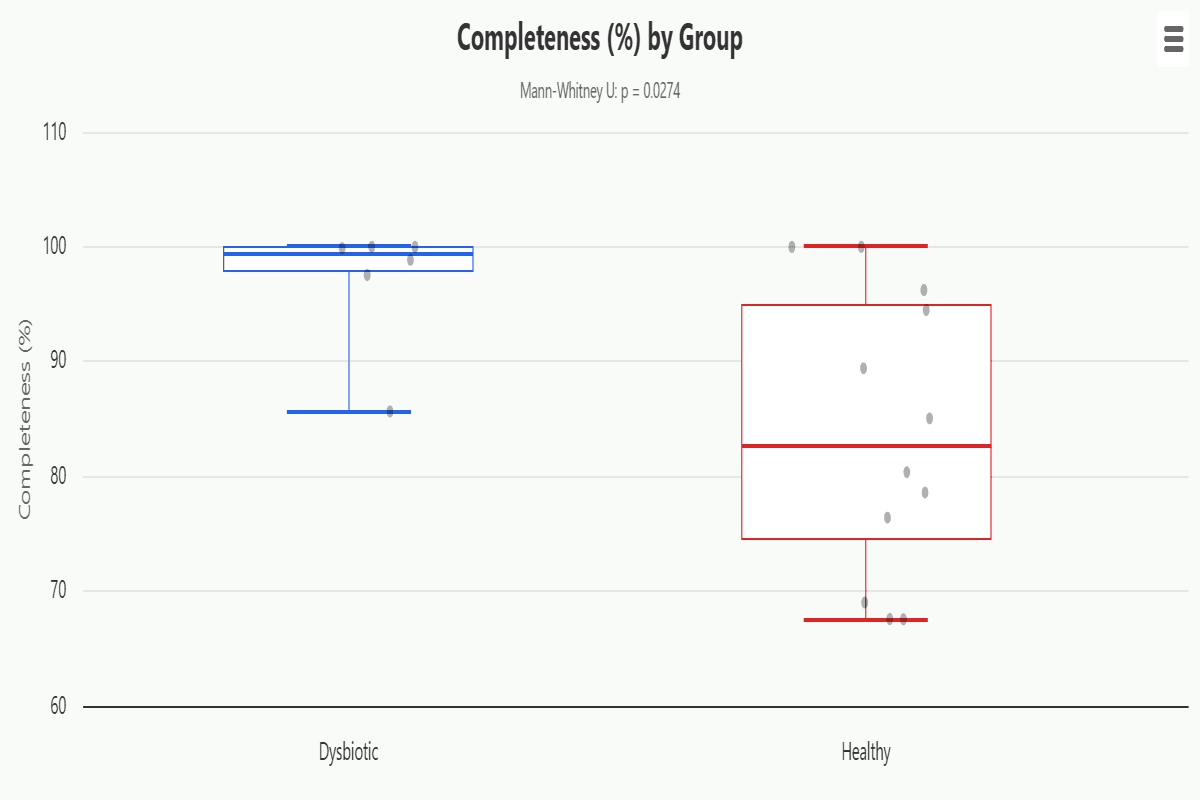
binning-group-metric-boxplots
跨组比较所选指标(基因组大小、重叠群计数、半径或峰谷比)的箱线图。所有单个簇值按组汇集。Kruskal-Wallis 检验(≥3 组)或 Mann-Whitney U 检验(2 组)评估显著性;成对比较使用 Benjamini-Hochberg FDR 校正。
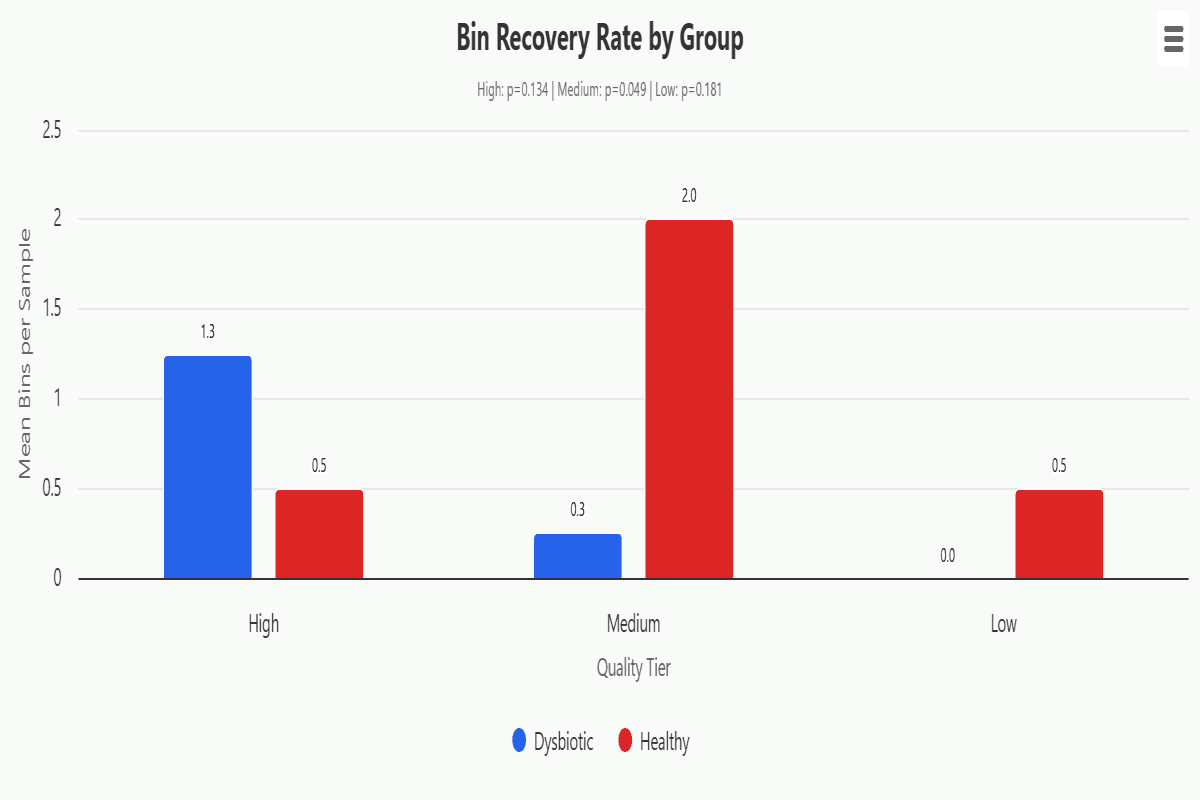
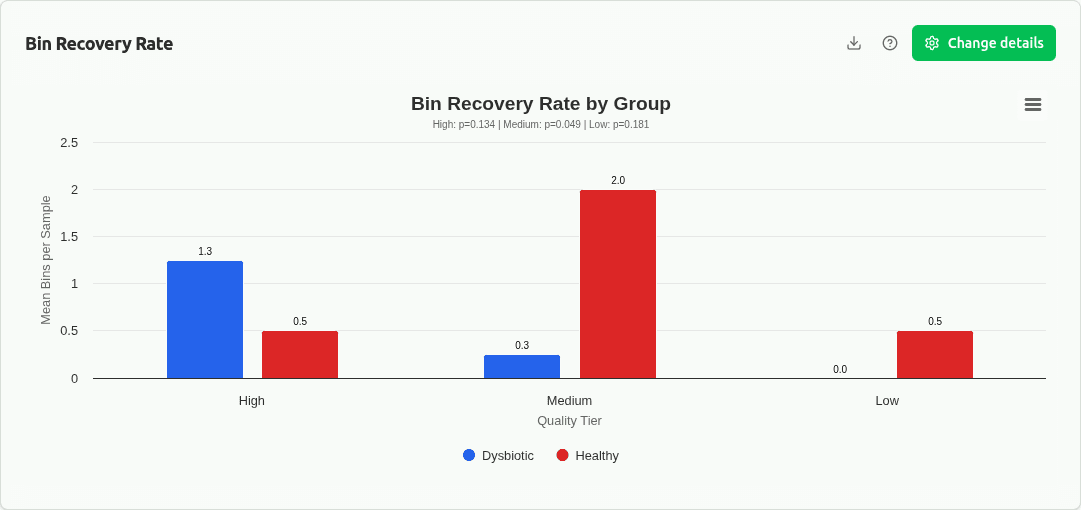
binning-group-recovery-rate
显示每个样本在跨组各质量等级(高、中、低、总计)的平均簇计数的分组柱状图,带 ±1 SD 误差棒。测试实验组是否在每个质量级别的 VAMB 簇恢复数量上有所不同。
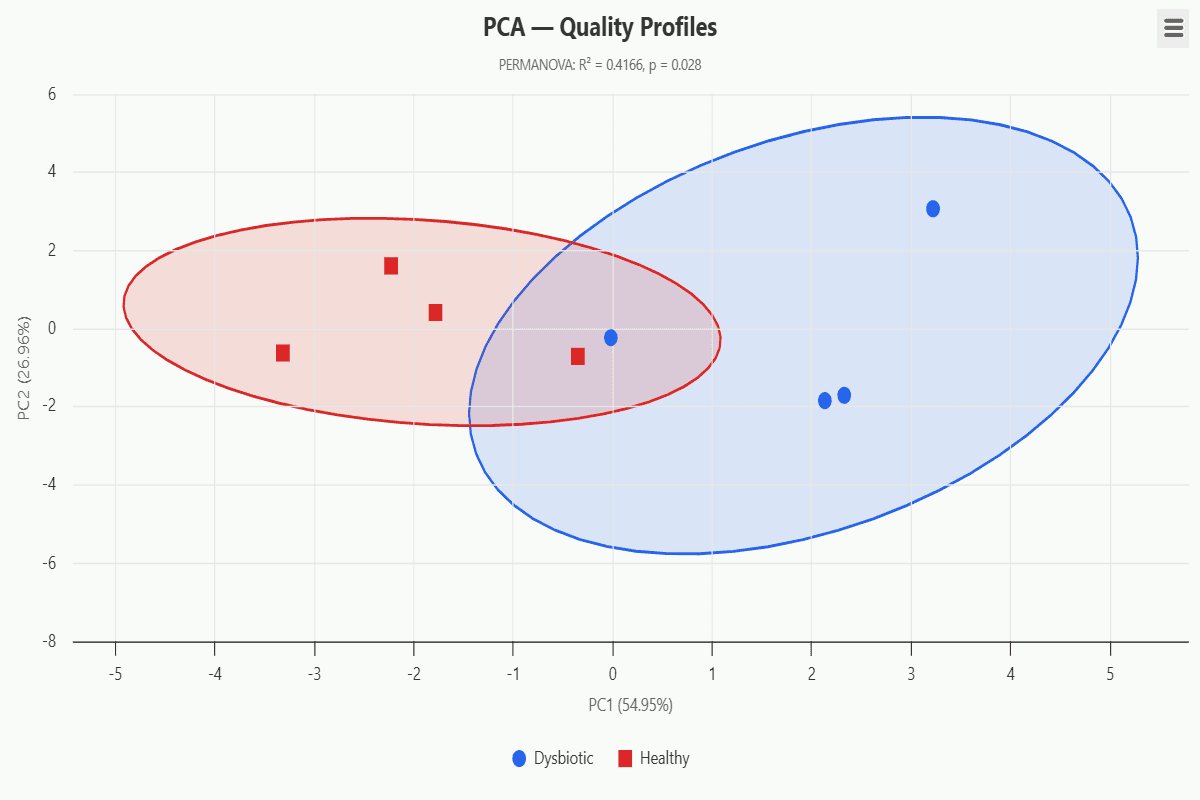
binning-group-pca
每个样本质量文件(平均基因组大小、重叠群计数、半径、峰谷比、%正常、%孤立、%备用、%高质量)的 PCA 排序。特征在分解前进行 z 分数标准化。PERMANOVA 在欧几里得距离矩阵上测试组重心是否显著不同。为具有 ≥3 个样本的组绘制 95% 置信椭圆。
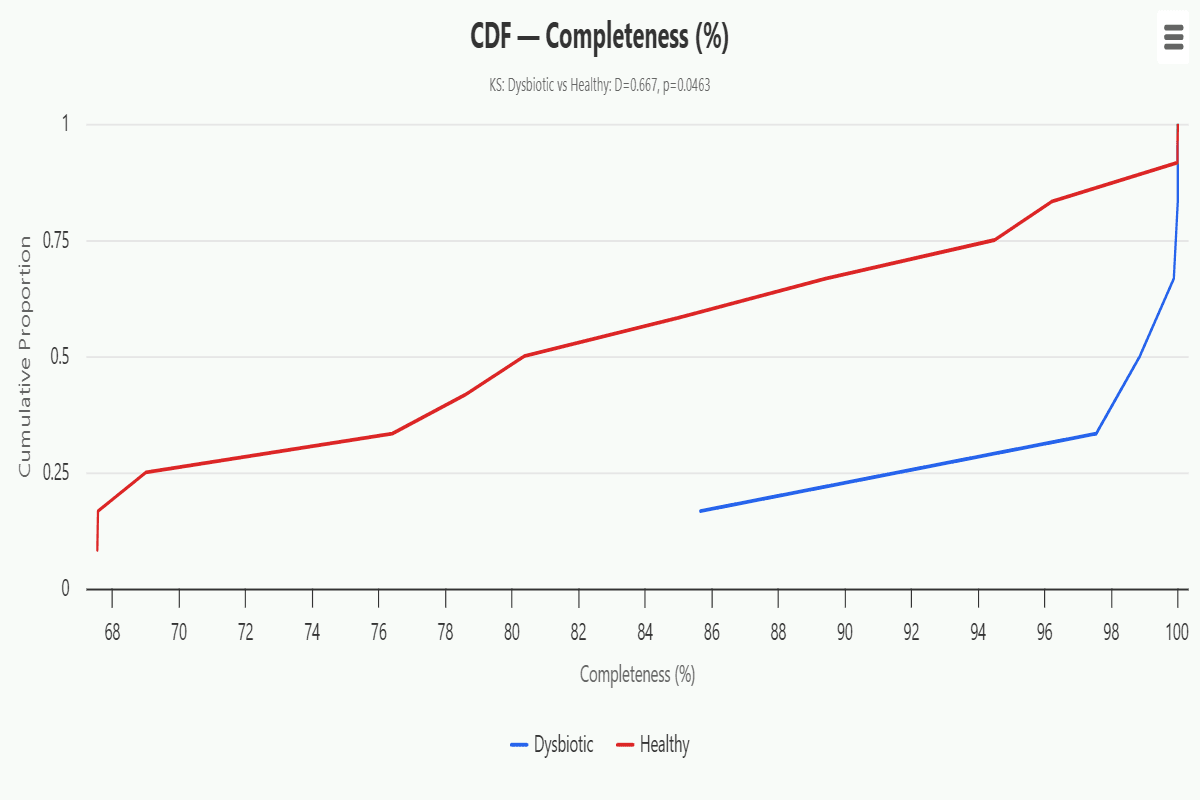
binning-group-cdf
所选指标跨组的经验累积分布函数(CDF)叠加。两样本 Kolmogorov-Smirnov 检验量化曲线间的最大垂直距离—— D 统计量显著表示组的指标分布在位置、分散或形状上有所不同。
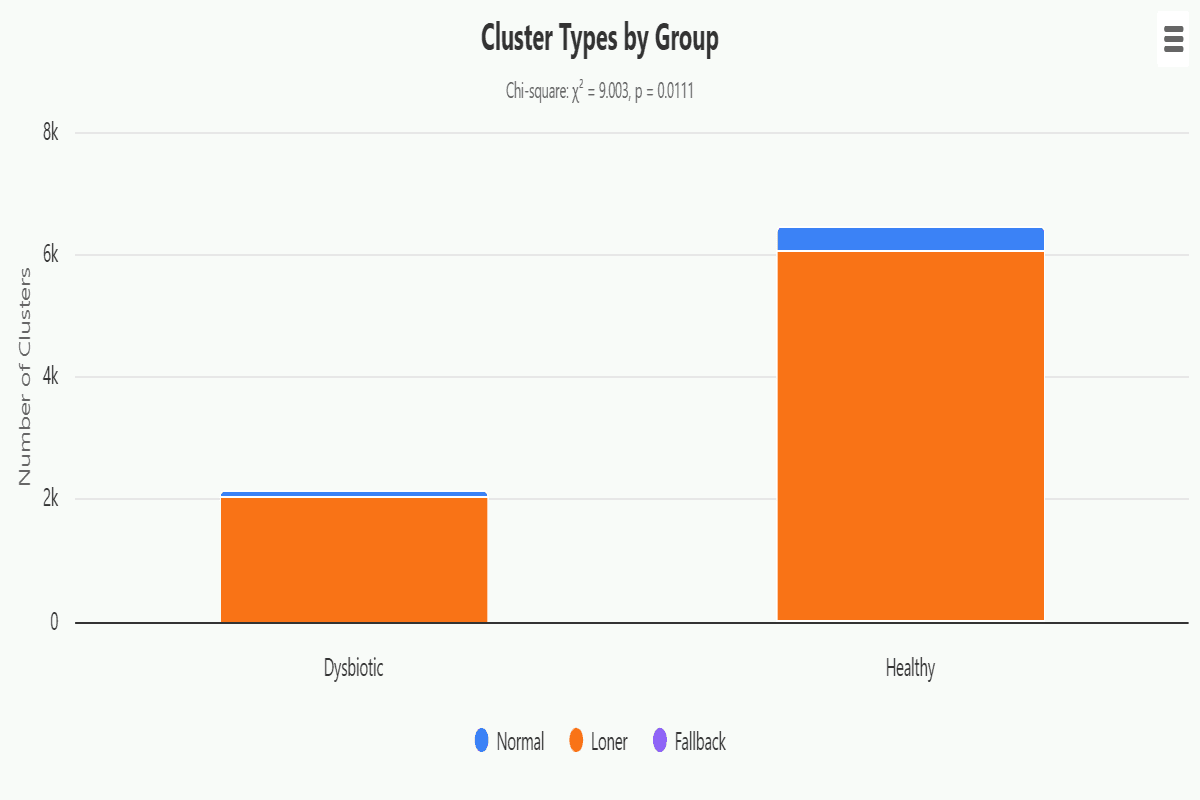
binning-group-cluster-types
簇类型计数(正常/孤立/备用)按组堆叠柱状图,进行卡方检验。这三个簇类型由 VAMB 的 潜在空间密度峰值聚类定义。显著的 p 值表示实验条件影响分离良好与分离度差的簇的比例。
binning-group-total-recovery
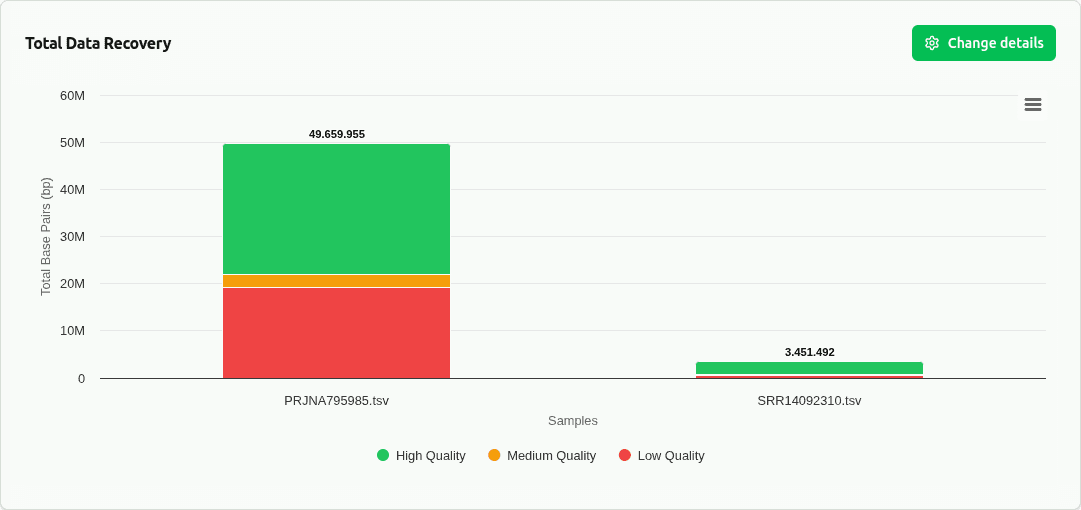
每组按质量等级拆分的平均总碱基对恢复数的堆叠柱状图。误差棒显示 ±1 SD。测量每组分箱的实际数据量,补充簇计数和恢复率图。