SemiBin2
宏基因组分箱SemiBin2 是一种用于宏基因组分箱的自监督深度学习方法。它使用对比学习和数据增强来训练样本特异性模型,无需参考基因组,即使在新环境中也能实现准确分箱。 [1]
如何获取输出模型文件
以下是团队运行的简要工作流,用于获取我们在工具页面上呈现的输出模型示例。
输入
组装的 contig(FASTA)+ 排序的 BAM 比对文件
输出
FASTA bins(.fa.gz)+ TSV 摘要,包含每个 bin 的指标:文件名、总 bp 数、contig 计数、N50、L50
conda install -c bioconda semibin
Docker 镜像: quay.io/biocontainers/semibin:2.2.1--pyhdfd78af_0
样本 1 肠道微生物组(来自 PRJNA795985 的 3 个样本,各 100 万 read 对)与 组装 共同组装,并使用 SemiBin2 v2.2.1 以自监督模式进行分箱,产生 38 个 bin。
- 1
从 PRJNA795985 下载 3 个样本
for SRR in SRR17531757 SRR17531762 SRR17531772; do fastq-dump --split-files --gzip -X 1000000 --outdir reads/ $SRR; done
与 VAMB 相同的共同组装——重复使用相同的 reads。每个样本下载 100 万 read 对(各约 70 MB 压缩)。
- 2
使用 MEGAHIT 共同组装所有样本
megahit -1 reads/SRR17531757_1.fastq.gz,reads/SRR17531762_1.fastq.gz,reads/SRR17531772_1.fastq.gz -2 reads/SRR17531757_2.fastq.gz,reads/SRR17531762_2.fastq.gz,reads/SRR17531772_2.fastq.gz -o assembly --min-contig-len 1500 -t 8 --presets meta-sensitive
产生 14,934 个 contig(≥1,500 bp)。如果已为 VAMB 完成,重复使用相同的组装。
- 3
将每个样本映射到 contig
for SRR in SRR17531757 SRR17531762 SRR17531772; do minimap2 -ax sr -t 8 assembly/final.contigs.fa reads/${SRR}_1.fastq.gz reads/${SRR}_2.fastq.gz | samtools sort -@ 4 -o bams/${SRR}.sorted.bam && samtools index bams/${SRR}.sorted.bam; done - 4
运行 SemiBin2 自监督分箱
SemiBin2 single_easy_bin -i assembly/final.contigs.fa -b bams/SRR17531757.sorted.bam bams/SRR17531762.sorted.bam bams/SRR17531772.sorted.bam -o semibin2_out --self-supervised -m 1500 -t 8
使用 single_easy_bin 和多个 BAM 进行共丰度。自监督模式训练样本特异性模型(CPU 上约 38 分钟)。经过基于 HMM 的重新聚类后产生 38 个 bin。
使用的材料
示例输出文件
下载工具页面演示中使用的输出文件。您可以直接上传到 IntMeta 来探索可视化。
单个和比较
分组分析
图表参考
IntMeta 中 SemiBin2 生成的所有 22 个可视化的详细描述。
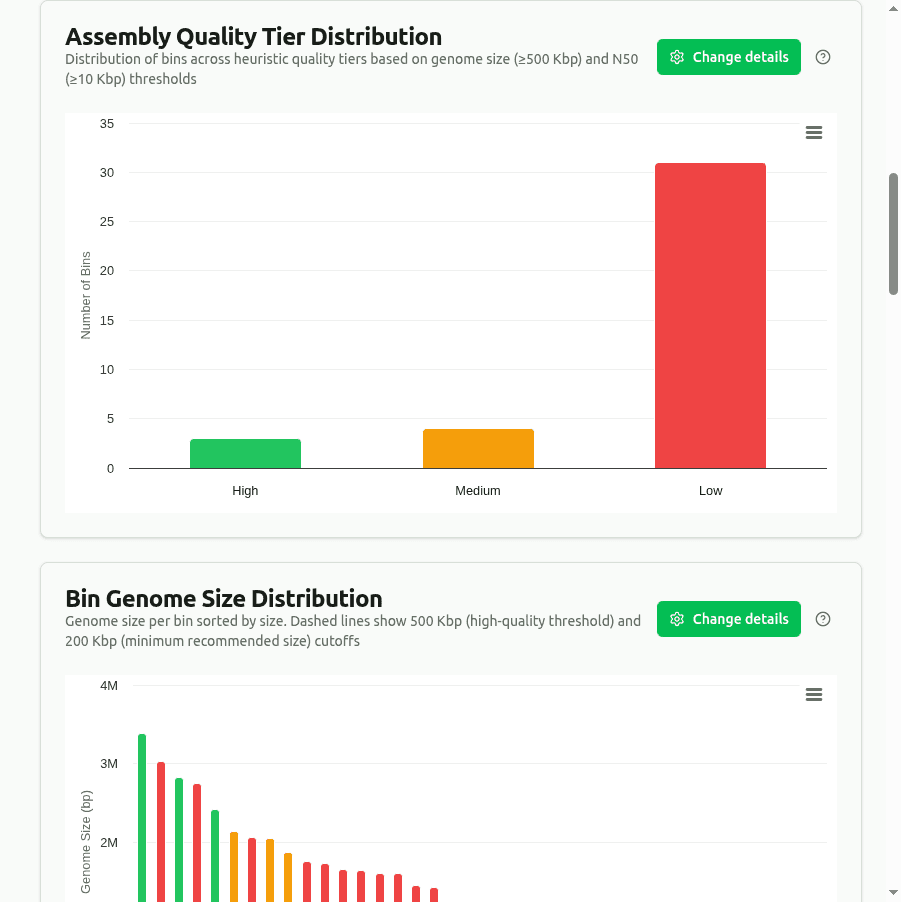
quality-tier-distribution
基于组装指标将 bin 分类为启发式质量等级的饼图:High(≥500 Kbp 基因组 + N50 ≥10 Kbp)、Medium(≥200 Kbp + N50 ≥5 Kbp)、Low(其余)。注意:这些是组装指标启发式分类,不是 MIMAG 质量等级——未评估完整度/污染度。
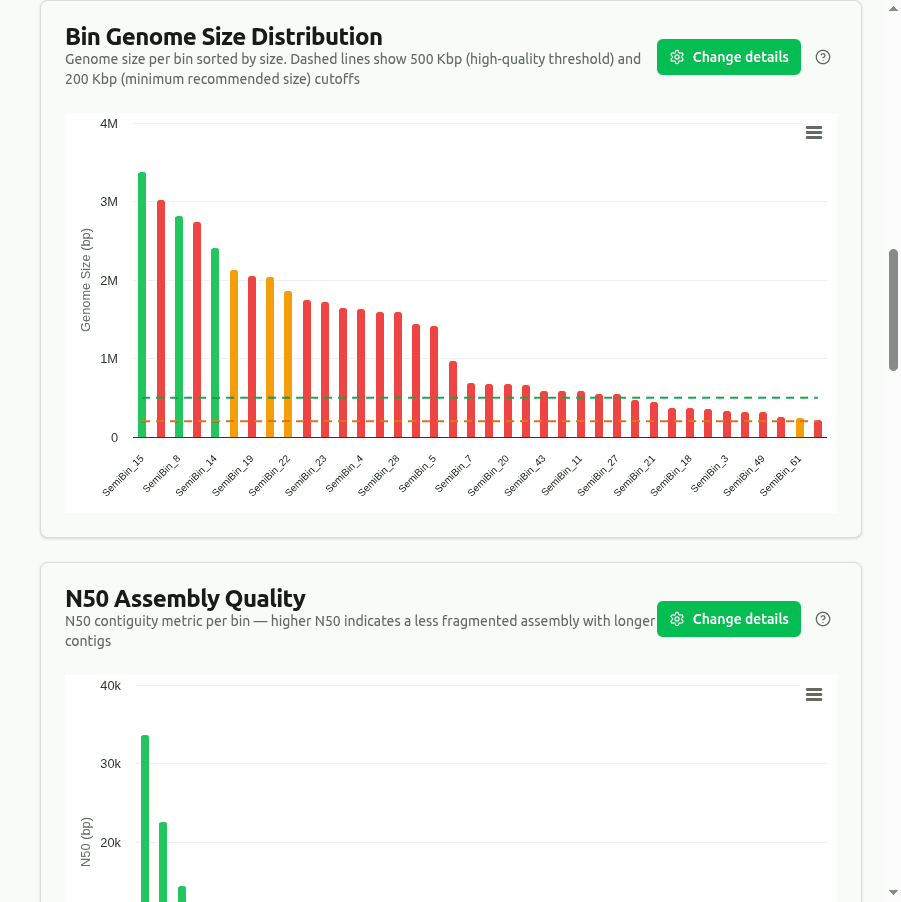
genome-size-distribution
每个 bin 的 total_bp(基因组大小)柱状图,按大小排序。500 Kbp(高质量阈值)和 200 Kbp(最小推荐大小)处的虚线参考线有助于在视觉上区分质量等级。
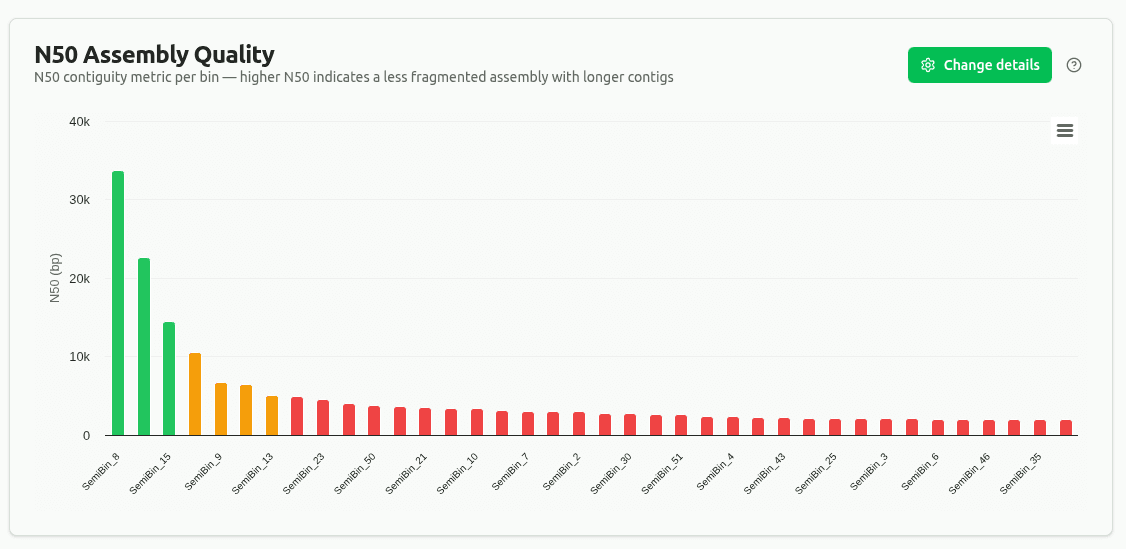
n50-assembly-quality
每个 bin 的 N50 连贯性指标柱状图——bin 总碱基对的一半位于此长度或更长的 contig 中。N50 越高表示 contig 越少、越长,碎片化越少。按质量等级着色。
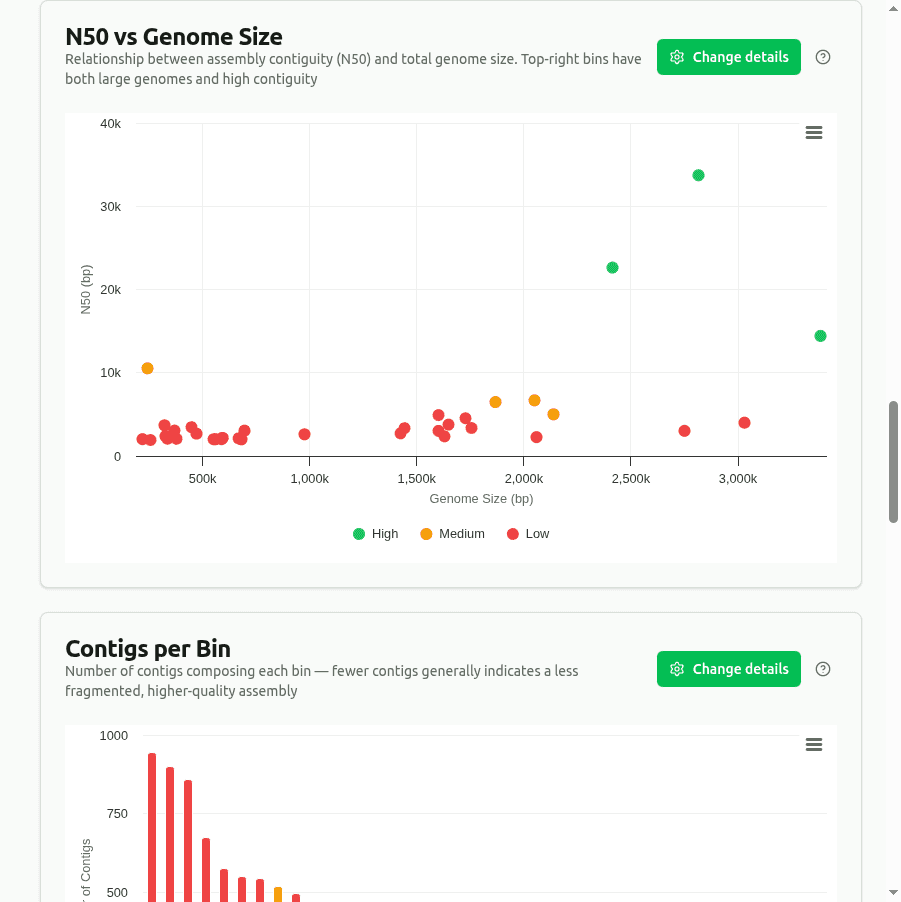
n50-vs-genome-size
散点图,X 轴 = total_bp(基因组大小)、Y 轴 = N50,按质量等级着色。右上方的 bin 既有大基因组又有高连贯性——是基因注释等下游分析的最佳候选。
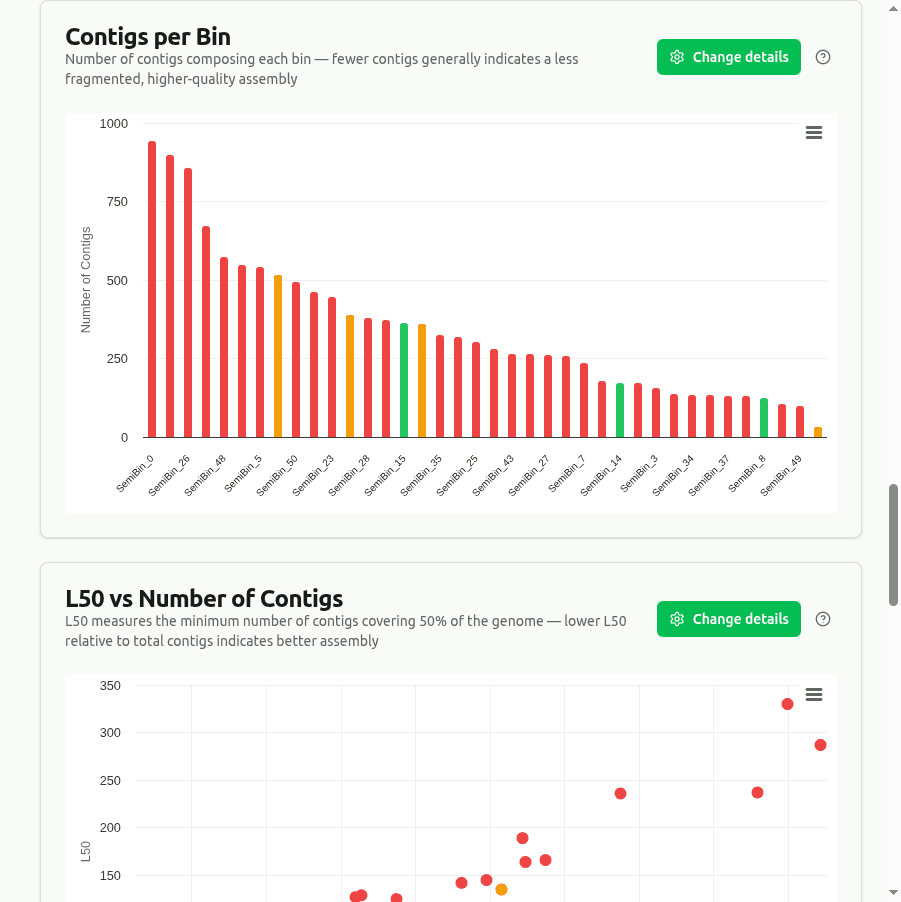
contigs-per-bin
每个 bin 的 num_contigs 柱状图,按质量等级着色。contig 越少通常表示碎片化程度越低、组装质量越高。contig 计数非常高的 bin 可能需要进一步优化。
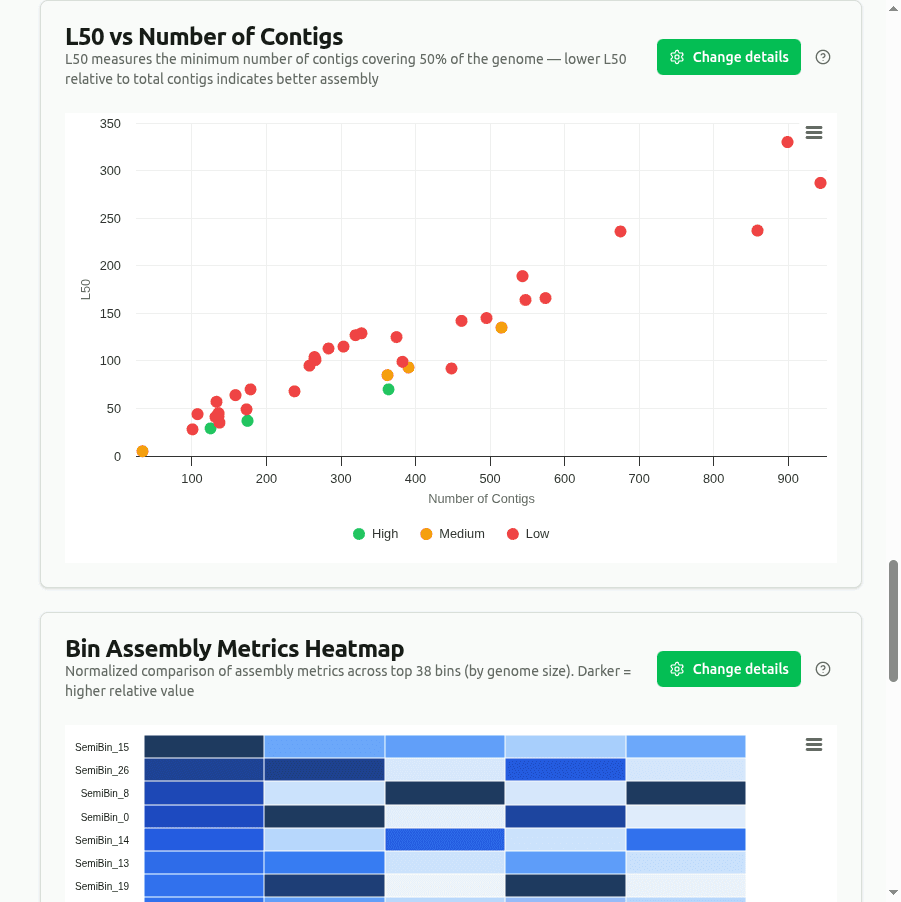
l50-vs-contigs
L50(覆盖 bin 基因组 50% 所需的最少 contig 数)与总 num_contigs 的散点图。L50 相对于总 contig 数越低意味着组装由少数几个长 contig 主导——连贯性越好。
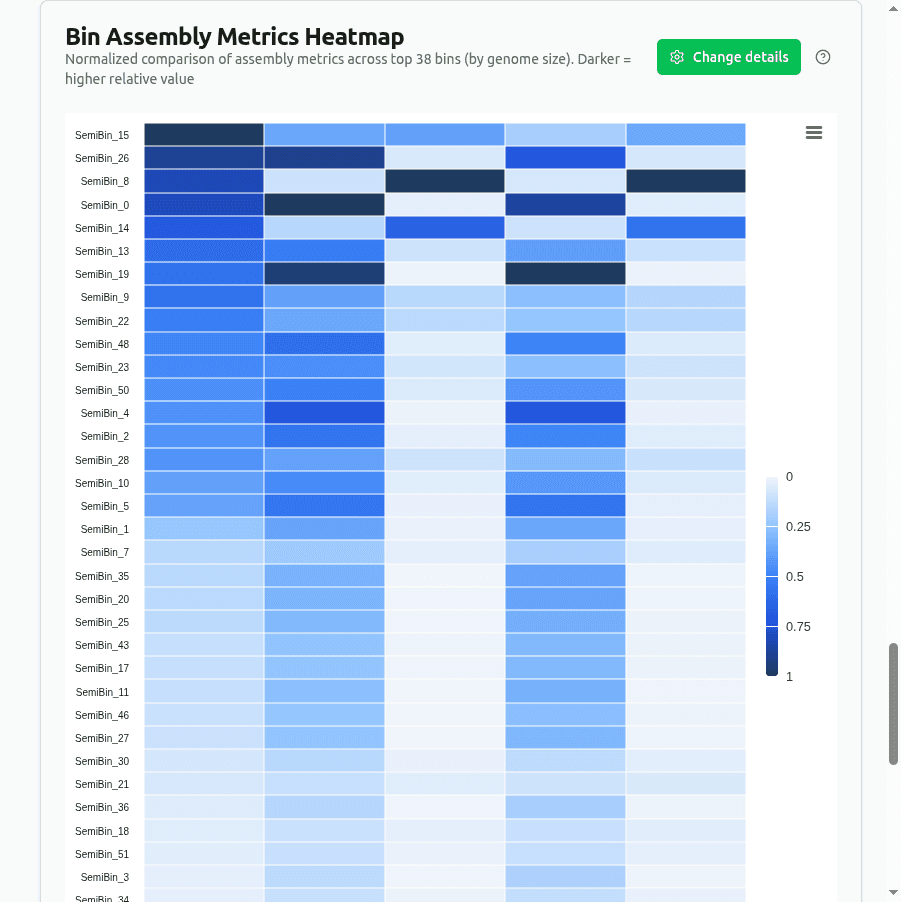
assembly-metrics-heatmap
跨顶部 bin 的最小-最大归一化组装指标(total_bp、num_contigs、N50、L50、平均 contig 长度)的热图。每个指标在其列内缩放为 0–1;更深的单元格 = 更高的相对值。快速质量概览。
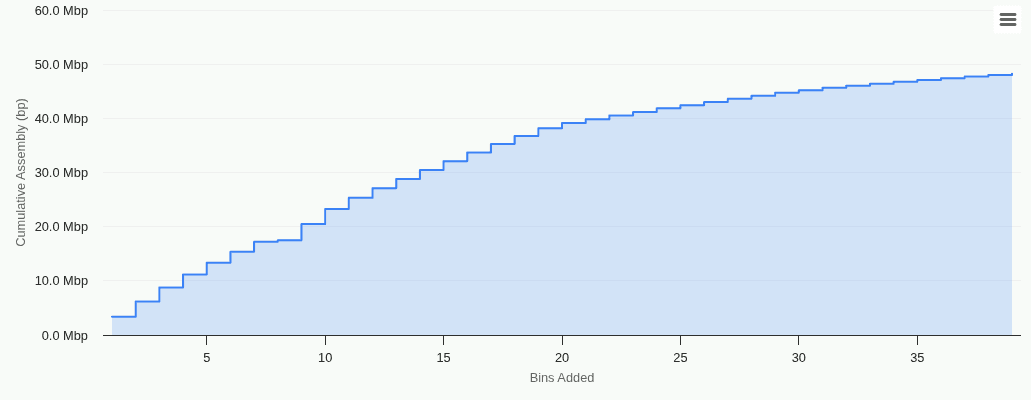
cumulative-genome-recovery
按质量等级(降序)排序的 bin 的累积阶梯面积图。Y 轴显示基因组大小的累积总数(bp)。陡峭的初始上升表示大多数组装序列来自高质量 bin。
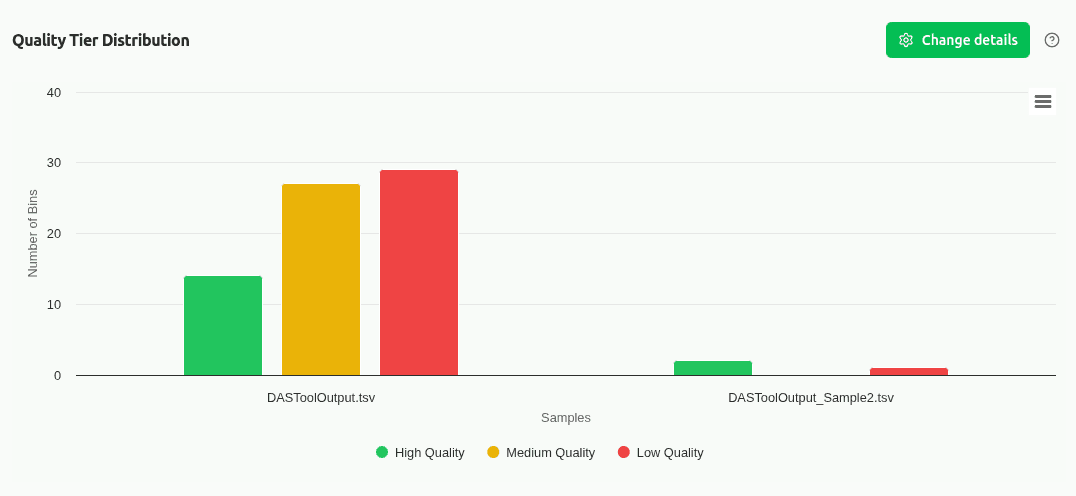
comp-quality-tiers
比较样本间启发式质量等级分布(基于基因组大小和 N50 阈值的 High / Medium / Low)的分组柱状图。显示哪个样本产生了更多高质量的 SemiBin2 bin。
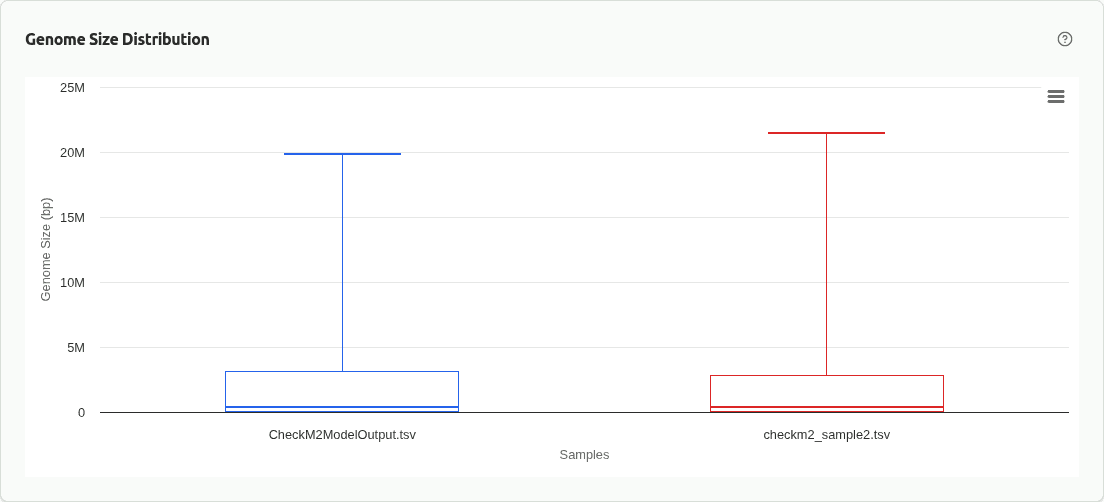
comp-genome-size
比较样本间 SemiBin2 bin 基因组大小(total_bp)分布的箱线图或分组柱状图。有助于检测样本间 MAG 恢复的系统差异。
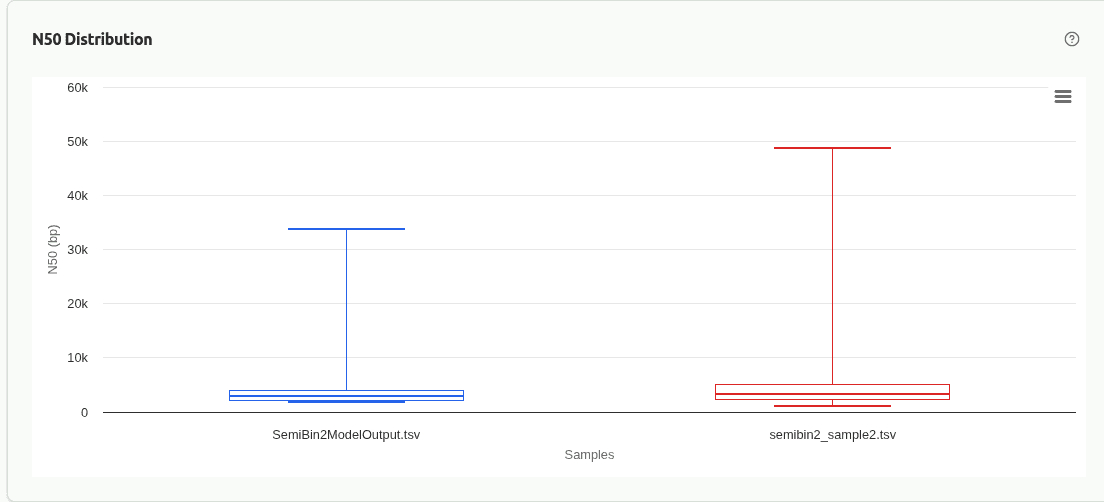
comp-n50-distribution
比较样本间 N50 连贯性指标的箱线图或柱状图。N50 值越高表示碎片化越少——具有持续高 N50 bin 的样本表明测序深度更好或群落组成更简单。
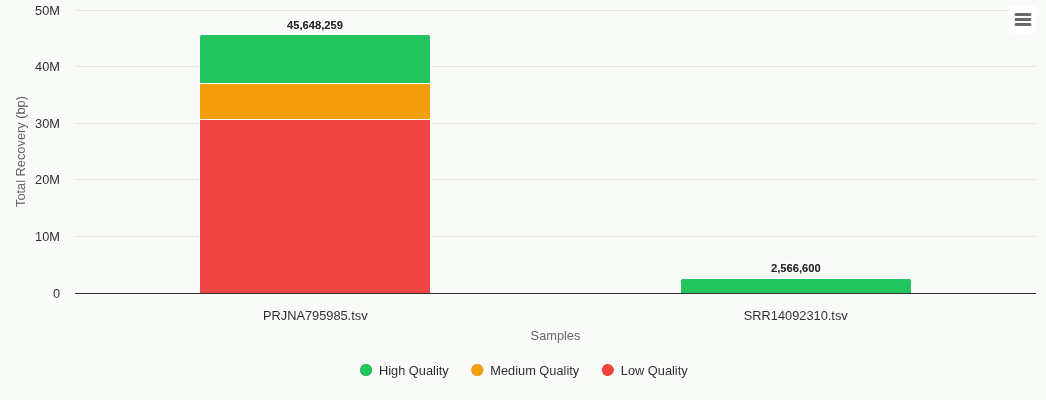
comp-quality-pct
100% 堆叠柱状图,显示每个样本中 High / Medium / Low 质量 bin 的比例。对不同 bin 计数进行归一化,实现分箱质量的直接比较。这是 CAMI 挑战基准的标准做法。
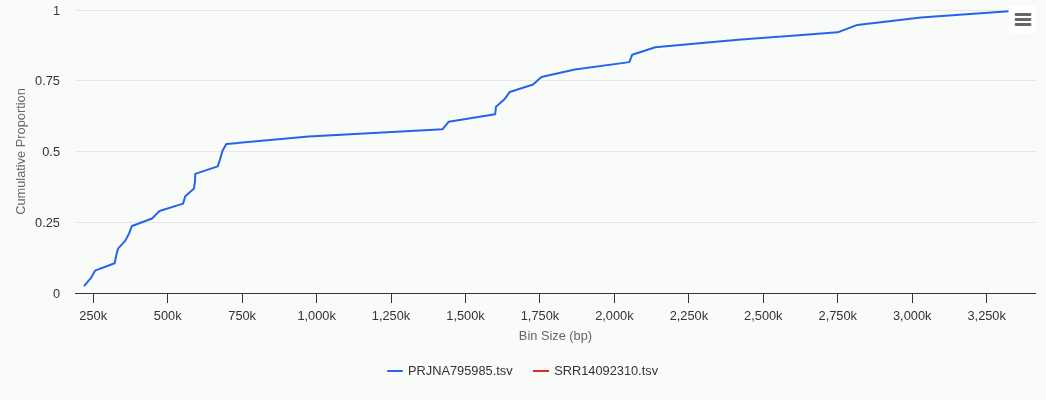
comp-cdf
每个样本的 bin 大小经验累积分布函数(CDF)叠加图。揭示超越箱线图摘要的完整分布形状。这是 CAMI 基准测试的标准。
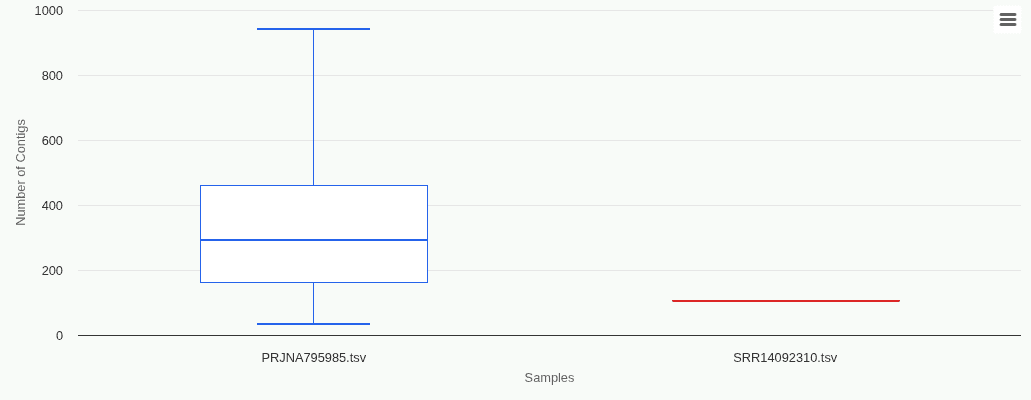
comp-contigs
样本间每个 bin 的 contig 计数箱线图。contig 计数越高表示碎片化程度越高,可能来自更低的测序深度或复杂的群落组成。
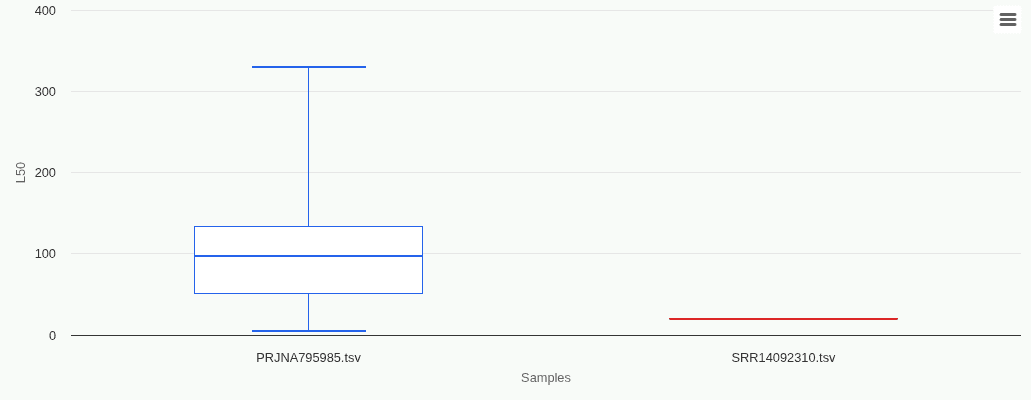
comp-l50
样本间 L50(覆盖总 bin 长度 50% 的最少 contig 数)的箱线图。与 N50 互补——L50 越低意味着 contig 越少、越大。
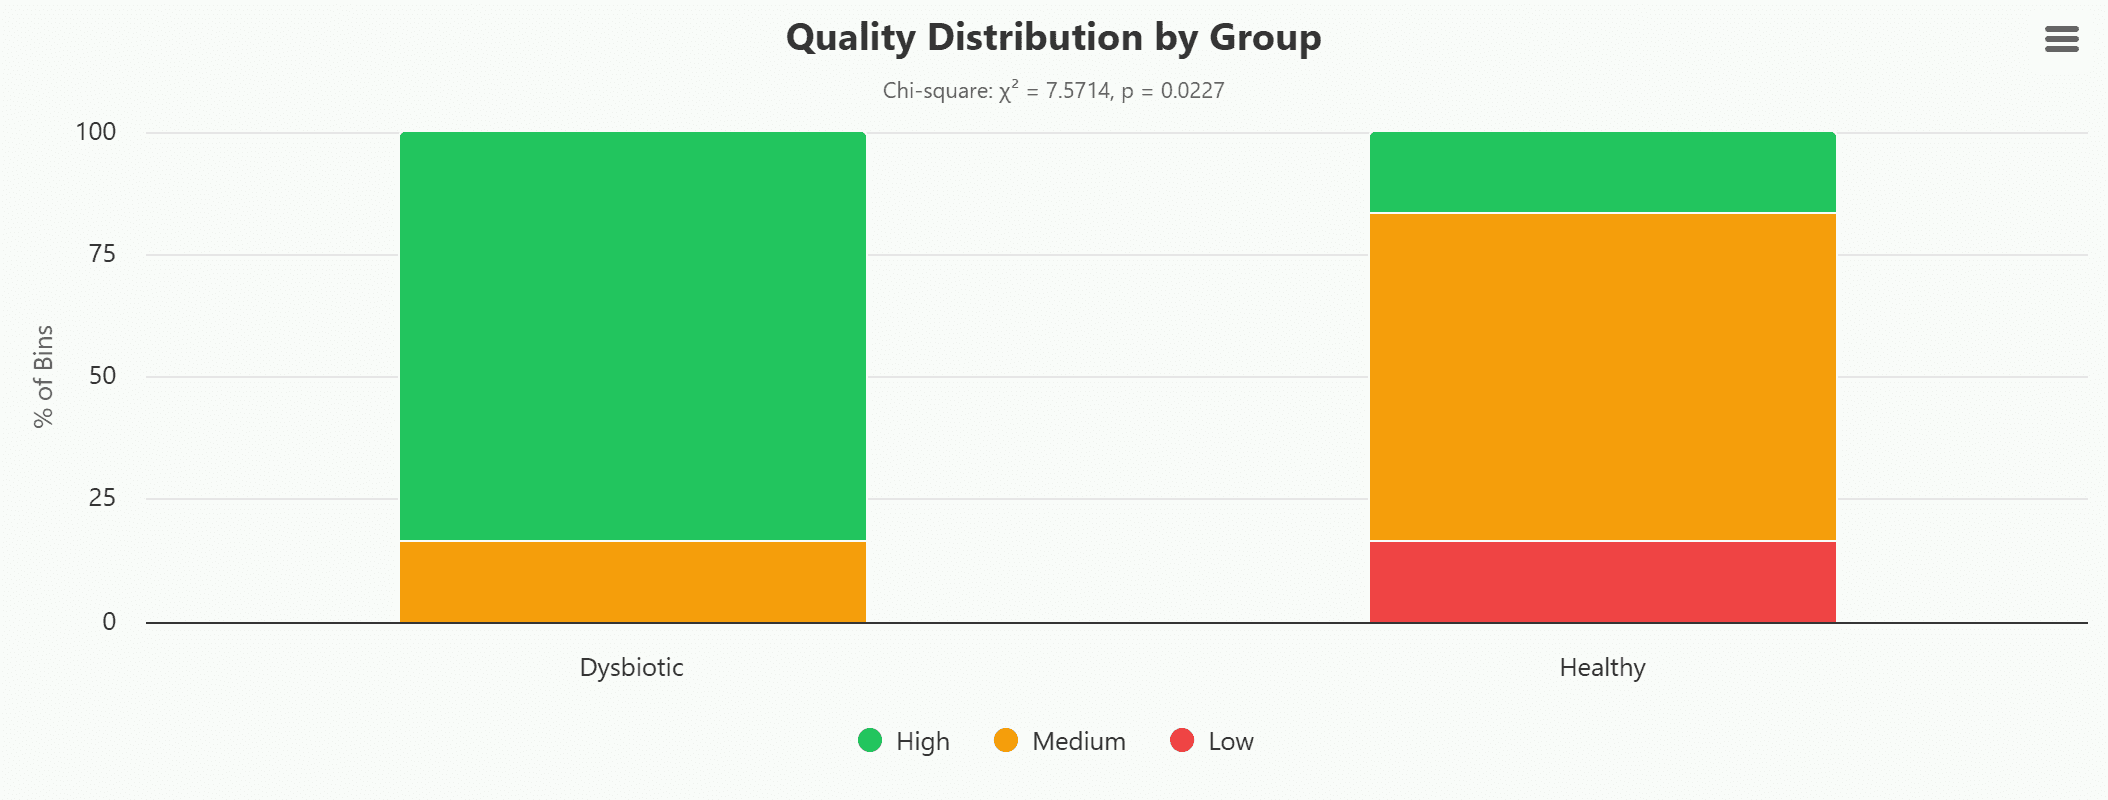
binning-group-quality-tiers
每个实验组的启发式质量等级计数(High / Medium / Low)的分组柱状图,含 Chi 平方检验。等级基于组装指标:High(≥500 Kbp 基因组 + N50 ≥10 Kbp)、Medium(≥200 Kbp + N50 ≥5 Kbp)、Low(其余)。注意:这些是组装指标启发式分类,不是 MIMAG 分类——SemiBin2 输出不包括完整度或污染度。
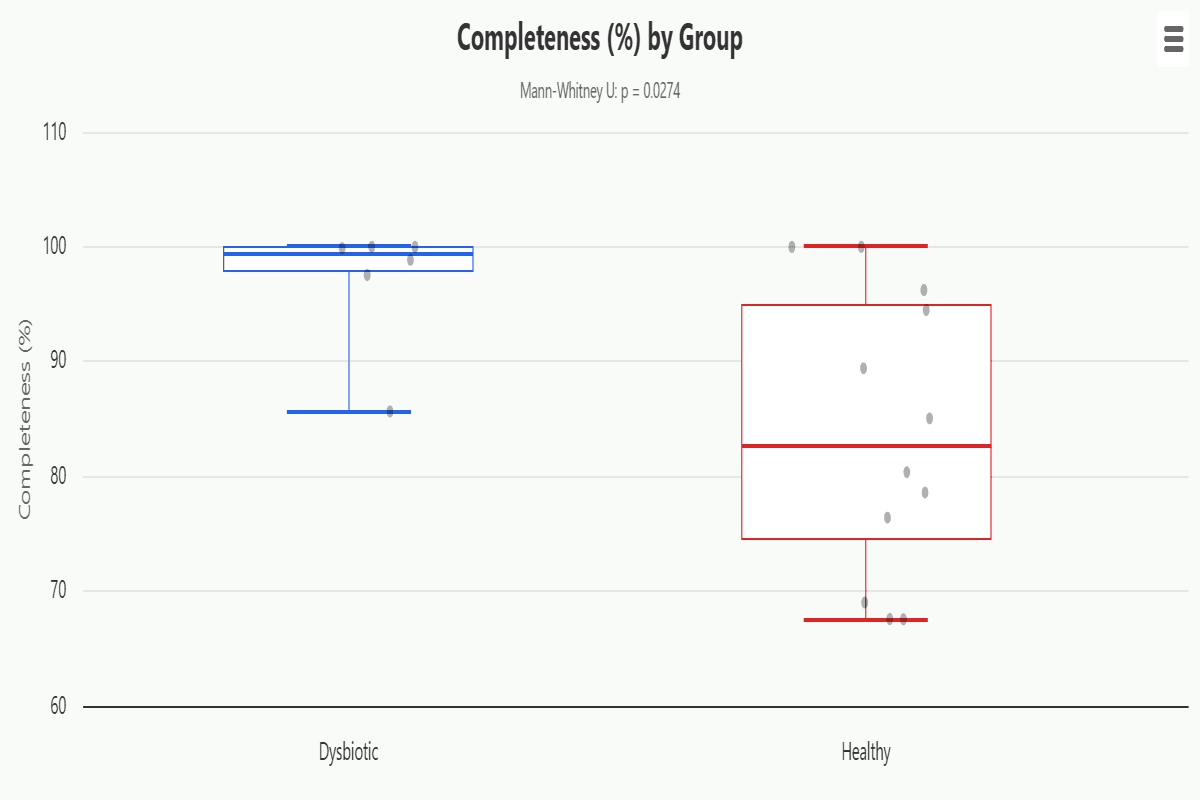
binning-group-metric-boxplots
比较各组选定指标(总 bp、N50、L50 或平均 contig 长度)的箱线图。所有单个 bin 值按组汇总。Kruskal-Wallis 检验(≥3 组)或 Mann-Whitney U 检验(2 组)评估显著性;成对比较使用 Benjamini-Hochberg FDR 修正。
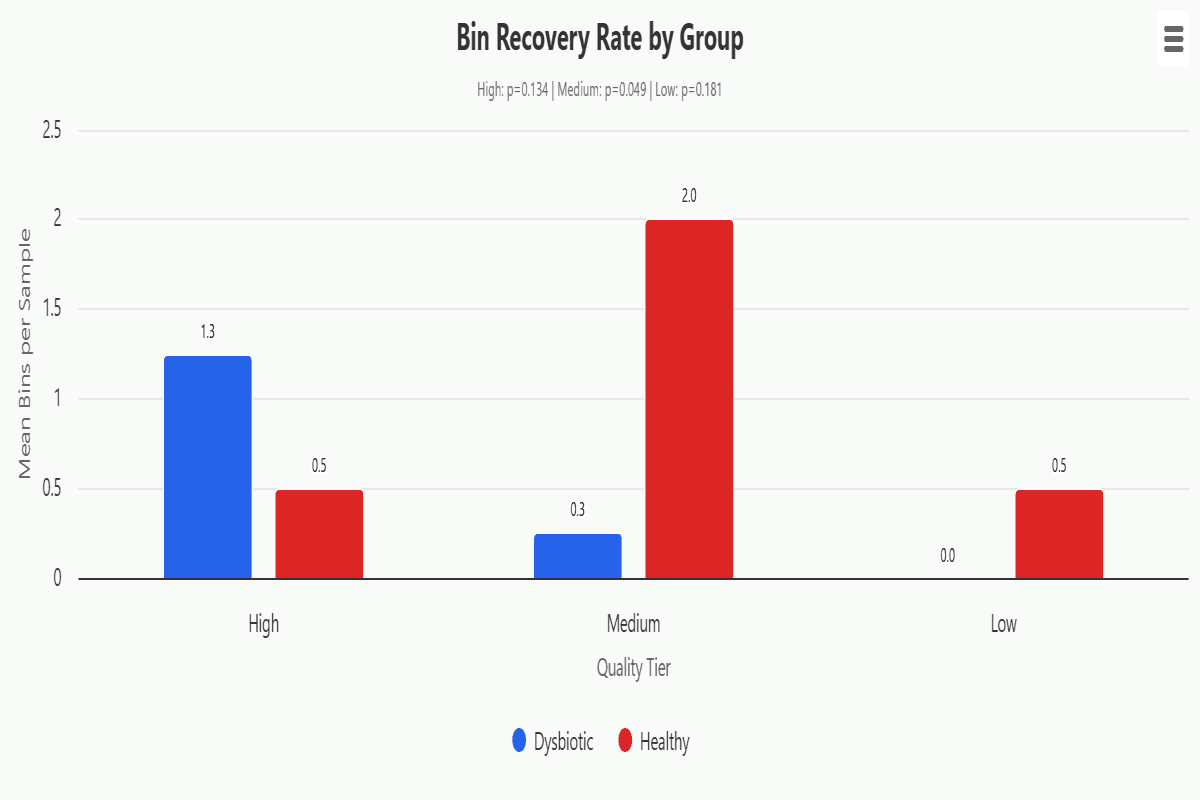
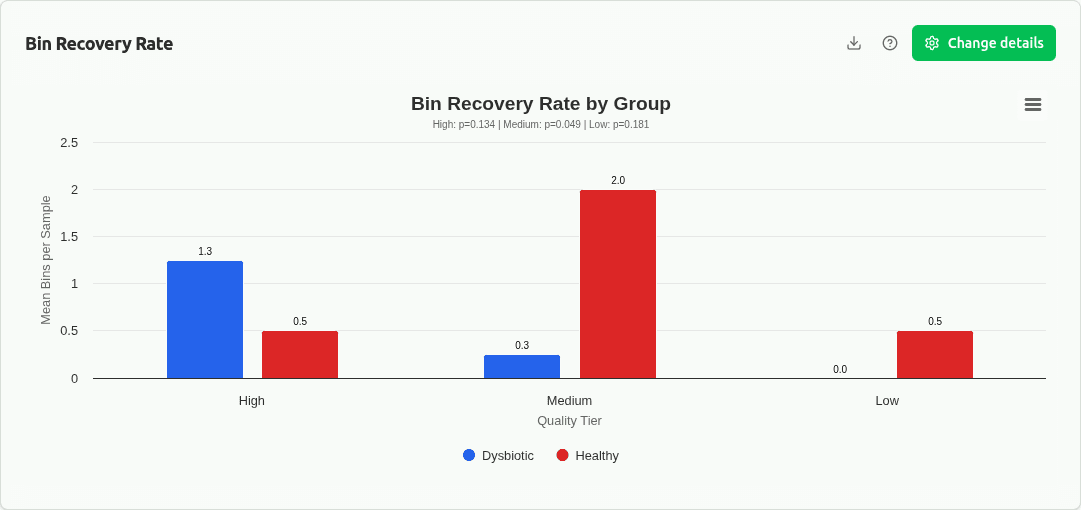
binning-group-recovery-rate
各组中每个质量等级(High、Medium、Low、Total)每样本平均 bin 计数的分组柱状图,含 ±1 SD 误差棒。检验实验组在各质量等级恢复的 SemiBin2 bin 数量是否有差异。
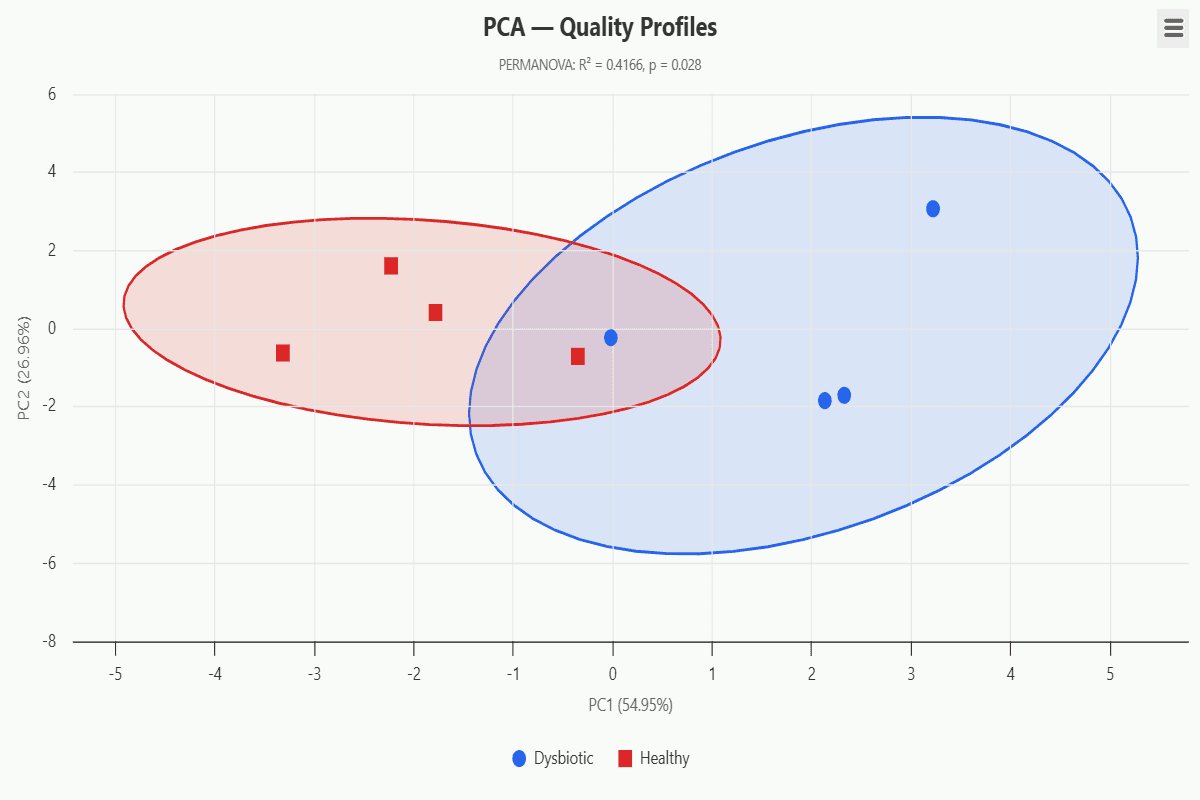
binning-group-pca
每样本质量档案(平均总 bp、N50、L50、平均 contig 长度、%HQ、%MQ)的 PCA 排序。特征在分解前进行 z 分数标准化。欧几里得距离矩阵上的 PERMANOVA 检验组中心是否有显著差异。为≥3 个样本的组绘制 95% 置信椭圆。
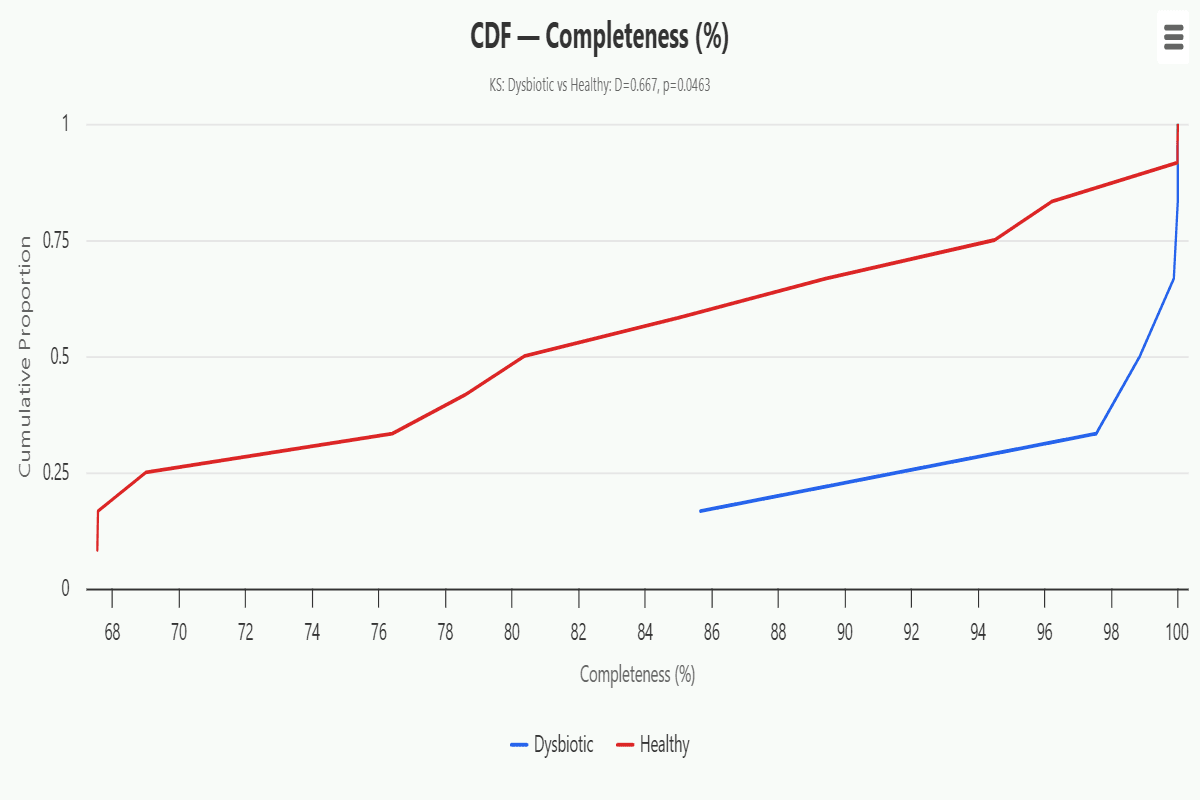
binning-group-cdf
各组选定指标的叠加经验累积分布函数(CDF)。两样本 Kolmogorov-Smirnov 检验量化曲线间的最大垂直距离——显著的 D 统计量表示各组的指标分布在位置、分散或形状上有差异。
binning-group-total-recovery
每组恢复的平均总碱基对堆叠柱状图,按质量等级分开。误差棒显示 ±1 SD。衡量每组的实际分箱数据量,补充 bin 计数和恢复率图表。