微生物组群落分析
群落分析对微生物组普查数据的群落分析——包括一张 OTU/ASV 丰度表、一张分类表和一张样本元数据表——用于群落组成、α 与 β 多样性、排序及共现分析。这三张表是任意扩增子或宏基因组流程(QIIME 2、DADA2、mothur、USEARCH/VSEARCH、MetaPhlAn)的标准输出;从你实际运行的那个流程中导出即可。 [1]
如何获取输出模型文件
以下是团队运行的简要工作流,用于获取我们在工具页面上呈现的输出模型示例。
输入
一张 OTU/ASV 特征表 + 一张分类表 + 一张样本元数据表(CSV/TSV)——从 QIIME 2、DADA2、mothur 或任意流程导出;例如内置的 CARBOM 示例(18S 宏条形码,205 个分类单元 × 54 个样本)
输出
上传到 IntMeta 的三张 CSV/TSV 表——一张 OTU/ASV 丰度表(分类单元 × 样本)、一张分类表(分类单元 id + 诸如 Domain … Genus 的分类等级)以及一张样本元数据表(样本 + 变量)
conda install -c bioconda bioconductor-phyloseq
从你的 QIIME 2 制品(.qza)导出特征表和分类,并将特征表转换为 TSV。你在 QIIME 2 中已使用的样本元数据 TSV 就是第三个文件,无需改动。参见 QIIME 2 — 导出数据。
- 1
导出特征表并转换为 TSV
qiime tools export --input-path table.qza --output-path exported/
biom convert -i exported/feature-table.biom -o otu_table.tsv --to-tsv
上传前,从 otu_table.tsv 中删除开头的 "# Constructed from biom file" 注释行,使表头行以分类单元 id 列开始。
- 2
导出分类
qiime tools export --input-path taxonomy.qza --output-path exported/
生成 exported/taxonomy.tsv(Feature ID + Taxon + Confidence)。可选择将 Taxon 字符串拆分为每个分类等级一列。
- 3
直接使用你的样本元数据
# sample-metadata.tsv — first column = sample id, remaining columns = variables
你传给 QIIME 2 的同一个元数据 TSV 就是第三个上传文件。
使用的材料
示例输出文件
下载工具页面演示中使用的输出文件。您可以直接上传到 IntMeta 来探索可视化。
单个和比较
图表参考
IntMeta 中 微生物组群落分析 生成的所有 6 个可视化的详细描述。
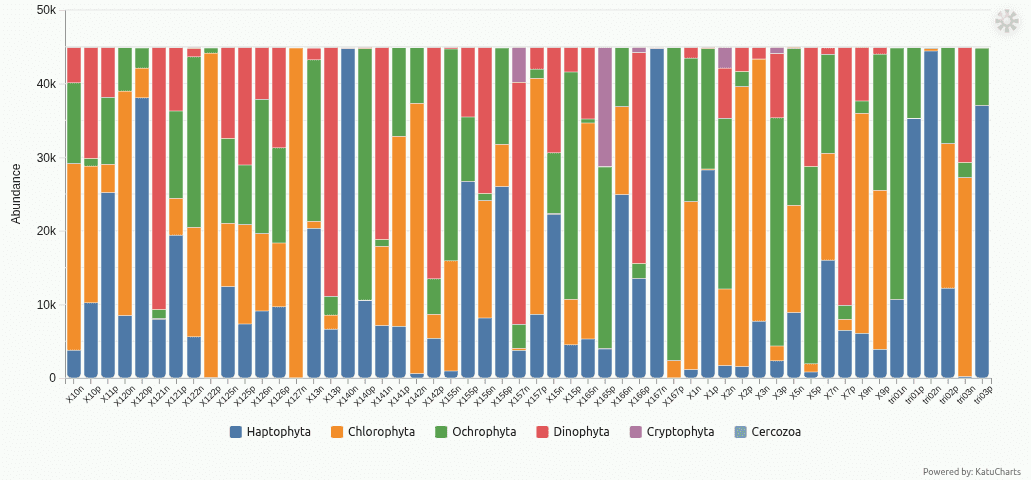
composition
在所选分类等级上,按样本展示相对丰度的堆叠柱状图。每根柱子代表一个样本——或按某个元数据变量合并的一组样本——并按最丰富的分类单元拆分为不同颜色的区段,揭示群落组成如何随站点、深度或粒级变化。
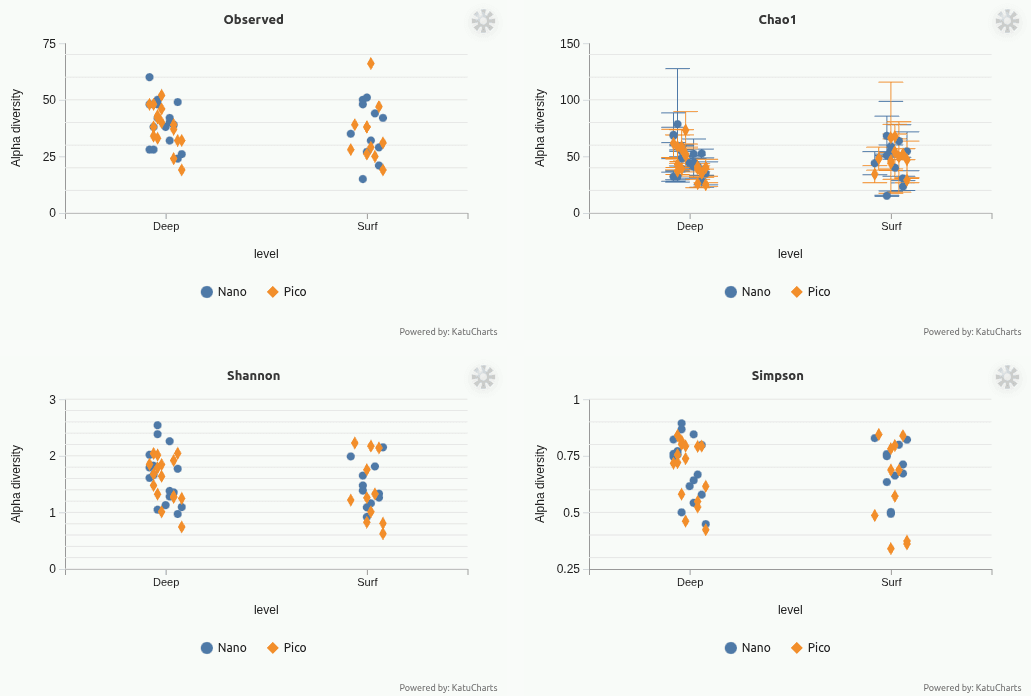
alpha-diversity
以每个样本一个点并附带置信区间的方式展示样本内多样性,并按测度分面:观测丰富度、Chao1(其标准误以带端帽的误差棒绘制)、Shannon 熵和 Simpson 指数。各点沿所选的分类型元数据变量排列,并按第二个变量着色,从而突出处理或深度对多样性的影响。
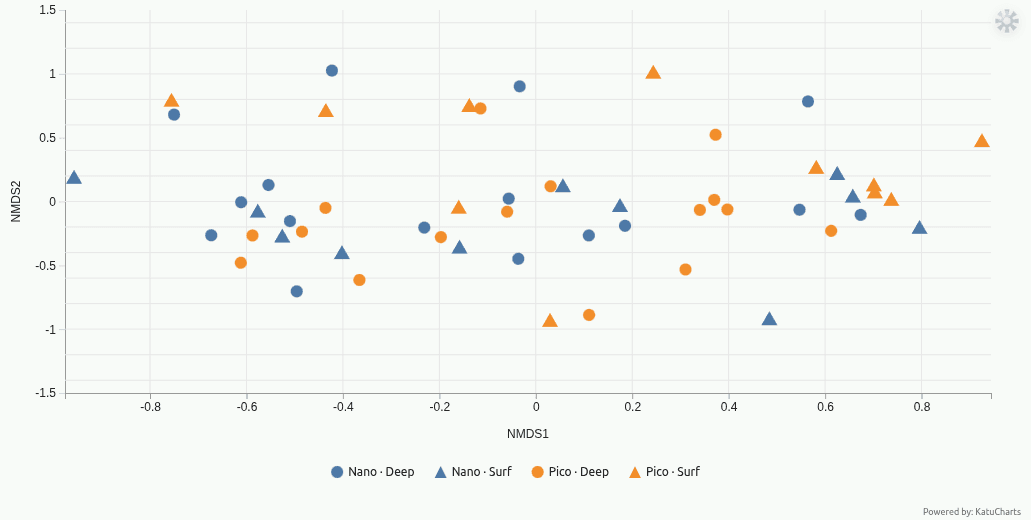
ordination-samples
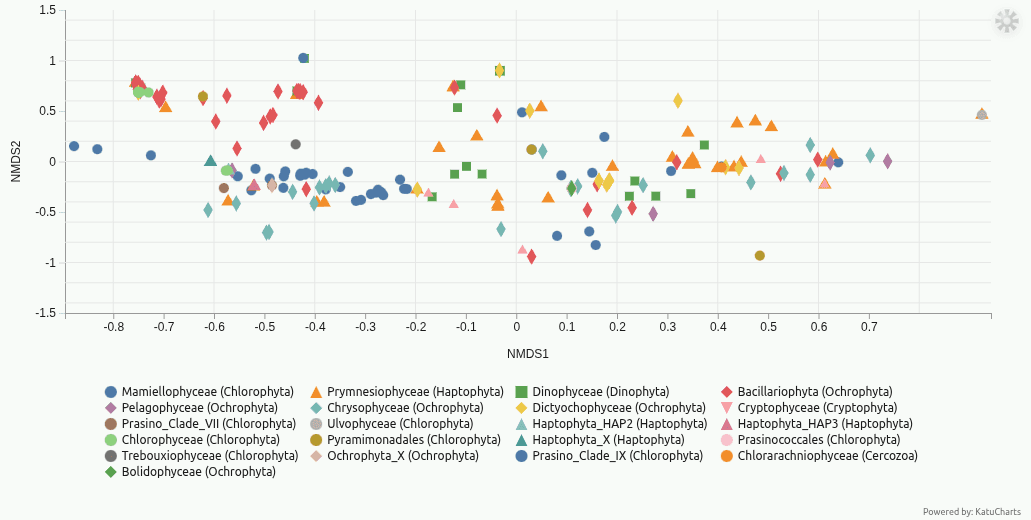
基于 Bray-Curtis 或 Jaccard 距离矩阵计算的样本 β 多样性排序(NMDS 或 PCoA)。每个点是一个样本,按元数据变量着色和赋形;相邻的点具有相似的群落。可选的 95% 置信椭圆用于概括各组。
ordination-taxa
将同一排序投影到分类单元上:每个点是一个分类单元,按其加权平均得分定位,按一个分类等级着色、按另一个分类等级赋形。突出哪些分类单元驱动了样本之间的分离,以及较高分类等级在群落空间中的聚集方式。
heatmap
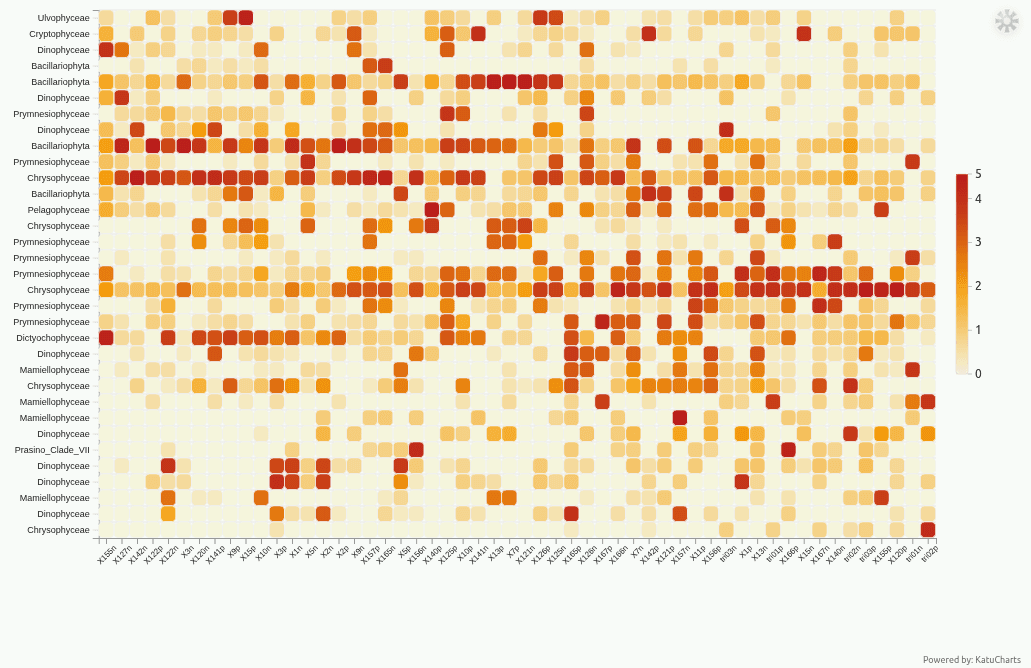
最丰富分类单元(行)在各样本(列)间的丰度热图,行和列按排序结果排列,使共现的分类单元和相似的样本相邻。单元格颜色以米色到红色的色阶编码丰度;丰度阈值控制显示的分类单元数量。
network
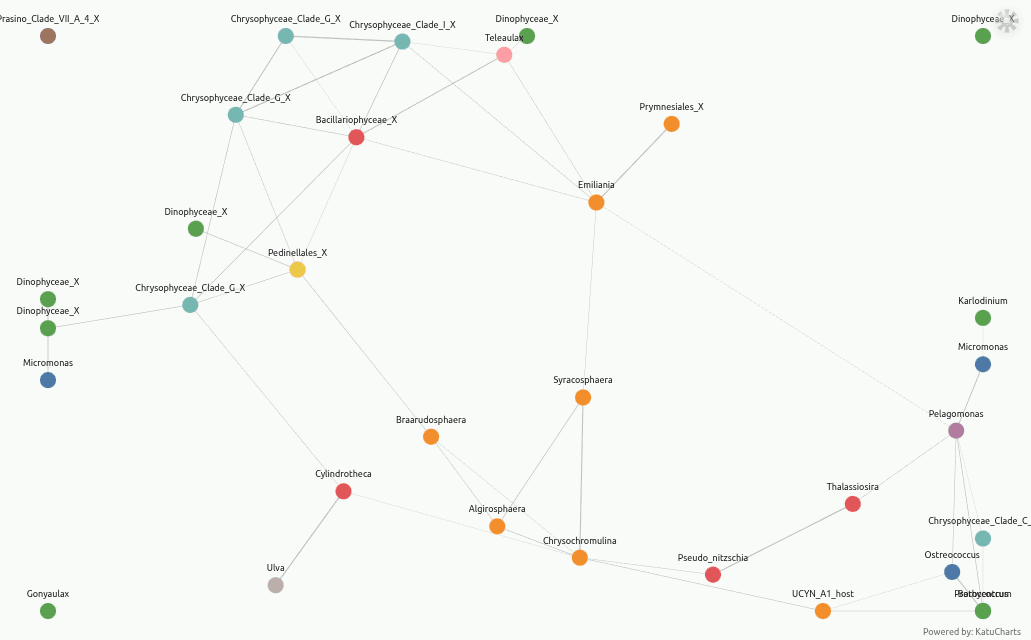
丰富分类单元的共现网络:节点为分类单元(按所选分类等级着色、按另一个分类等级标注),当它们的丰度分布相似时(距离低于可调阈值)相连。边的宽度随紧密程度缩放,节点可拖动,标签会自动分散以保持可读。