VAMB
Binagem de MetagenômicaVAMB (Autoencodadores Variacionais para Binning Metagenômico) usa autoencodadores variacionais profundos para aprender uma representação latente de contigs a partir de suas frequências de tetranucleotídeo e perfis de co-abundância em múltiplas amostras, permitindo binning metagenômico preciso. [1]
Como Obter o Arquivo de Saída do Modelo
Abaixo está um breve fluxo de trabalho que a equipe executou para obter os exemplos de arquivo de saída que apresentamos na página de ferramentas.
Entrada
Contigs co-montados (FASTA) + arquivos de alinhamento BAM por amostra
Saída
TSV com métricas por cluster: nome de cluster, raio, razão pico/vale, tipo (normal/loner/fallback), total bp, contagem de contig, contig medoide
conda install -c bioconda vamb
Imagem Docker: quay.io/biocontainers/vamb:4.1.3--pyhdfd78af_0
Amostra 1 microbioma intestinal (3 amostras do PRJNA795985, 1M pares de leituras cada) co-montado com Montagem e binado com VAMB v5.0.4, produzindo 7.212 clusters.
- 1
Baixar 3 amostras do PRJNA795985
for SRR in SRR17531757 SRR17531762 SRR17531772; do fastq-dump --split-files --gzip -X 1000000 --outdir reads/ $SRR; done
Baixa 1M pares de leituras por amostra (~70 MB comprimidos cada) do estudo "Diet and Antimicrobial Resistance in Healthy US Adults" (Shrestha et al., mBio 2022).
- 2
Co-montar todas as amostras com MEGAHIT
megahit -1 reads/SRR17531757_1.fastq.gz,reads/SRR17531762_1.fastq.gz,reads/SRR17531772_1.fastq.gz -2 reads/SRR17531757_2.fastq.gz,reads/SRR17531762_2.fastq.gz,reads/SRR17531772_2.fastq.gz -o assembly --min-contig-len 1500 -t 8 --presets meta-sensitive
Produz 14.934 contigs (≥1.500 pb).
- 3
Mapear cada amostra para contigs
for SRR in SRR17531757 SRR17531762 SRR17531772; do minimap2 -ax sr -t 8 assembly/final.contigs.fa reads/${SRR}_1.fastq.gz reads/${SRR}_2.fastq.gz | samtools sort -@ 4 -o bams/${SRR}.sorted.bam && samtools index bams/${SRR}.sorted.bam; done - 4
Executar VAMB v5.0.4
vamb bin default --outdir vamb_out --fasta assembly/final.contigs.fa --bamdir bams/ -m 1500 --minfasta 200000 -p 8
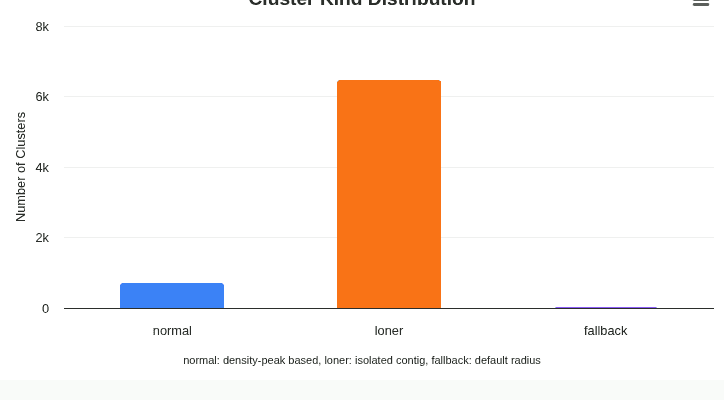
Produz vae_clusters_metadata.tsv com 7.212 clusters (715 normal, 6.472 loner, 25 fallback).
Materiais Utilizados
Arquivos de Saída de Exemplo
Baixe os arquivos de saída usados nas demonstrações da página de ferramentas. Você pode enviá-los diretamente para IntMeta para explorar as visualizações.
Única & Comparação
Análise de Grupo
Referência de Gráficos
Descrições detalhadas para todas as 22 visualizações geradas por VAMB em IntMeta.
cluster-kind-distribution
Gráfico de pizza de tipos de cluster da coluna 'kind': normal (separado por picos de densidade em espaço latente), loner (clusters isolados de contig único) e fallback (atribuído ao raio de agrupamento padrão). Uma montagem saudável produz principalmente clusters normais; muitos clusters fallback sugerem separação pobre.
genome-size-distribution
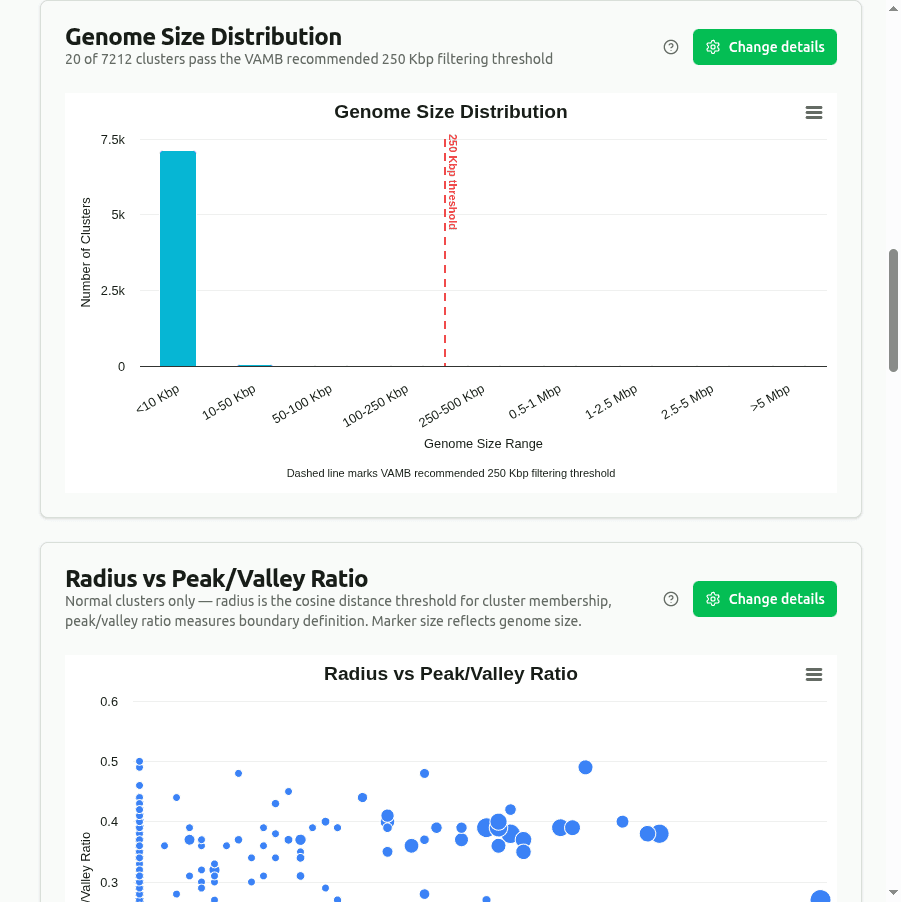
Gráfico de barras de total bp por cluster, ordenado por tamanho e colorido por tipo. VAMB recomenda filtrar clusters abaixo de 250 Kbp e descartar clusters fallback para análise posterior.
radius-vs-pvr
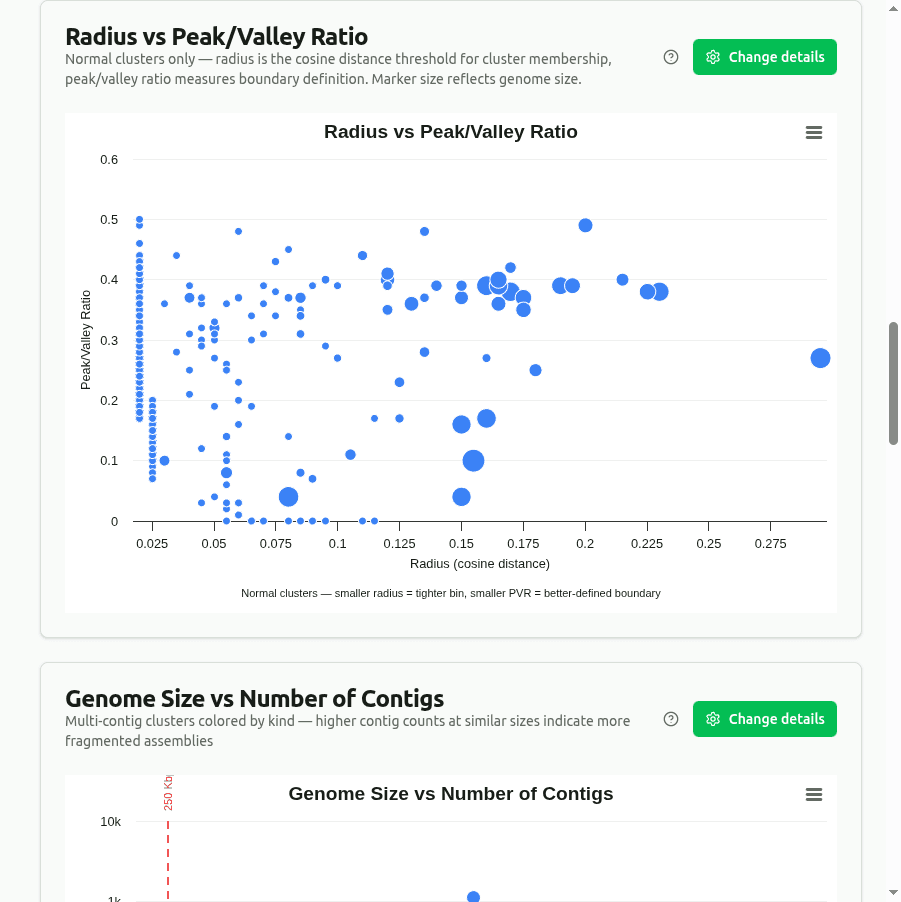
Gráfico de dispersão de raio de agrupamento versus razão pico-para-vale (PVR, coluna 'peak valley ratio'), colorido por tipo. Clusters normais tipicamente têm PVR mais alto (separação de densidade mais clara) e raio mais apertado. PVR baixo com raio grande sugere clusters pobremente resolvidos.
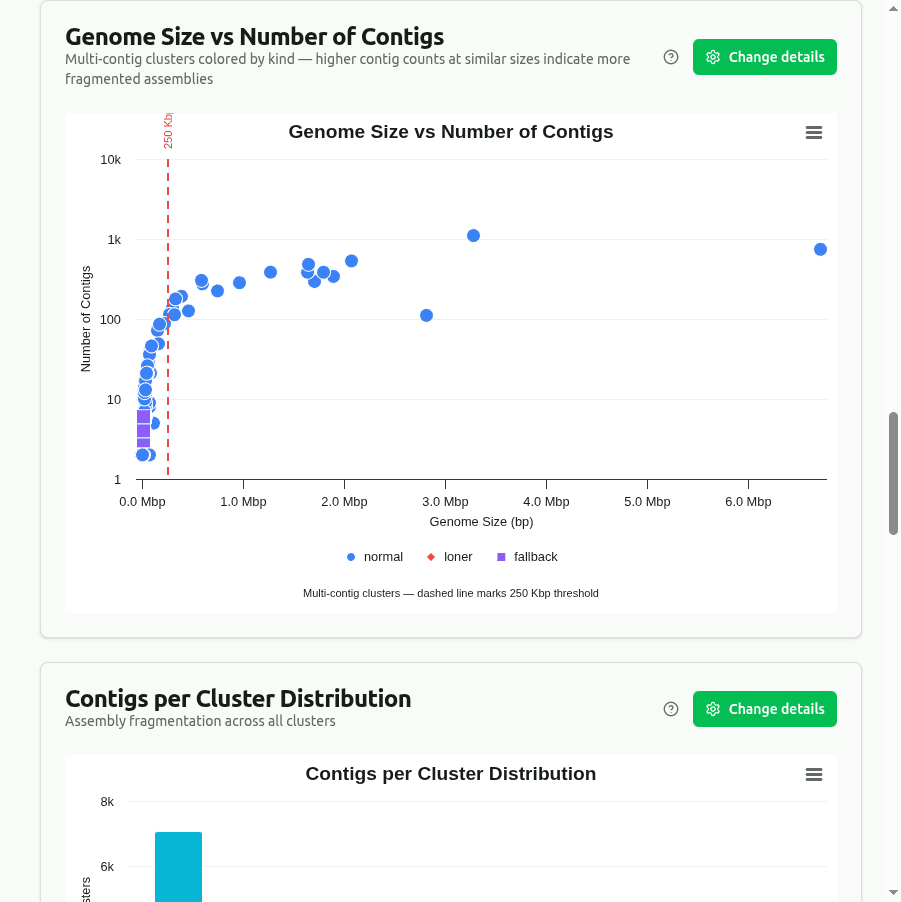
genome-size-vs-contigs
Gráfico de dispersão de total bp (tamanho de genoma) versus ncontigs por cluster. Bins bem resolvidos se agrupam em contagens de contig moderadas com tamanhos de genoma substanciais. Pontos no canto superior-esquerdo (muitos contigs, genoma pequeno) podem indicar clusters quiméricos.
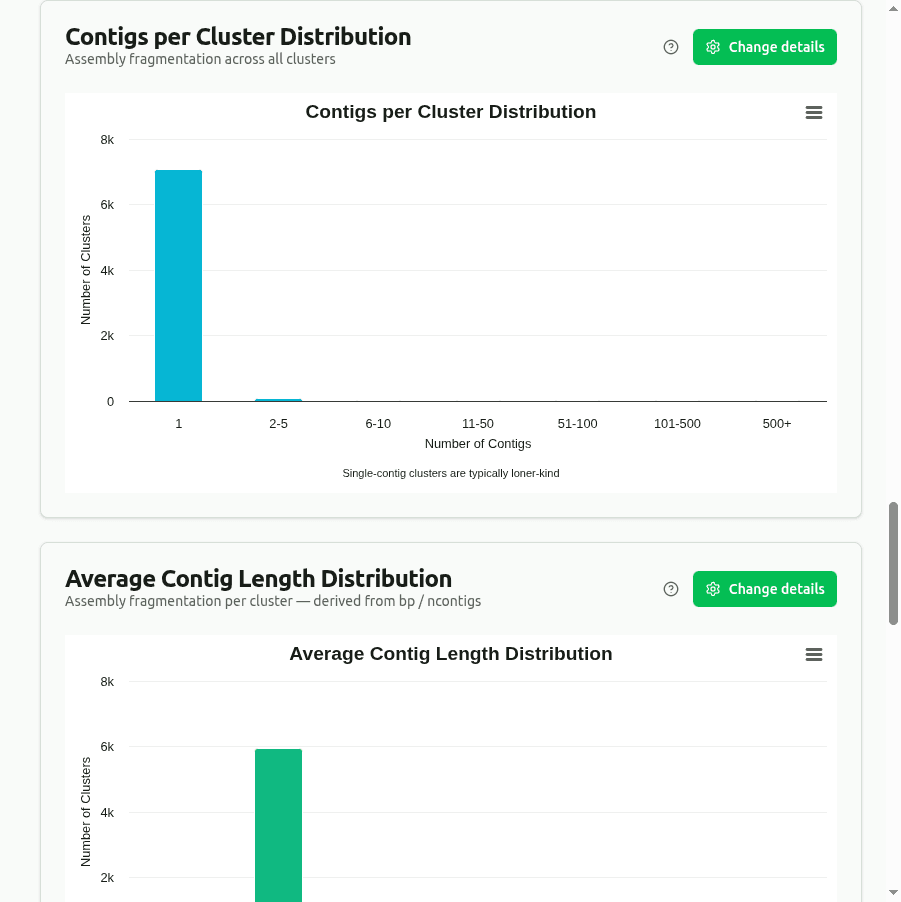
contigs-per-cluster
Gráfico de barras de ncontigs por cluster, colorido por tipo. Contagens de contig muito altas podem indicar clusters sobre-fragmentados ou quiméricos que mesclaram contigs não relacionados.
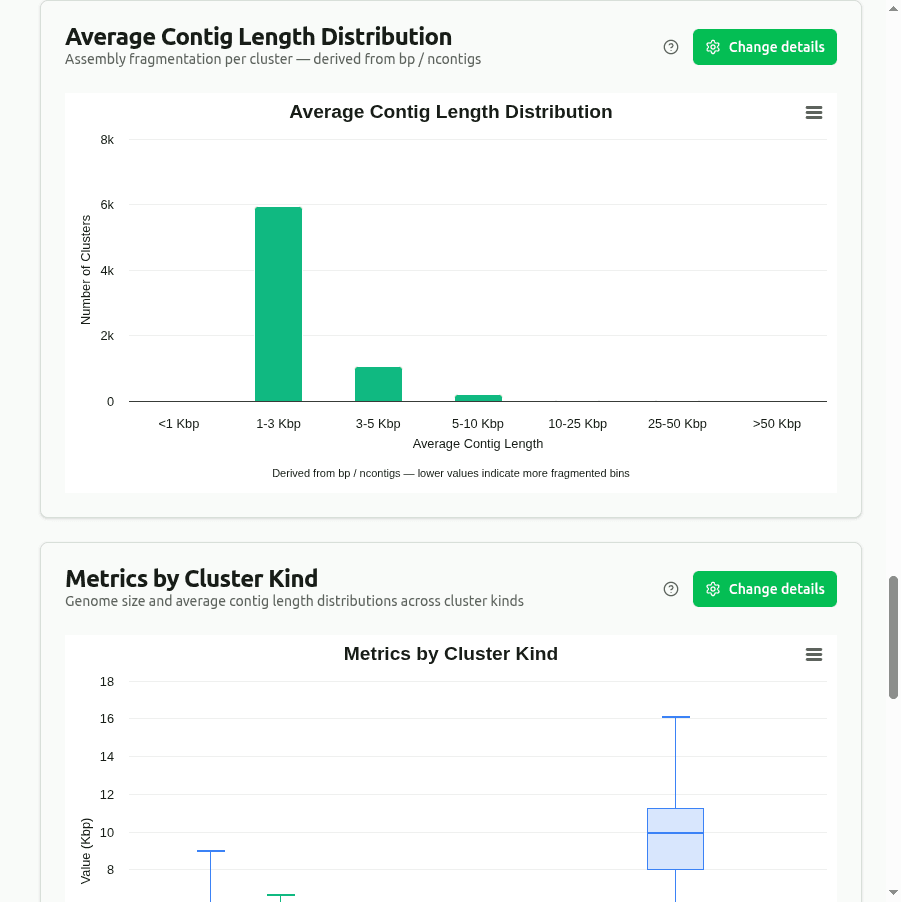
avg-contig-length
Gráfico de barras de comprimento médio de contig (total bp / ncontigs) por cluster. Valores mais altos indicam genomas melhor montados com contigs individuais mais longos. Médias baixas sugerem montagens altamente fragmentadas.
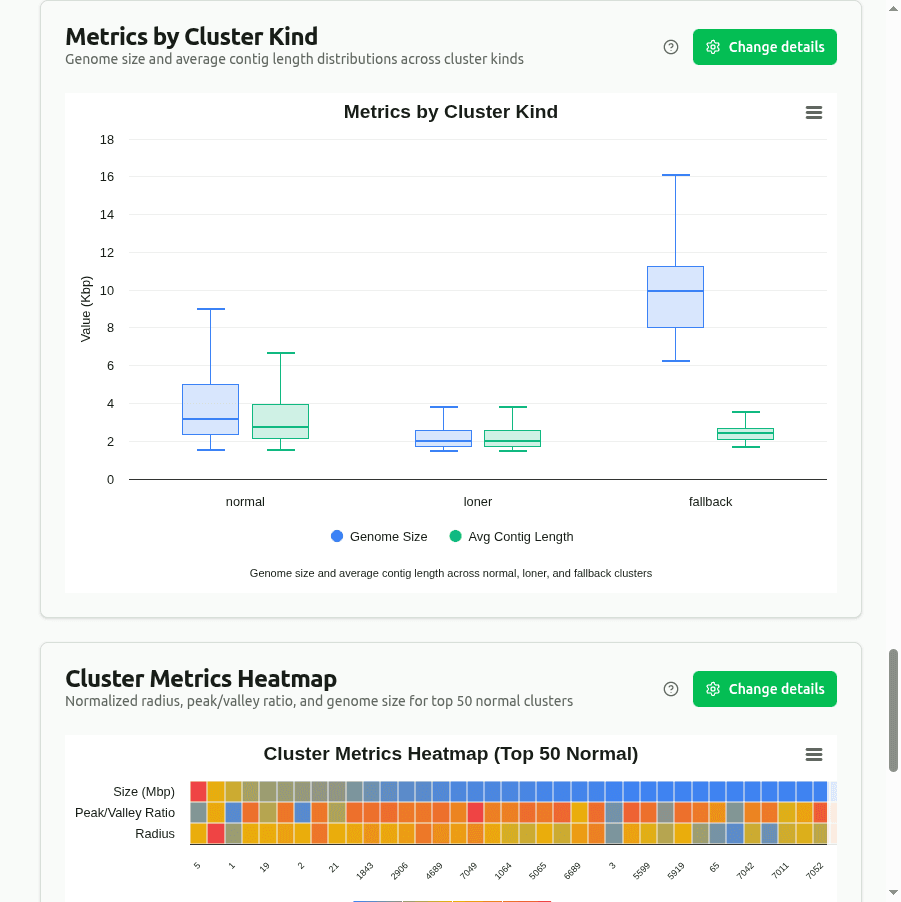
metrics-by-kind
Gráfico de caixa agrupado comparando distribuições de tamanho de genoma (bp), contagem de contig e raio entre os três tipos de cluster (normal, loner, fallback). Revela diferenças sistemáticas — por ex., clusters loner tendem a ser menores com contigs únicos.
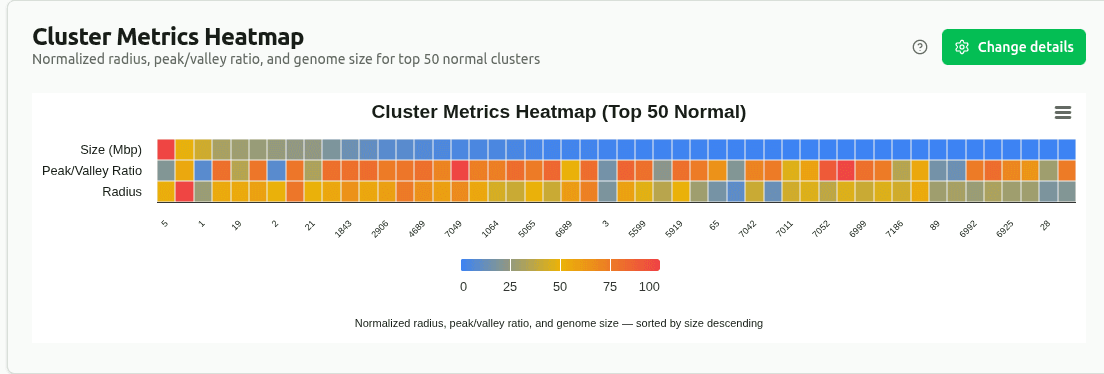
cluster-metrics-heatmap
Mapa de calor de métricas normalizadas min-max (bp, ncontigs, raio, razão pico-para-vale) entre os principais clusters. Cada métrica é escalada 0–1 dentro de sua coluna; células mais escuras = valores relativos mais altos. Útil para identificar clusters outlier.
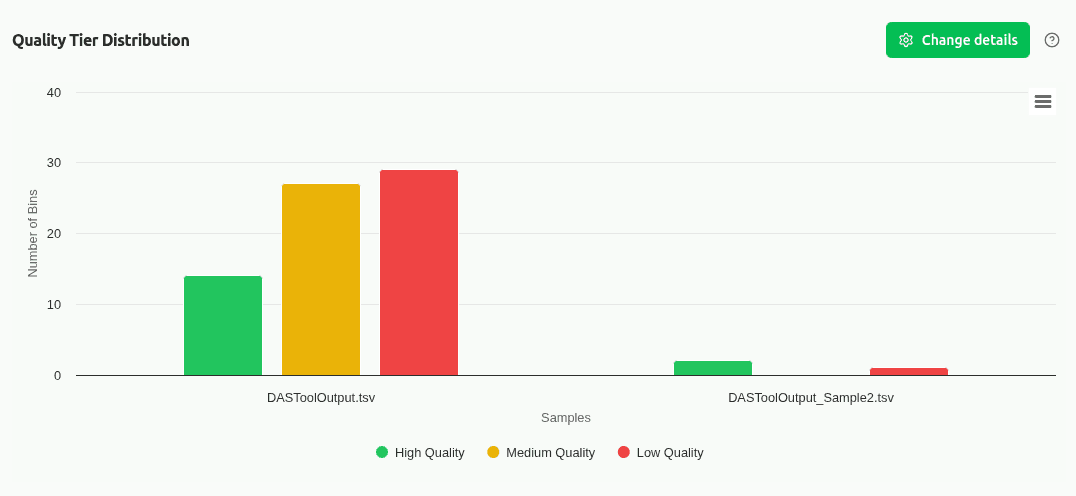
comp-quality-tiers
Gráfico de barras agrupadas comparando a distribuição de níveis de qualidade heurísticos (Alto / Médio / Baixo baseados em limites de tamanho de genoma e N50) entre amostras. Revela qual amostra produziu clusters VAMB mais de alta qualidade.
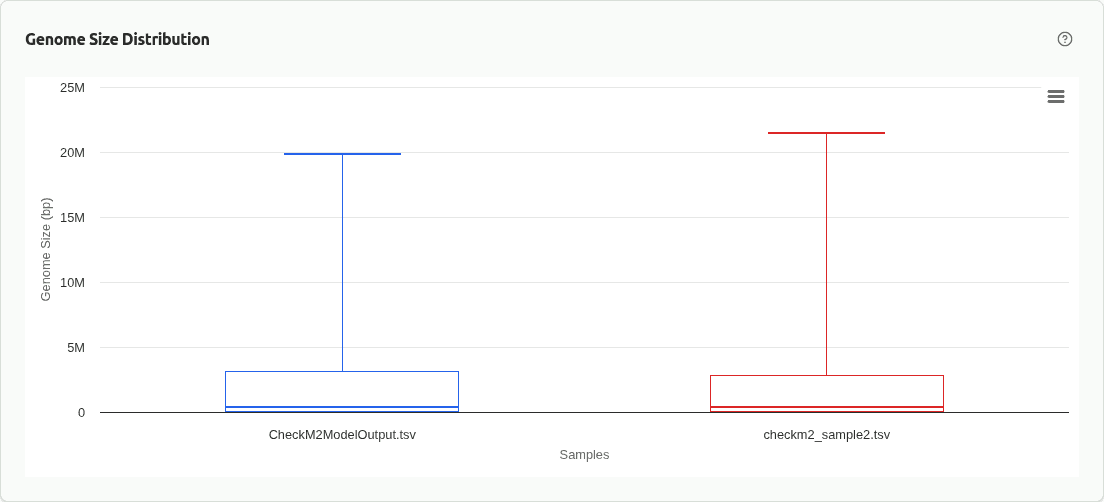
comp-genome-size
Gráfico de caixa ou gráfico de barras agrupadas comparando a distribuição de tamanho de genoma (total bp) de clusters VAMB entre amostras. Diferenças podem refletir complexidade de comunidade variada ou profundidade de co-montagem.
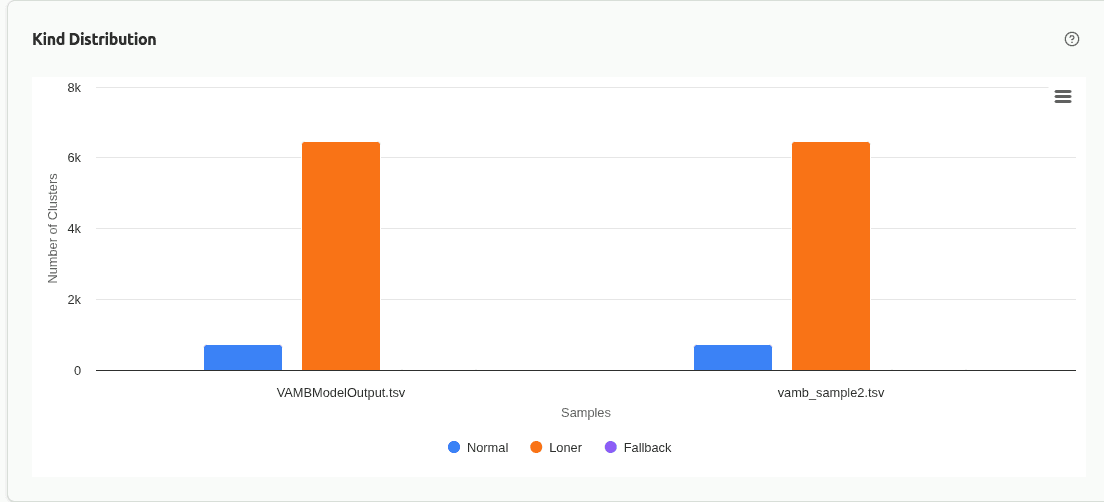
comp-kind-distribution
Gráfico de barras empilhado ou agrupado comparando a proporção de clusters normais, loner e fallback entre amostras. Uma fração mais alta de clusters normais indica melhor separação de espaço latente e binning mais confiável.
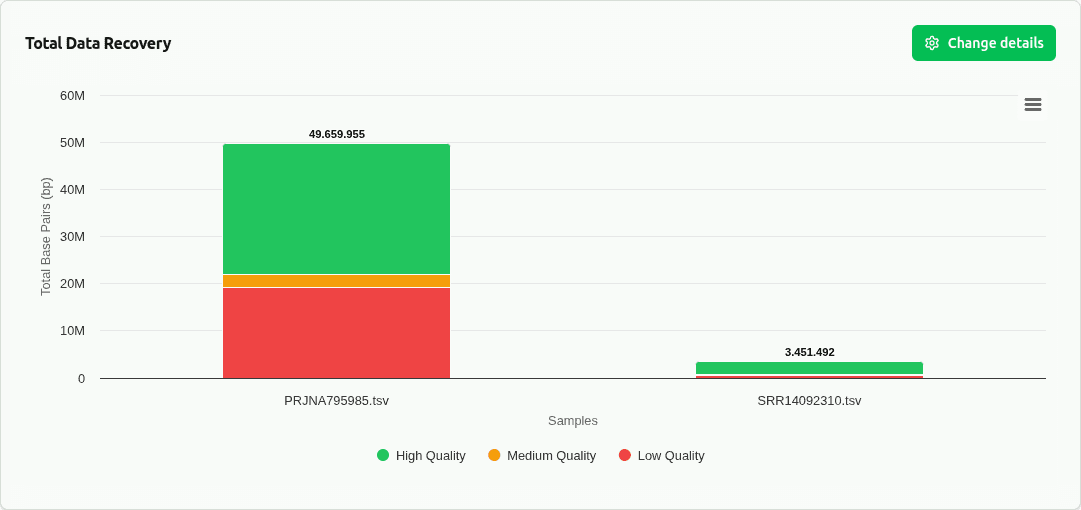
comp-quality-pct
Gráfico de barras empilhadas 100% mostrando a proporção de clusters de qualidade Alto / Médio / Baixo por amostra. Normaliza para diferentes contagens de clusters, permitindo comparação direta de qualidade de binning. Padrão em benchmarks de desafio CAMI.
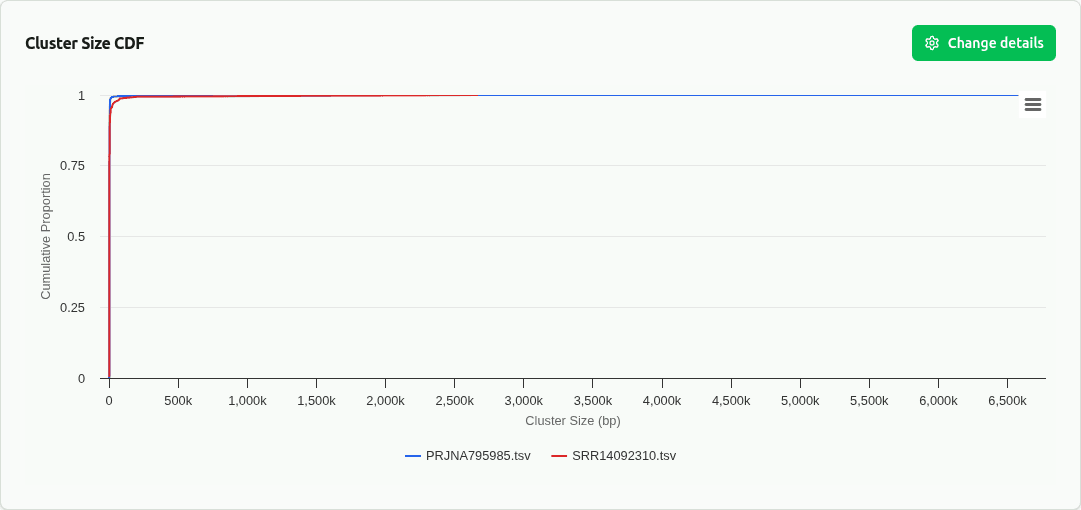
comp-cdf
Função de distribuição cumulativa empírica (CDF) de tamanhos de cluster sobreposta por amostra. Revela forma de distribuição completa além de resumos de boxplot. Padrão em benchmarking CAMI.
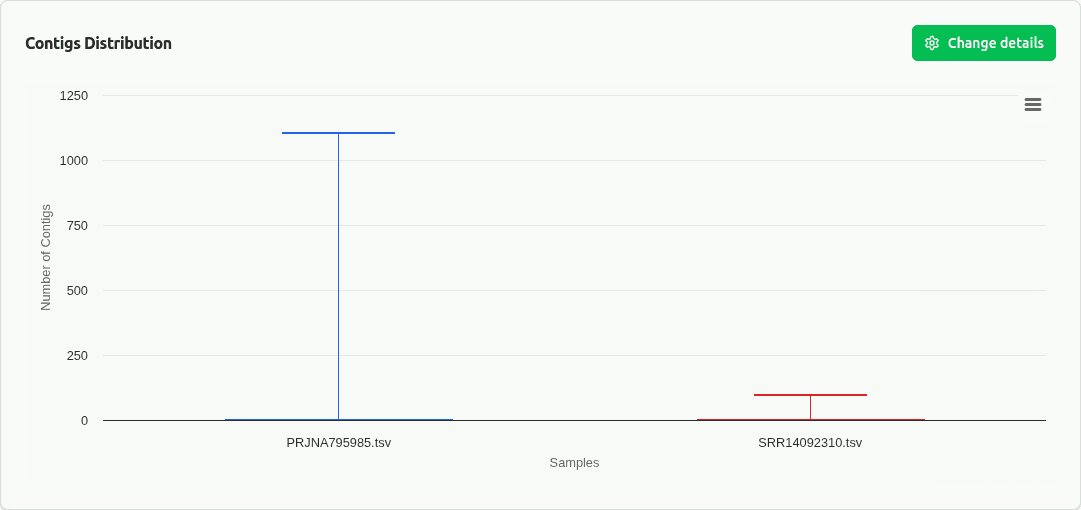
comp-contigs
Boxplot de contagem de contig por cluster entre amostras. Contagens de contig mais altas indicam montagens mais fragmentadas, potencialmente de profundidade de sequenciamento mais baixa ou composição de comunidade complexa.
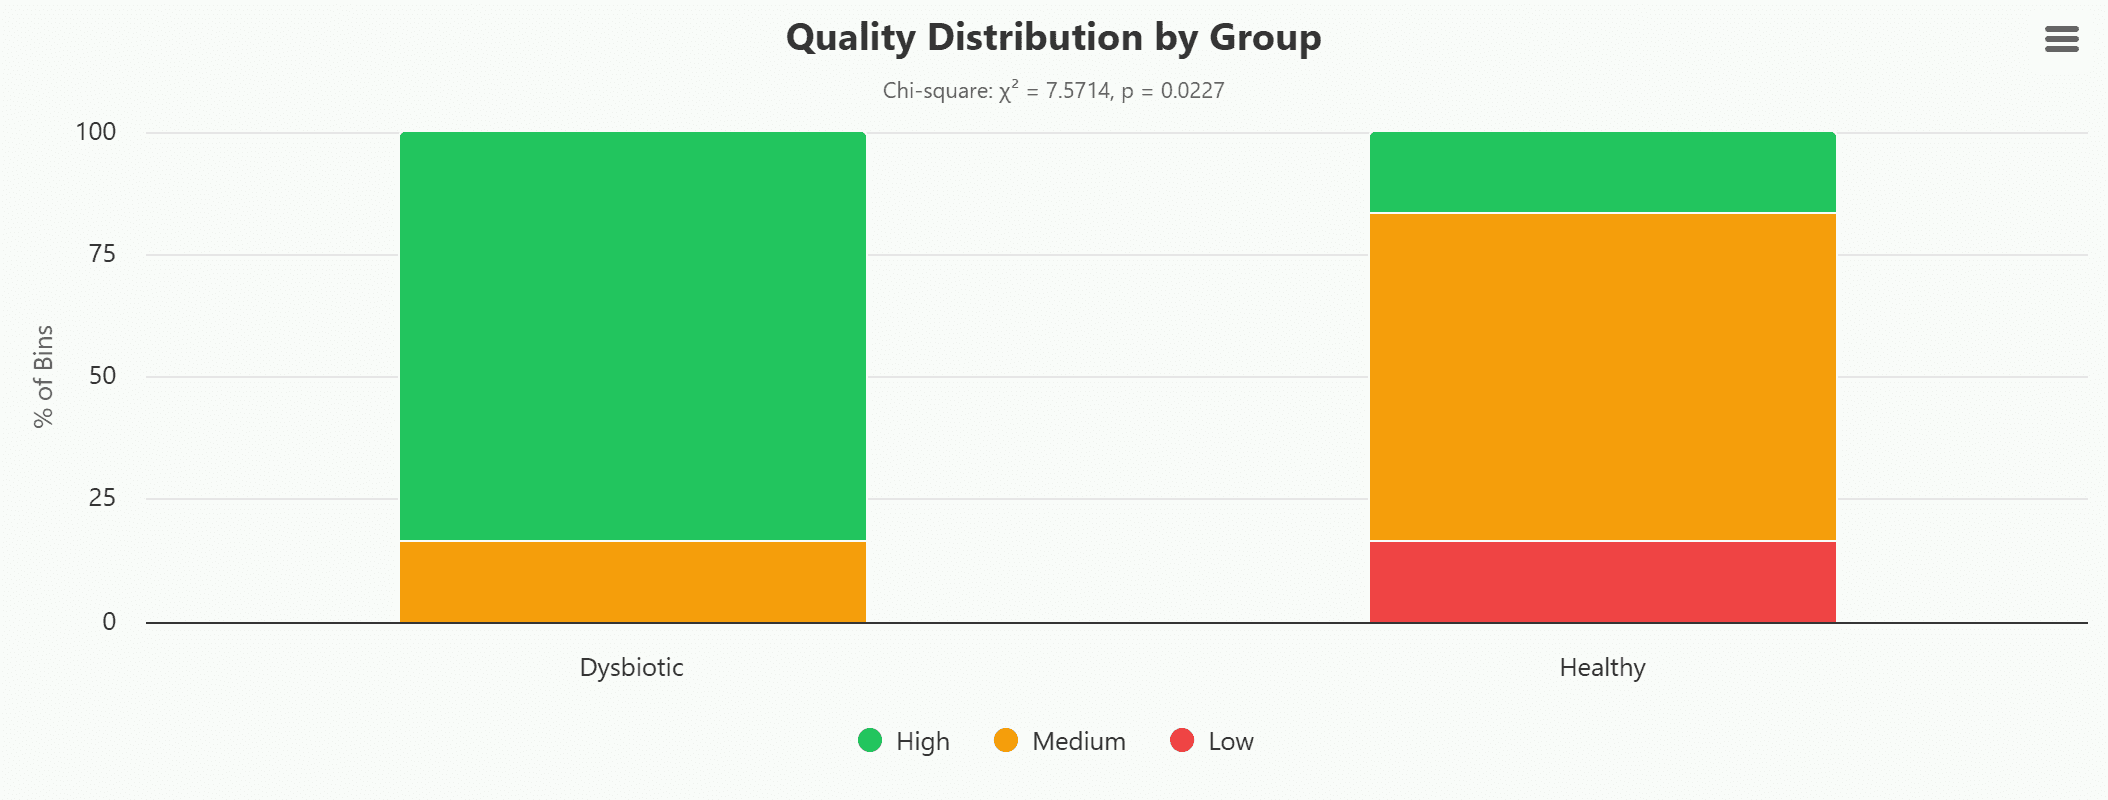
binning-group-quality-tiers
Gráfico de barras agrupadas de contagens de nível de qualidade heurísticos (Alto / Médio / Baixo) por grupo experimental, com teste qui-quadrado. Os níveis são baseados em tipo de cluster e tamanho de genoma: Alto = normal + ≥500 Kbp, Médio = normal ≥100 Kbp ou fallback ≥500 Kbp, Baixo = todo o resto. Nota: estas são heurísticas de métrica de montagem, não classificações MIMAG — VAMB não emite completude ou contaminação.
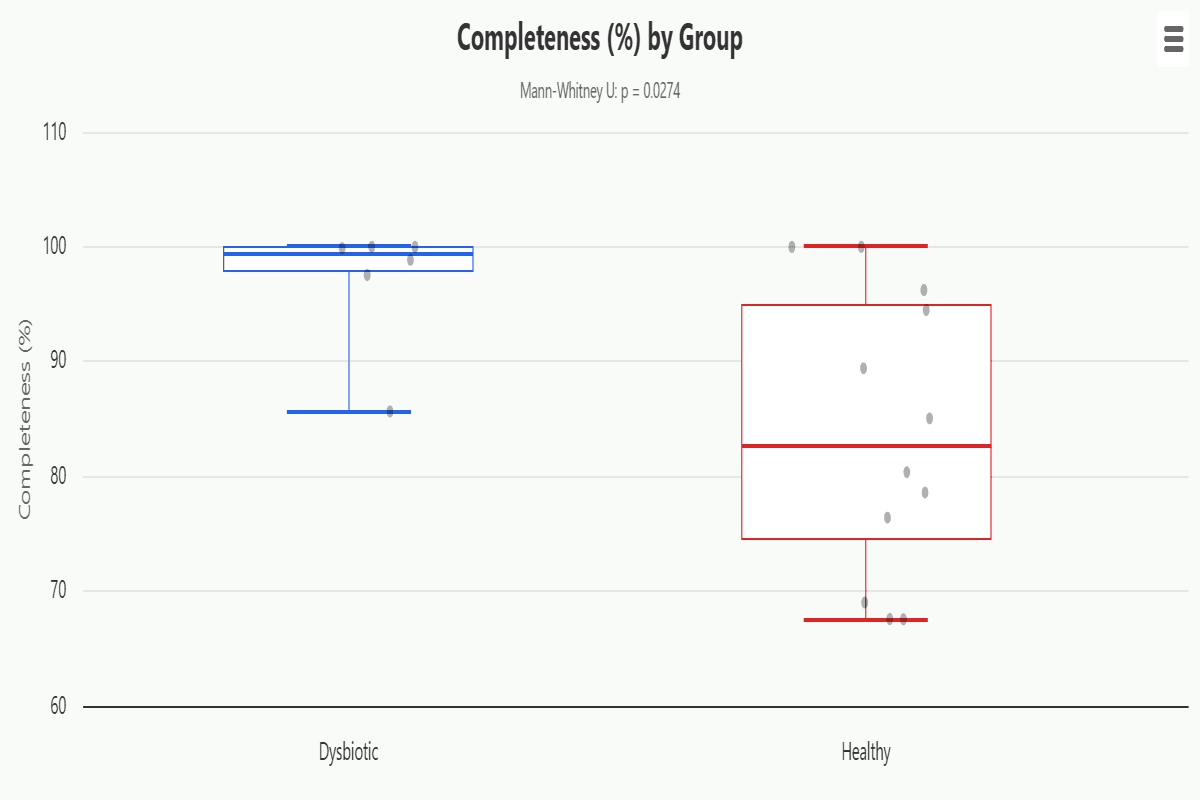
binning-group-metric-boxplots
Boxplots comparando uma métrica selecionada (tamanho de genoma, contagem de contig, raio ou razão pico-para-vale) entre grupos. Todos os valores de cluster individual são agrupados por grupo. Teste de Kruskal-Wallis (≥3 grupos) ou teste U de Mann-Whitney (2 grupos) avalia significância; comparações pareadas usam correção BH FDR.
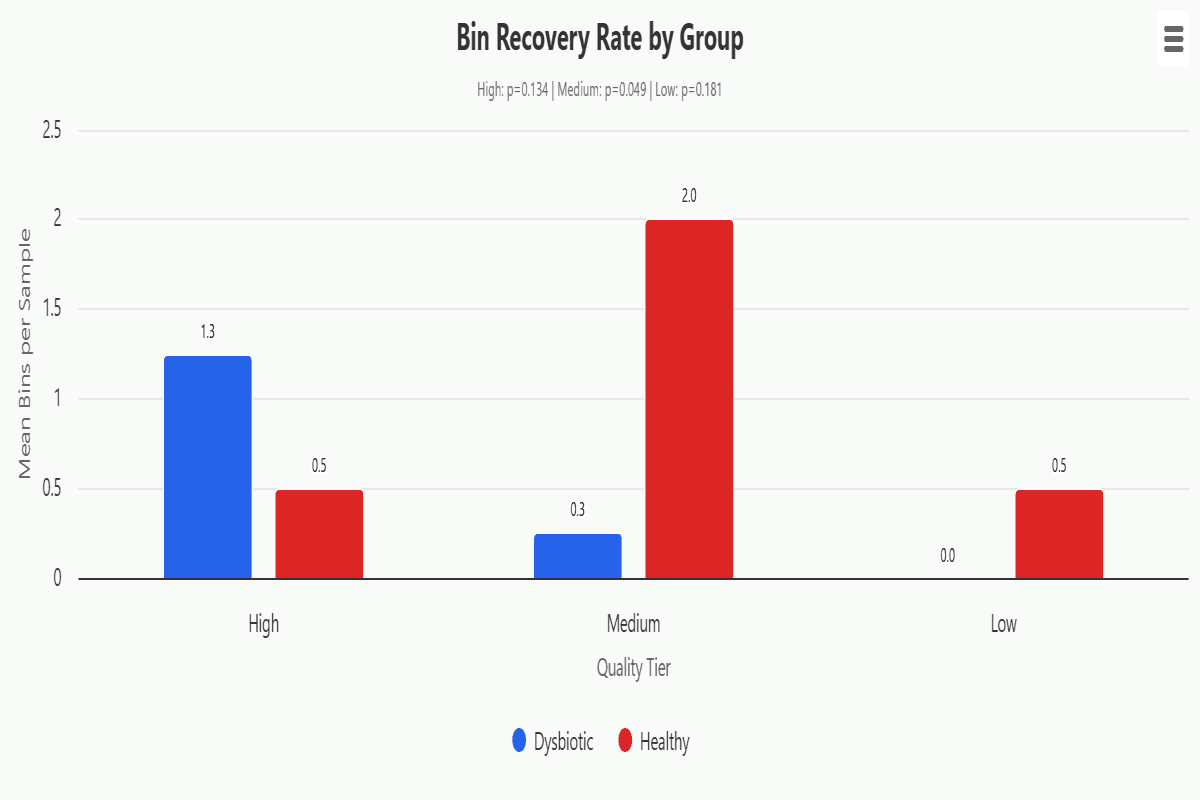
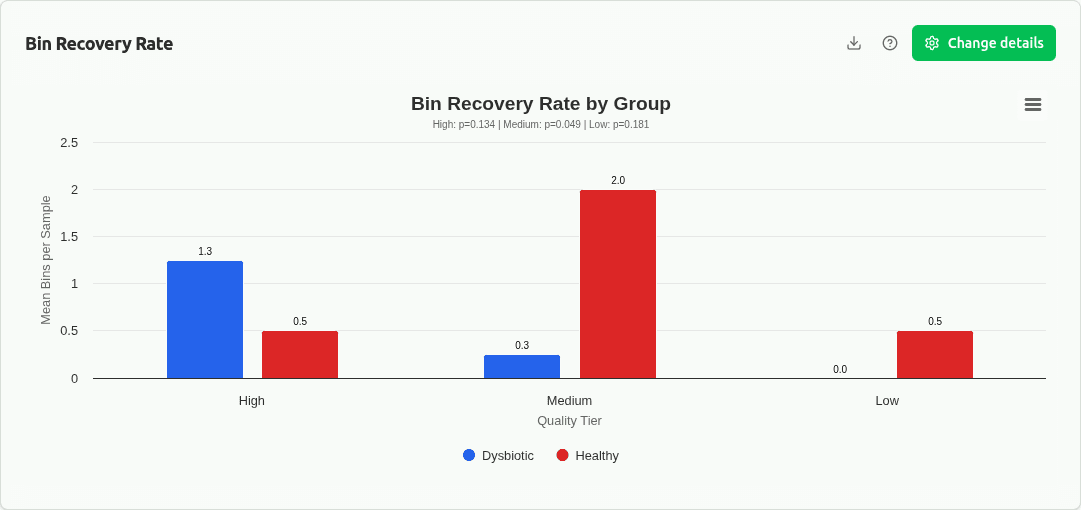
binning-group-recovery-rate
Gráfico de barras agrupadas de contagem média de clusters por amostra em cada nível de qualidade (Alto, Médio, Baixo, Total) entre grupos, com barras de erro ±1 SD. Testa se grupos experimentais diferem em quantos clusters VAMB recuperam em cada nível de qualidade.
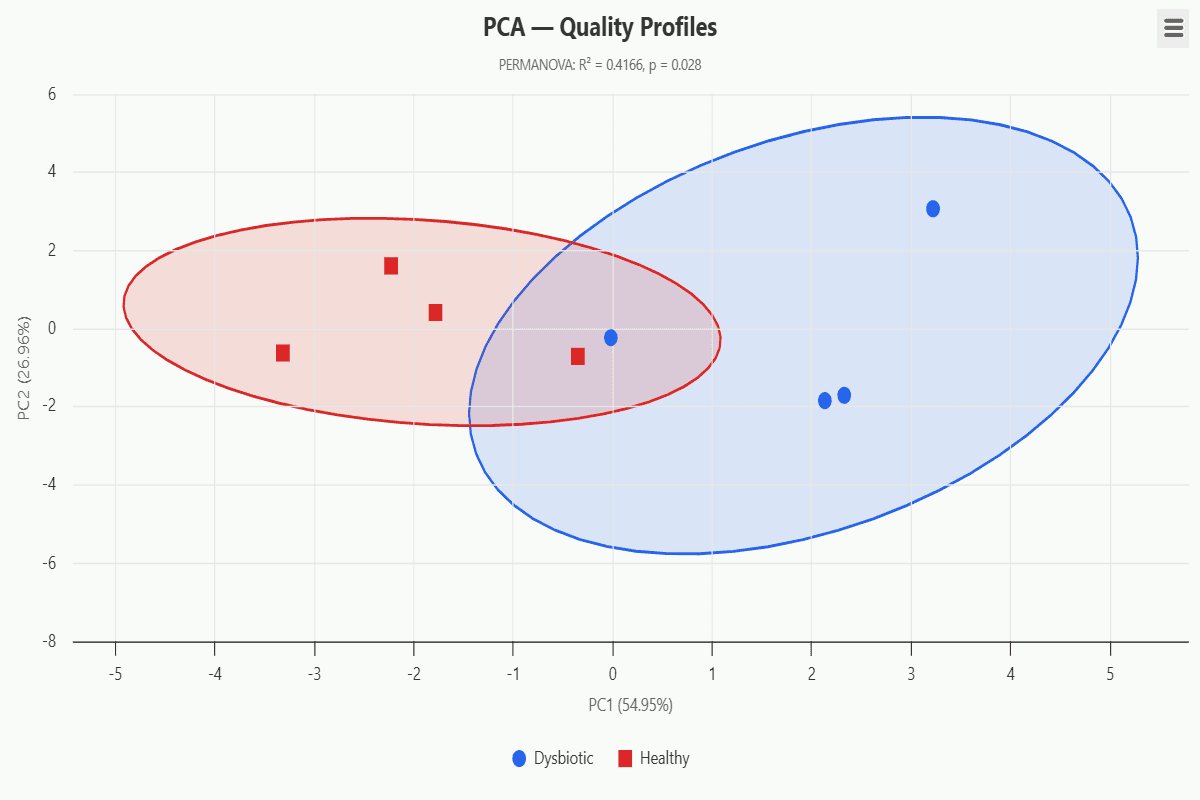
binning-group-pca
Ordenação de PCA de perfis de qualidade por amostra (tamanho de genoma médio, contagem de contig, raio, razão pico-para-vale, %normal, %loner, %fallback, %HQ). Características são padronizadas z-score antes da decomposição. PERMANOVA na matriz de distância euclidiana testa se centroides de grupo diferem significativamente. Elipses de confiança de 95% são desenhadas para grupos com ≥3 amostras.
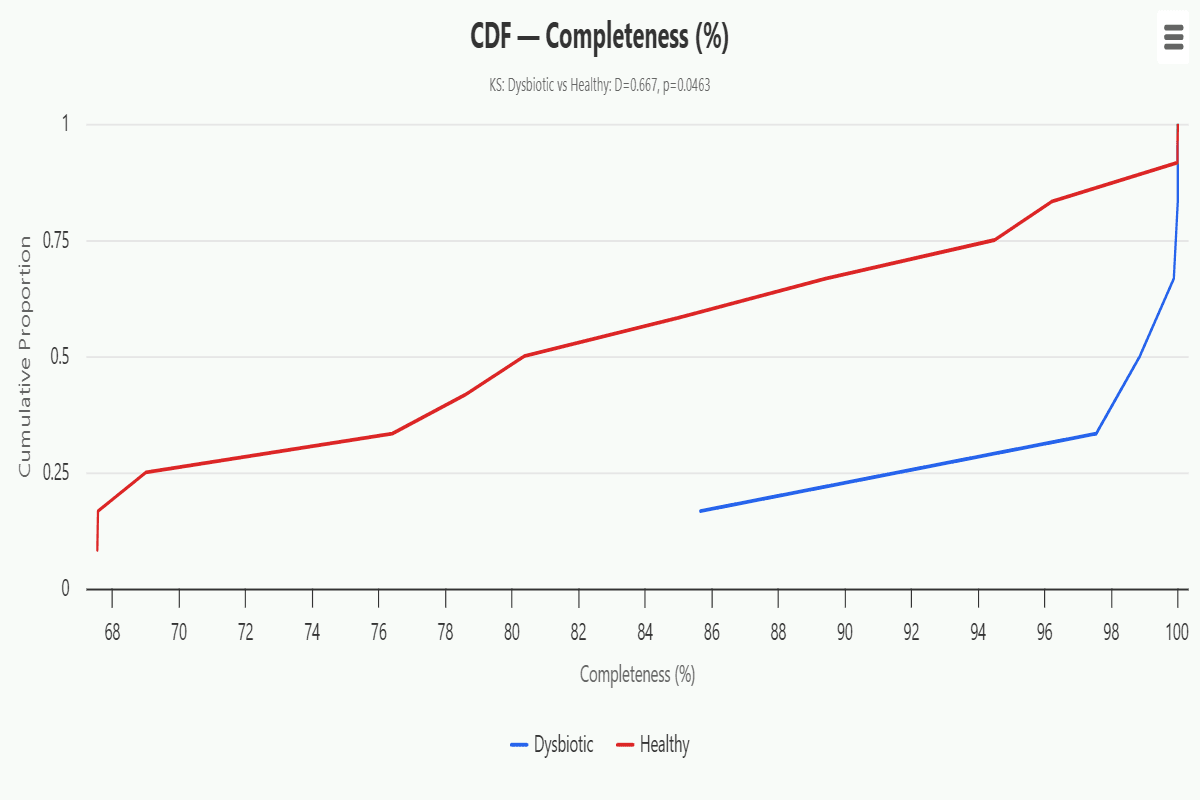
binning-group-cdf
Funções de distribuição cumulativa empírica sobrepostas (CDFs) de uma métrica selecionada entre grupos. O teste de Kolmogorov-Smirnov de duas amostras quantifica a distância vertical máxima entre curvas — D-estatísticas significativas indicam que distribuições de métrica dos grupos diferem em localização, propagação ou forma.
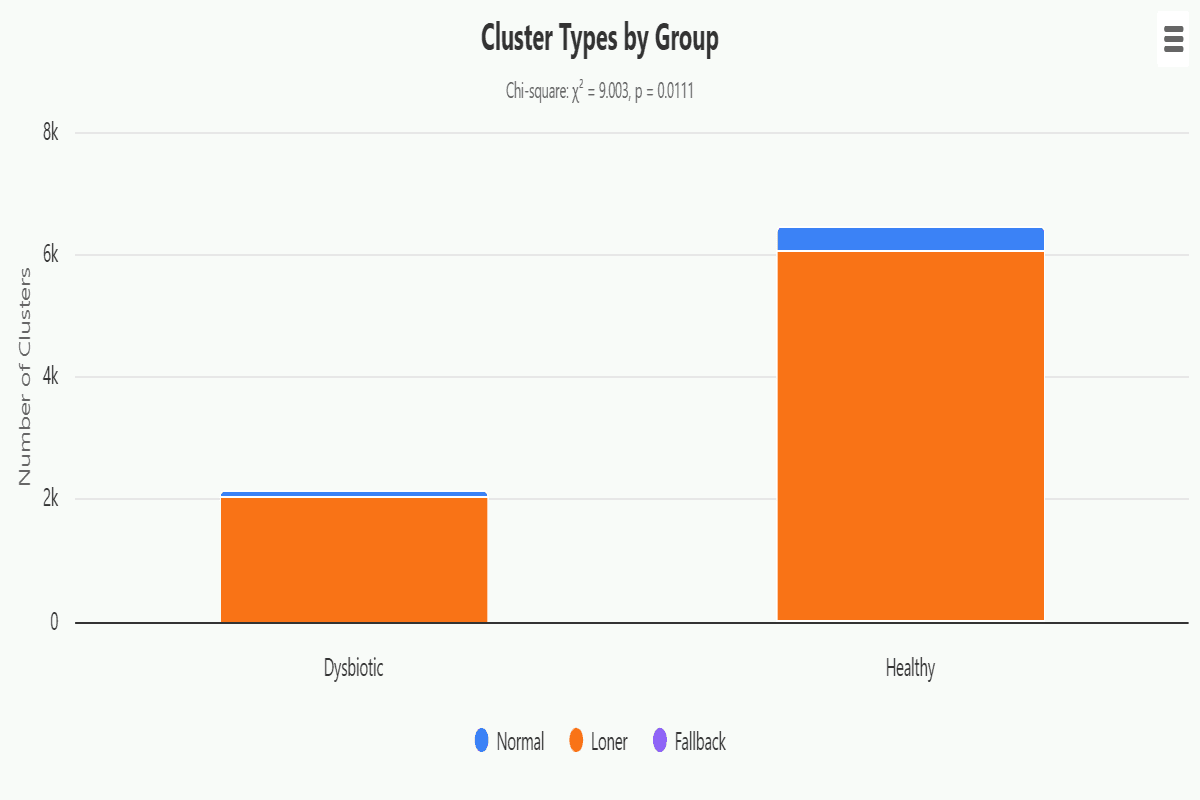
binning-group-cluster-types
Gráfico de barras empilhado de contagens de tipo de cluster (Normal / Loner / Fallback) por grupo, com teste qui-quadrado. Esses três tipos de cluster são definidos por agrupamento de pico de densidade de espaço latente de VAMB. Valores p significativos sugerem que condições experimentais influenciam a proporção de clusters bem separados versus pobremente resolvidos.
binning-group-total-recovery
Gráfico de barras empilhadas de pares de bases totais médios recuperados por grupo, divididos por nível de qualidade. Barras de erro mostram ±1 SD. Mede volume de dados real vinculado por grupo, complementando gráficos de contagem e taxa de recuperação de clusters.