VAMB
Agrupamiento MetagenómicoVAMB (Autoencodificadores Variacionales para Binning Metagenómico) utiliza autoencodificadores variacionales profundos para aprender una representación latente de contigs a partir de sus frecuencias de tetranucleótidos y perfiles de coabundancia a través de múltiples muestras, permitiendo binning metagenómico preciso. [1]
Cómo Obtener el Archivo de Modelo de Salida
A continuación se muestra un breve flujo de trabajo que ejecutó el equipo para obtener los ejemplos de modelo de salida que presentamos en la página de herramientas.
Entrada
Contigs co-ensamblados (FASTA) + archivos de alineamiento BAM por muestra
Salida
TSV con métricas por clúster: nombre de clúster, radio, razón pico/valle, tipo (normal/loner/fallback), bp total, conteo de contigs, contig medioide
conda install -c bioconda vamb
Imagen Docker: quay.io/biocontainers/vamb:4.1.3--pyhdfd78af_0
Muestra 1 microbioma intestinal (3 muestras de PRJNA795985, 1M pares de lecturas cada una) co-ensambladas con Asamblea y bineadas con VAMB v5.0.4, produciendo 7,212 clústeres.
- 1
Descargar 3 muestras de PRJNA795985
for SRR in SRR17531757 SRR17531762 SRR17531772; do fastq-dump --split-files --gzip -X 1000000 --outdir reads/ $SRR; done
Descargar 1M pares de lecturas por muestra (~70 MB comprimido cada una) del estudio "Diet and Antimicrobial Resistance in Healthy US Adults" (Shrestha et al., mBio 2022).
- 2
Co-ensamblar todas las muestras con MEGAHIT
megahit -1 reads/SRR17531757_1.fastq.gz,reads/SRR17531762_1.fastq.gz,reads/SRR17531772_1.fastq.gz -2 reads/SRR17531757_2.fastq.gz,reads/SRR17531762_2.fastq.gz,reads/SRR17531772_2.fastq.gz -o assembly --min-contig-len 1500 -t 8 --presets meta-sensitive
Produce 14,934 contigs (≥1,500 bp).
- 3
Mapear cada muestra a contigs
for SRR in SRR17531757 SRR17531762 SRR17531772; do minimap2 -ax sr -t 8 assembly/final.contigs.fa reads/${SRR}_1.fastq.gz reads/${SRR}_2.fastq.gz | samtools sort -@ 4 -o bams/${SRR}.sorted.bam && samtools index bams/${SRR}.sorted.bam; done - 4
Ejecutar VAMB v5.0.4
vamb bin default --outdir vamb_out --fasta assembly/final.contigs.fa --bamdir bams/ -m 1500 --minfasta 200000 -p 8
Produce vae_clusters_metadata.tsv con 7,212 clústeres (715 normal, 6,472 loner, 25 fallback).
Materiales Utilizados
Archivos de Salida de Ejemplo
Descarga los archivos de salida utilizados en las demostraciones de la página de herramientas. Puedes cargarlos directamente a IntMeta para explorar las visualizaciones.
Único y Comparación
Análisis de Grupo
Referencia de Gráficos
Descripciones detalladas de todas las 22 visualizaciones generadas por VAMB en IntMeta.
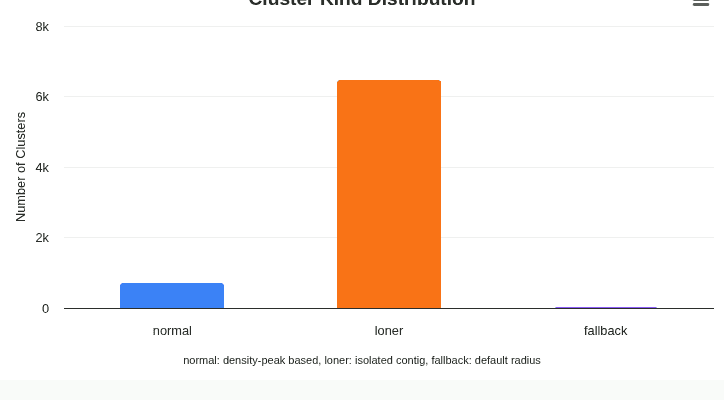
cluster-kind-distribution
Gráfico circular de tipos de clúster de la columna 'kind': normal (separado por picos de densidad en espacio latente), loner (clústeres aislados de contig único), y fallback (asignado el radio de agrupamiento predeterminado). Una asamblea saludable produce principalmente clústeres normales; muchos clústeres fallback sugieren separación pobre.
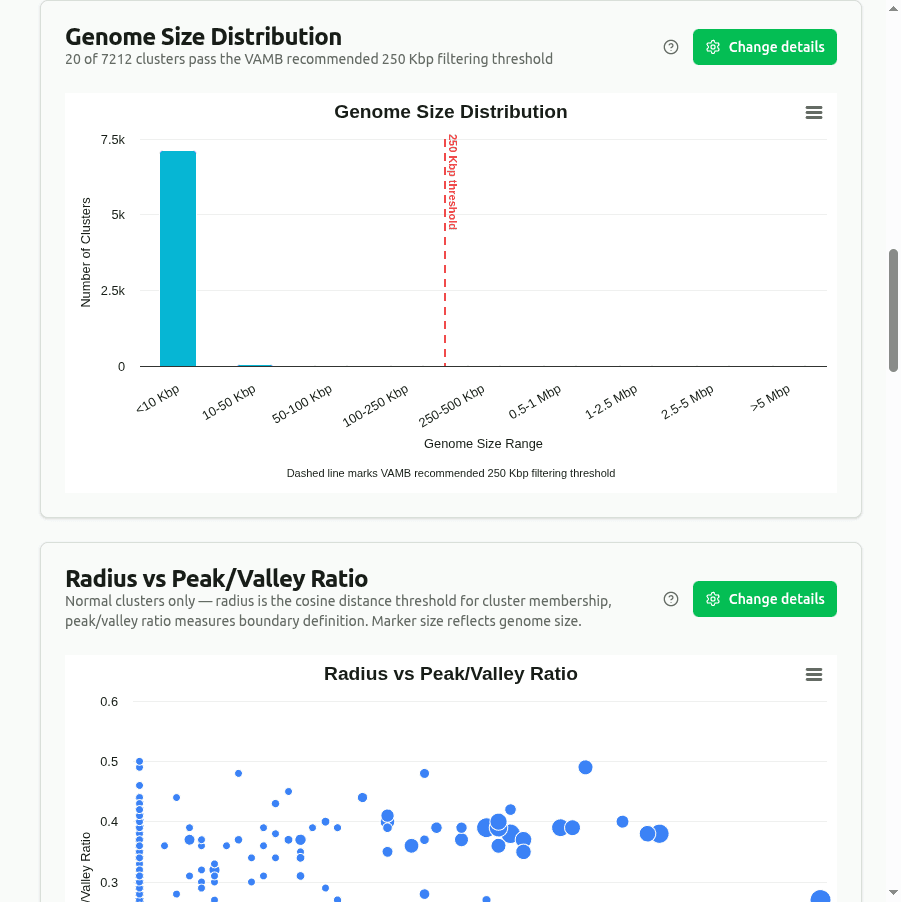
genome-size-distribution
Gráfico de barras de bp total por clúster, clasificado por tamaño y coloreado por tipo. VAMB recomienda filtrar clústeres por debajo de 250 Kbp y descartar clústeres fallback para análisis posteriores.
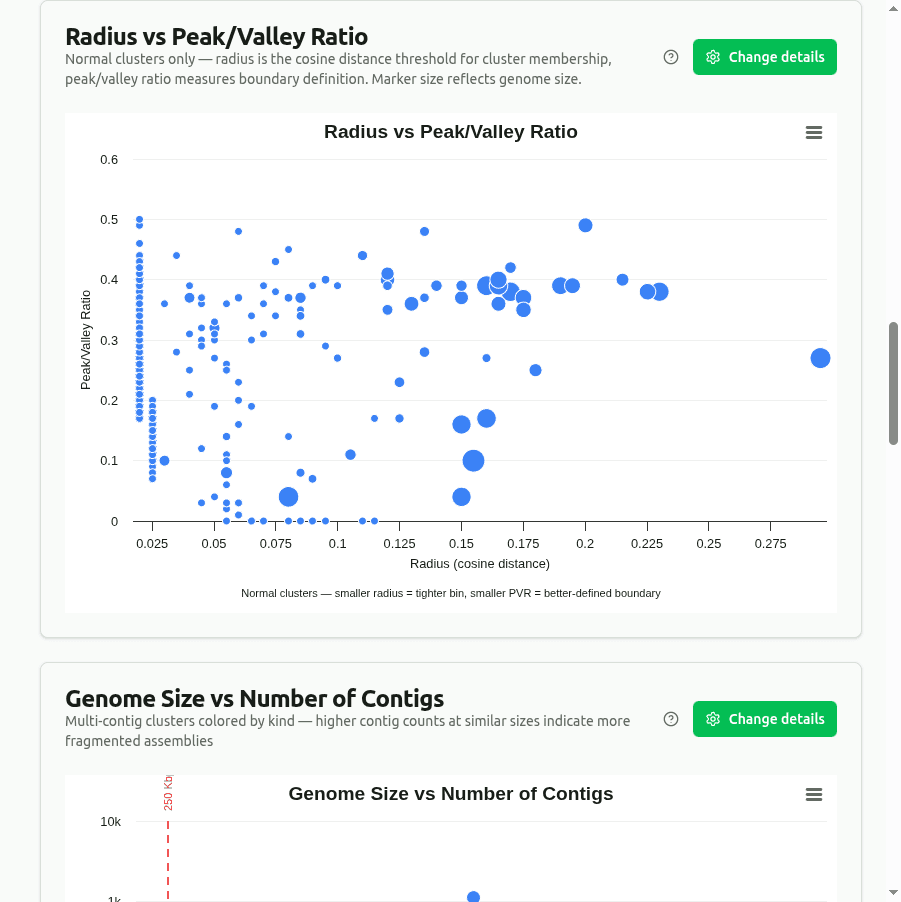
radius-vs-pvr
Gráfico de dispersión de radio de agrupamiento versus razón pico-a-valle (PVR, de la columna 'peak valley ratio'), coloreado por tipo. Los clústeres normales típicamente tienen PVR más alto (separación de densidad más clara) y radio más estricto. PVR bajo con radio grande sugiere clústeres mal resueltos.
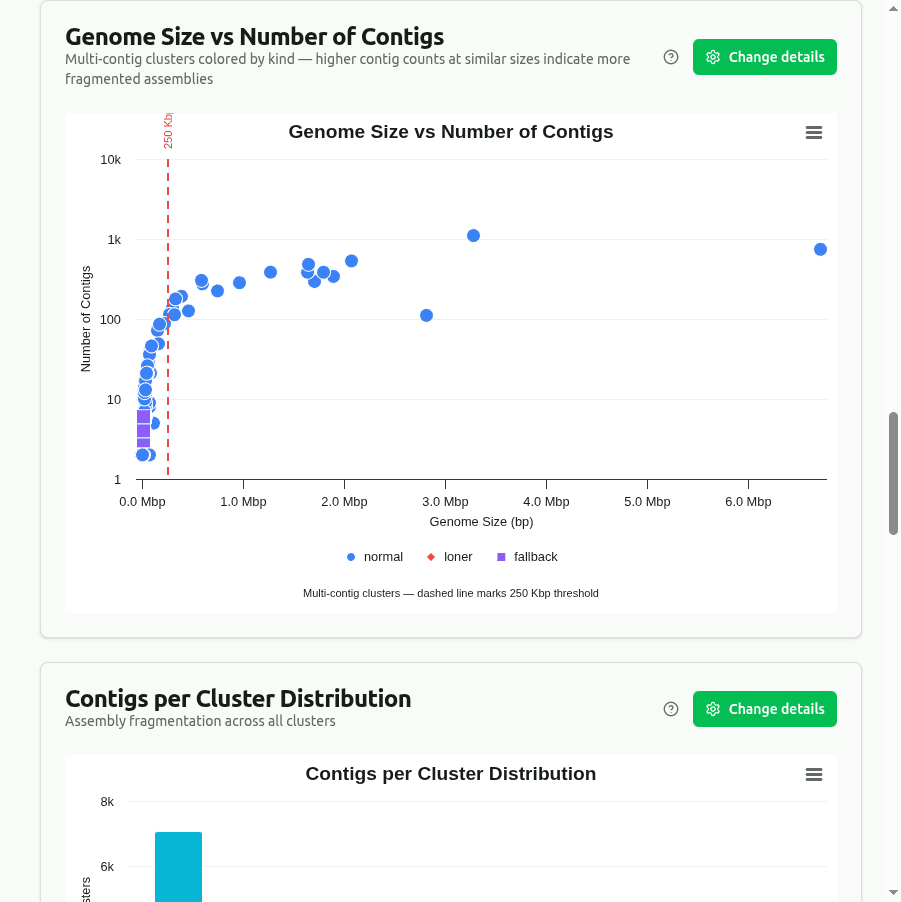
genome-size-vs-contigs
Gráfico de dispersión de bp total (tamaño de genoma) versus ncontigs por clúster. Los bins bien resueltos se agrupan en conteos de contigs moderados con tamaños de genoma sustanciales. Los puntos en la esquina superior izquierda (muchos contigs, genoma pequeño) pueden indicar clústeres quiméricos.
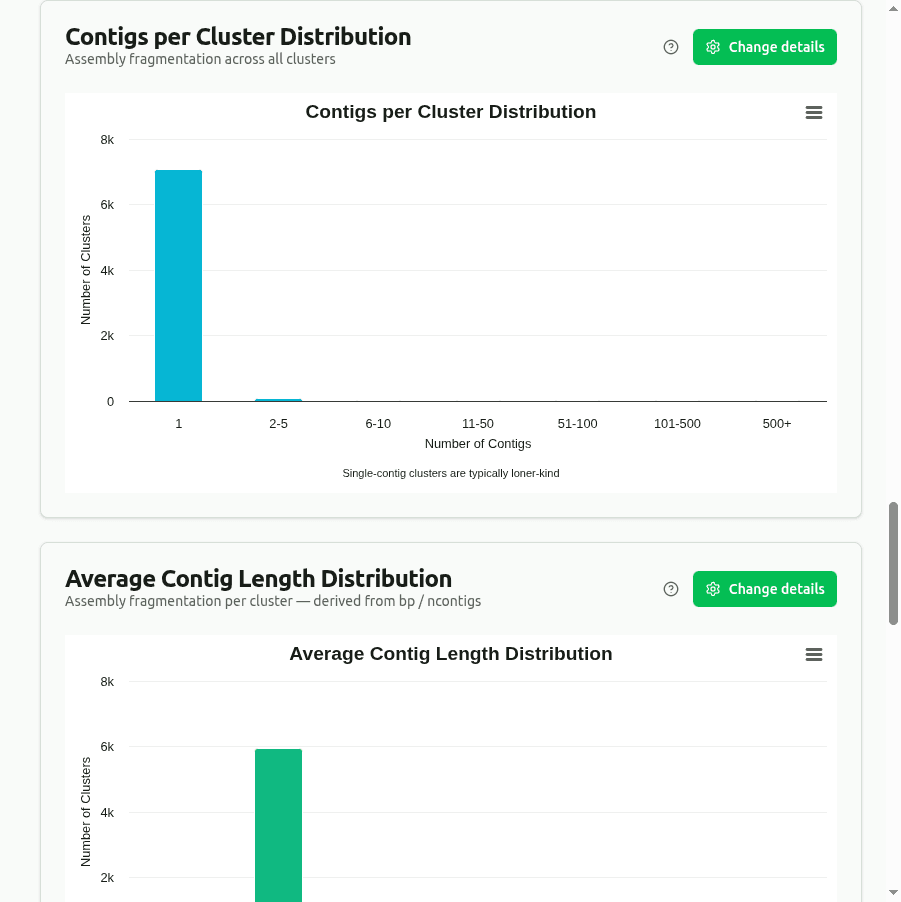
contigs-per-cluster
Gráfico de barras de ncontigs por clúster, coloreado por tipo. Los conteos de contigs muy altos pueden indicar clústeres sobre-fragmentados o quiméricos que fusionaron contigs no relacionados.
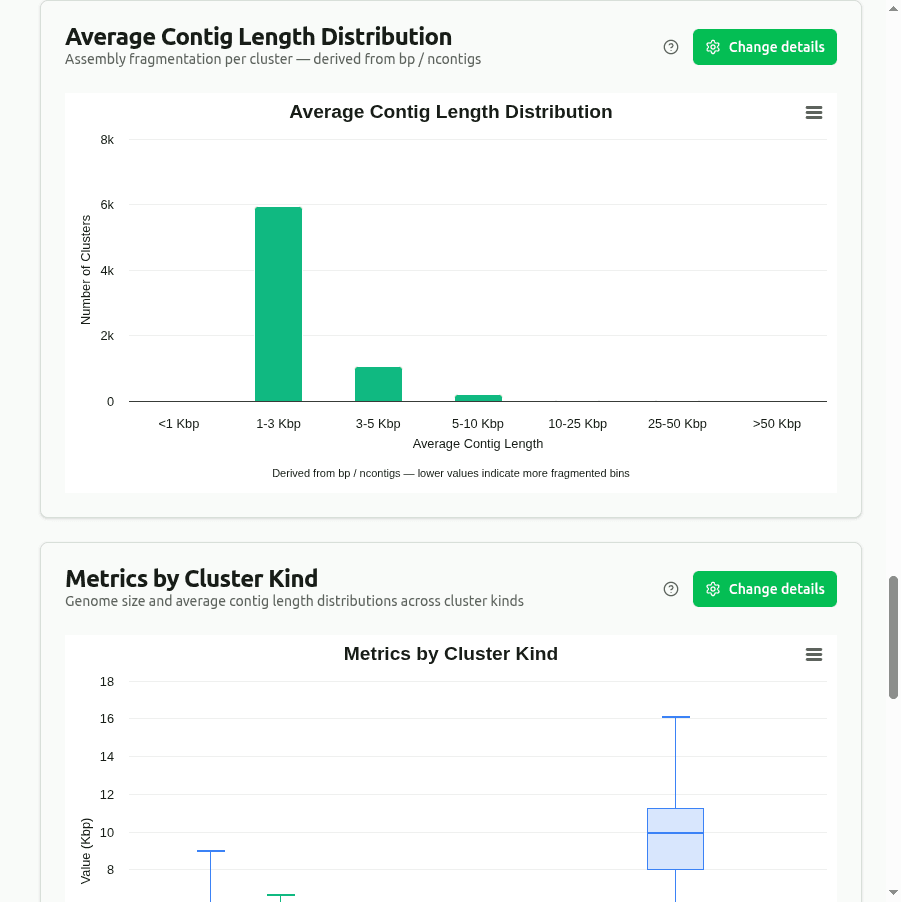
avg-contig-length
Gráfico de barras de longitud promedio de contig (bp total / ncontigs) por clúster. Los valores más altos indican genomas mejor ensamblados con contigs individuales más largos. Los promedios bajos sugieren asambleas altamente fragmentadas.
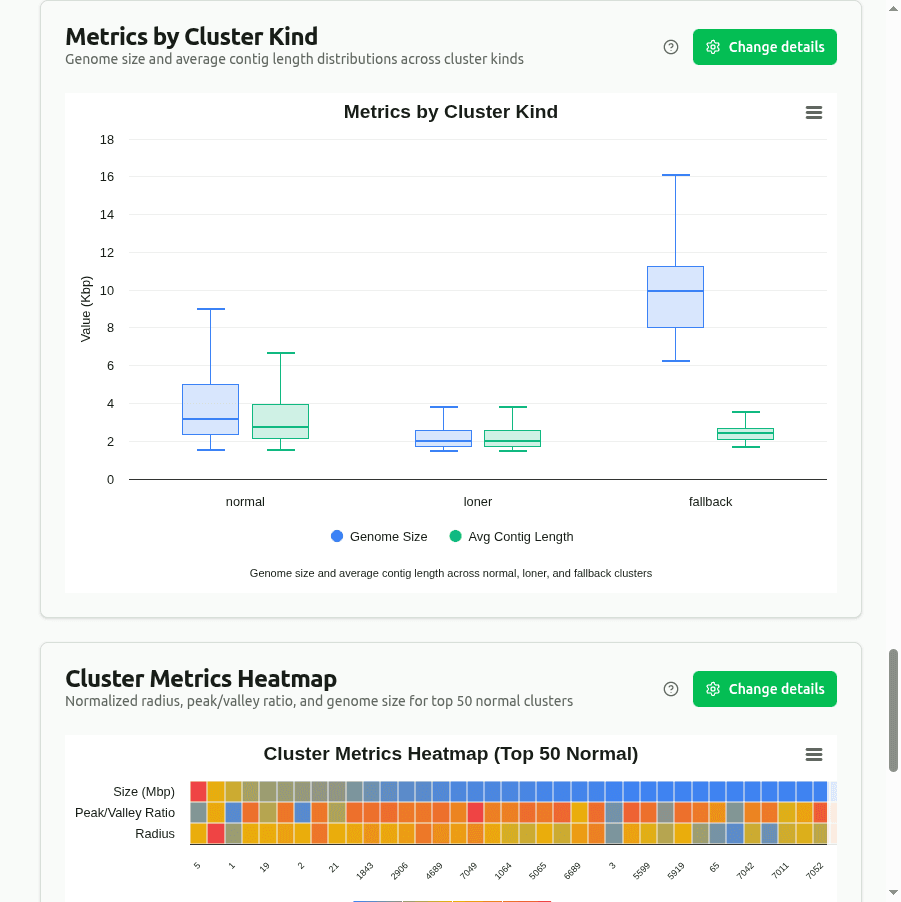
metrics-by-kind
Gráfico de caja agrupado comparando distribuciones de tamaño de genoma (bp), conteo de contigs, y radio a través de los tres tipos de clúster (normal, loner, fallback). Revela diferencias sistemáticas — p. ej., los clústeres loner tienden a ser más pequeños con contigs únicos.
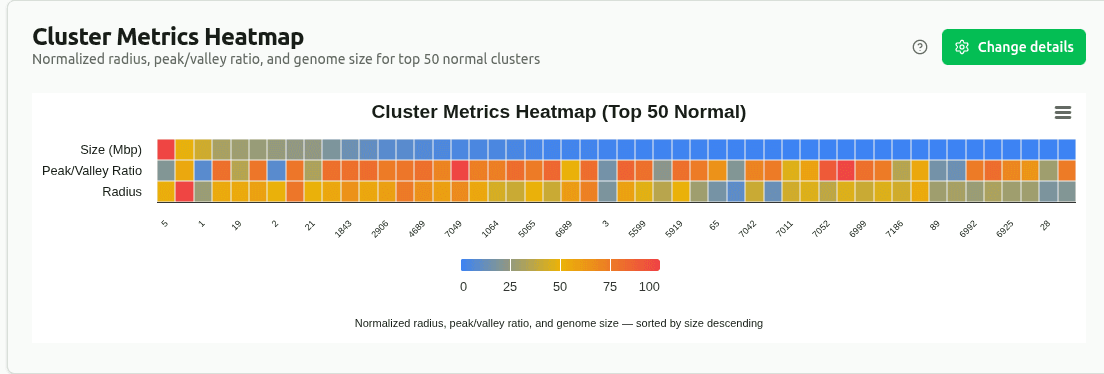
cluster-metrics-heatmap
Mapa de calor de métricas normalizadas por min-max (bp, ncontigs, radio, razón pico-a-valle) a través de los principales clústeres. Cada métrica se escala 0–1 dentro de su columna; celdas más oscuras = valores relativos más altos. Útil para detectar clústeres atípicos.
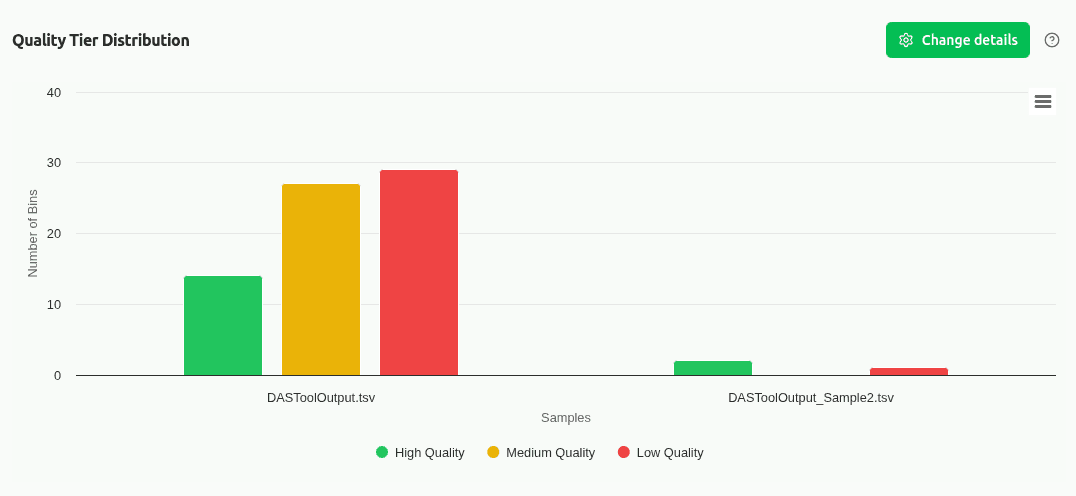
comp-quality-tiers
Gráfico de barras agrupadas comparando la distribución de niveles de calidad heurísticos (Alto / Medio / Bajo basado en umbrales de tamaño de genoma y N50) a través de muestras. Revela qué muestra produjo más clústeres VAMB de alta calidad.
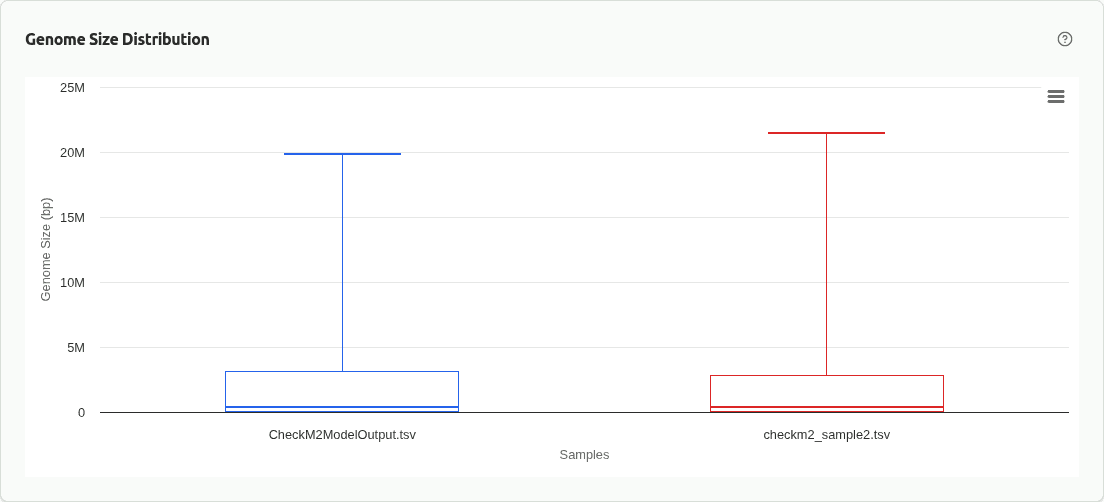
comp-genome-size
Gráfico de caja o gráfico de barras agrupadas comparando la distribución de tamaño de genoma (bp total) de clústeres VAMB a través de muestras. Las diferencias pueden reflejar complejidad comunitaria variable o profundidad de co-asamblea.
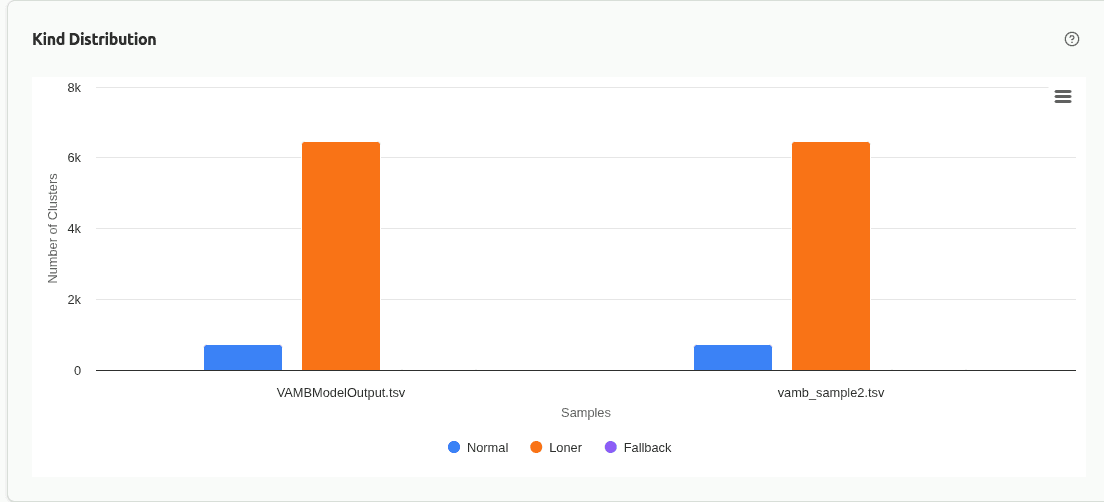
comp-kind-distribution
Gráfico de barras apilado o agrupado comparando la proporción de clústeres normal, loner y fallback a través de muestras. Una fracción más alta de clústeres normales indica mejor separación de espacio latente y binning más confiable.
comp-quality-pct
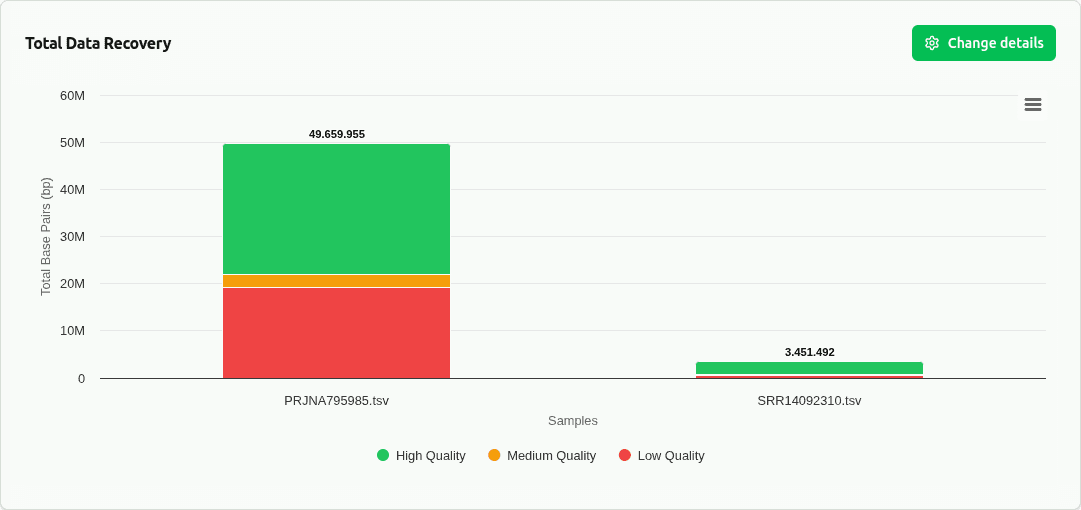
Gráfico de barras apiladas al 100% mostrando la proporción de clústeres de calidad Alto / Medio / Bajo por muestra. Normaliza por conteos de clúster diferentes, permitiendo comparación directa de calidad de binning. Estándar en evaluaciones de desafíos CAMI.
comp-cdf
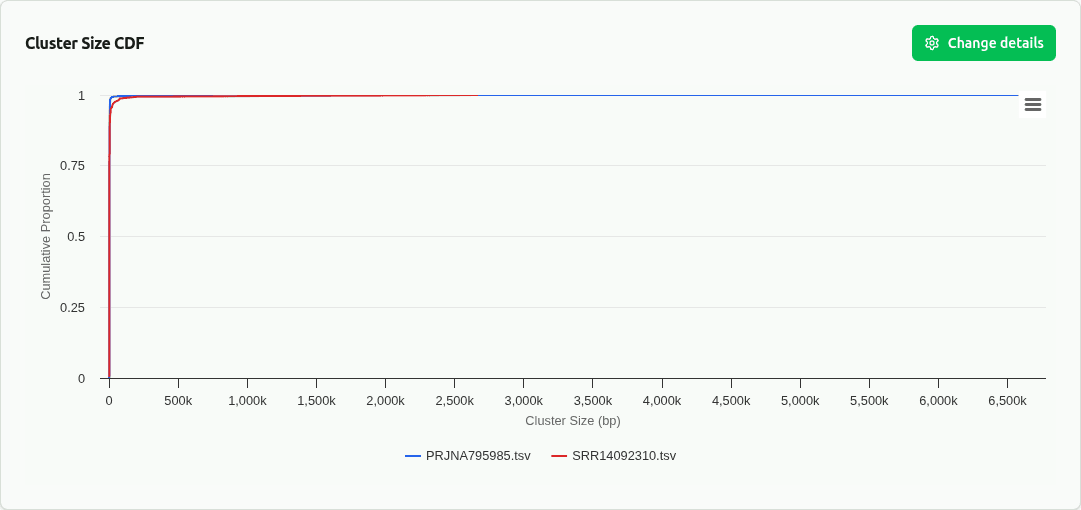
Función de distribución acumulativa empírica (CDF) de tamaños de clúster superpuestos por muestra. Revela forma de distribución completa más allá de resúmenes de gráfico de caja. Estándar en evaluación CAMI.
comp-contigs
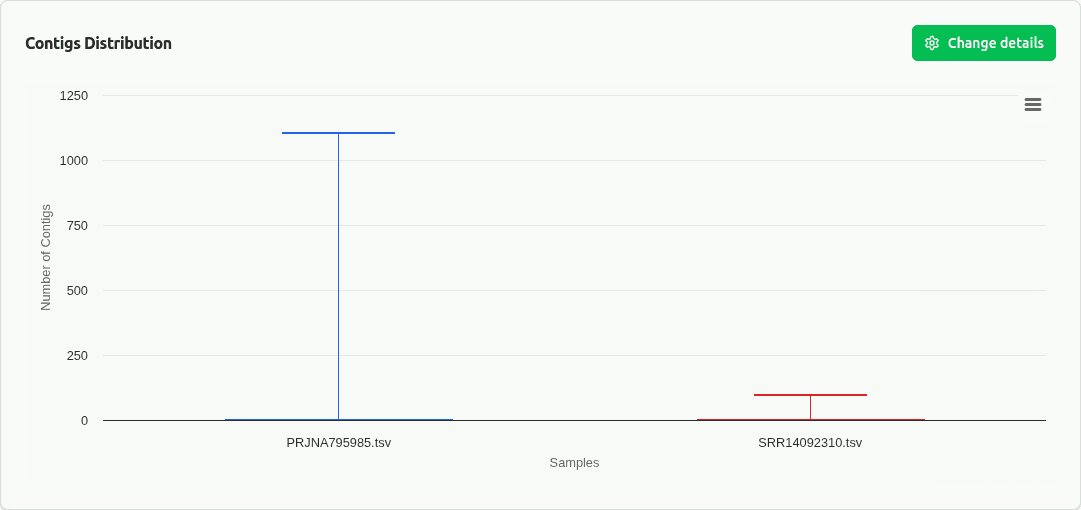
Gráfico de caja de conteo de contigs por clúster a través de muestras. Los conteos de contigs más altos indican asambleas más fragmentadas, potencialmente de profundidad de secuenciación más baja o composición comunitaria compleja.
binning-group-quality-tiers
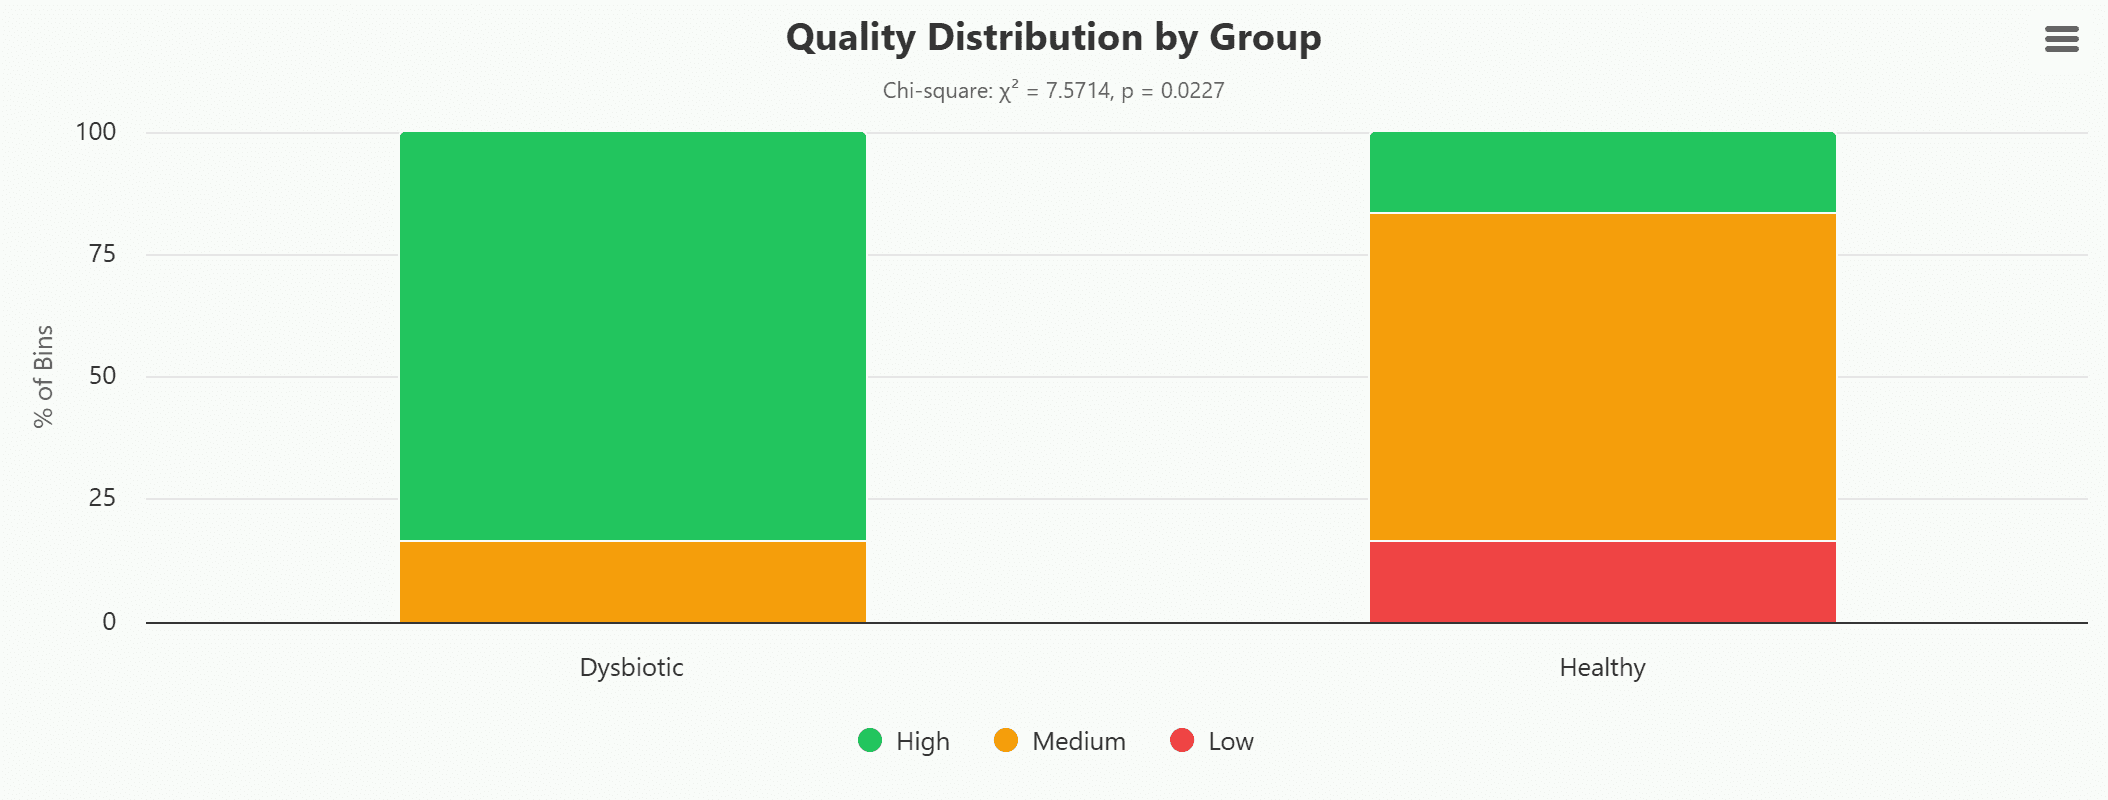
Gráfico de barras agrupadas de conteos de nivel de calidad heurísticos (Alto / Medio / Bajo) por grupo experimental, con prueba de Chi-cuadrado. Los niveles se basan en tipo de clúster y tamaño de genoma: Alto = normal + ≥500 Kbp, Medio = normal ≥100 Kbp o fallback ≥500 Kbp, Bajo = todo lo demás. Nota: estos son heurísticos de métrica de asamblea, no clasificaciones MIMAG — VAMB no produce completitud o contaminación.
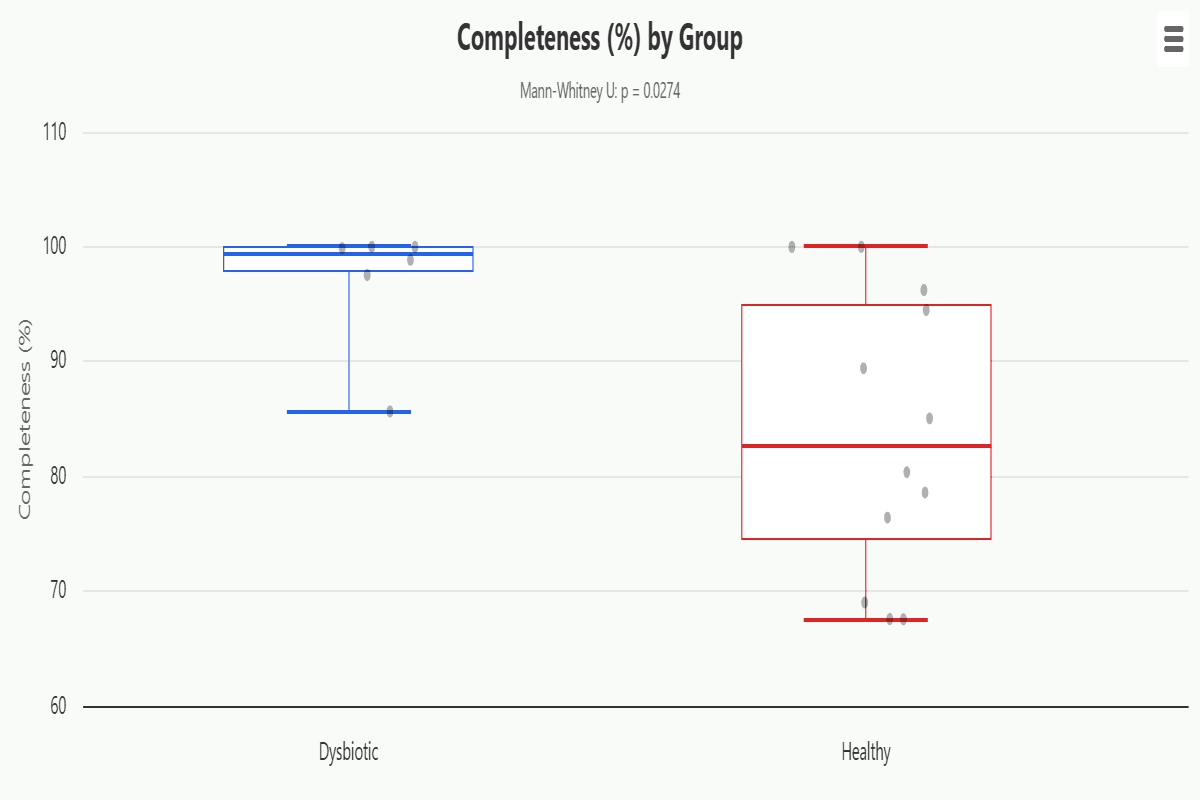
binning-group-metric-boxplots
Gráficos de caja comparando una métrica seleccionada (tamaño de genoma, conteo de contigs, radio, o razón pico-a-valle) a través de grupos. Todos los valores de clúster individuales se agrupan por grupo. La prueba de Kruskal-Wallis (≥3 grupos) o prueba de Mann-Whitney U (2 grupos) evalúa significancia; las comparaciones pareadas utilizan corrección FDR de Benjamini-Hochberg.
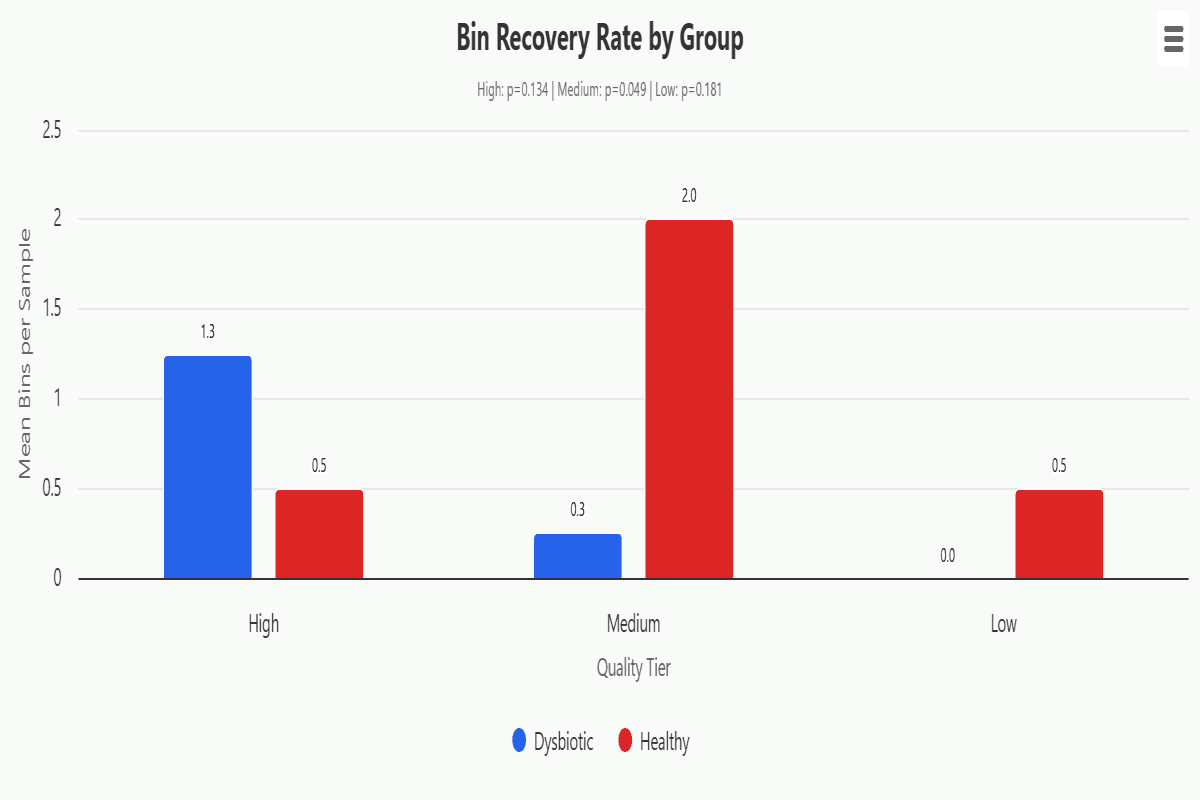
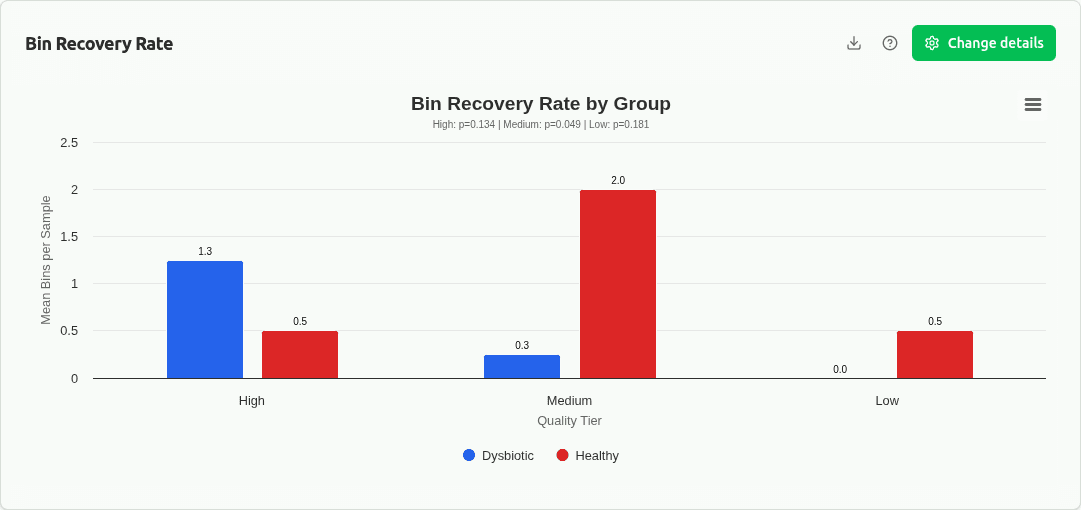
binning-group-recovery-rate
Gráfico de barras agrupadas de conteo de clúster promedio por muestra en cada nivel de calidad (Alto, Medio, Bajo, Total) a través de grupos, con barras de error mostrando ±1 DE. Prueba si los grupos experimentales difieren en cuántos clústeres VAMB recuperan en cada nivel de calidad.
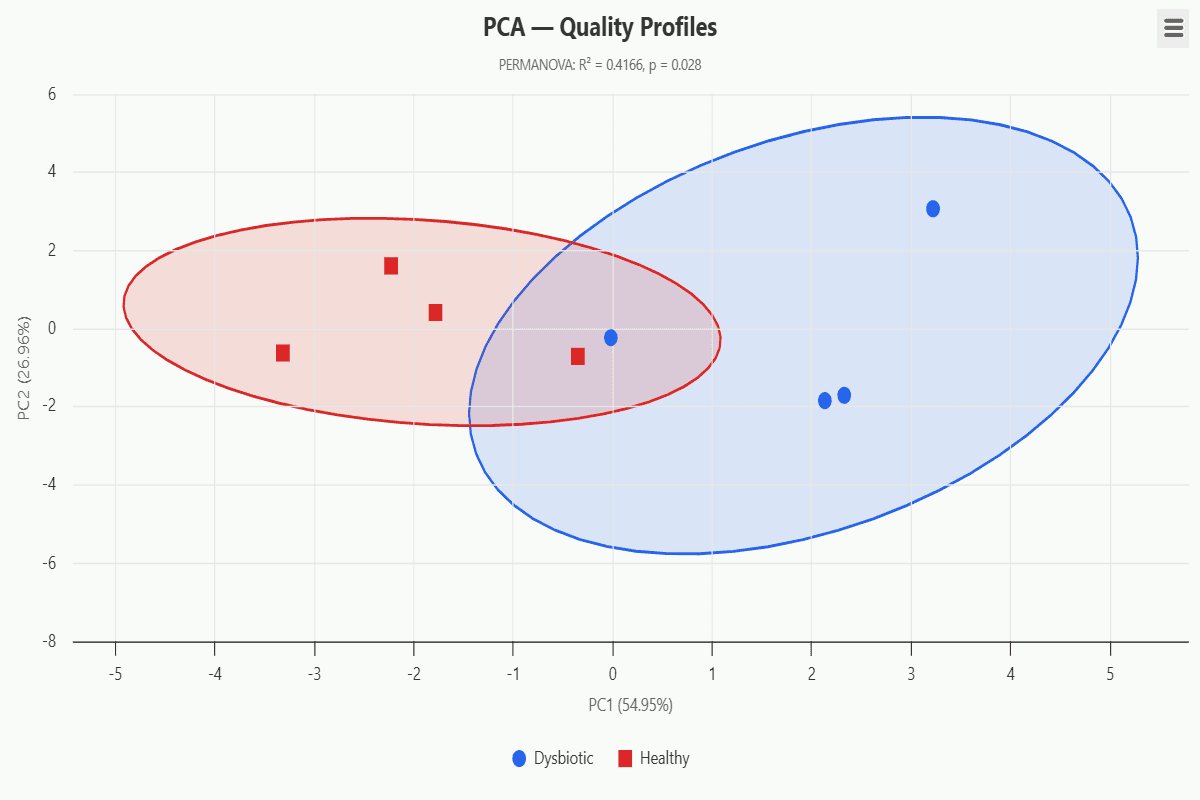
binning-group-pca
Ordenación PCA de perfiles de calidad por muestra (tamaño de genoma promedio, conteo de contigs, radio, razón pico-a-valle, %normal, %loner, %fallback, %HQ). Las características se estandarizan por puntuación z antes de descomposición. PERMANOVA en la matriz de distancia euclidiana prueba si los centroides de grupo difieren significativamente. Se dibujan elipses de confianza del 95% para grupos con ≥3 muestras.
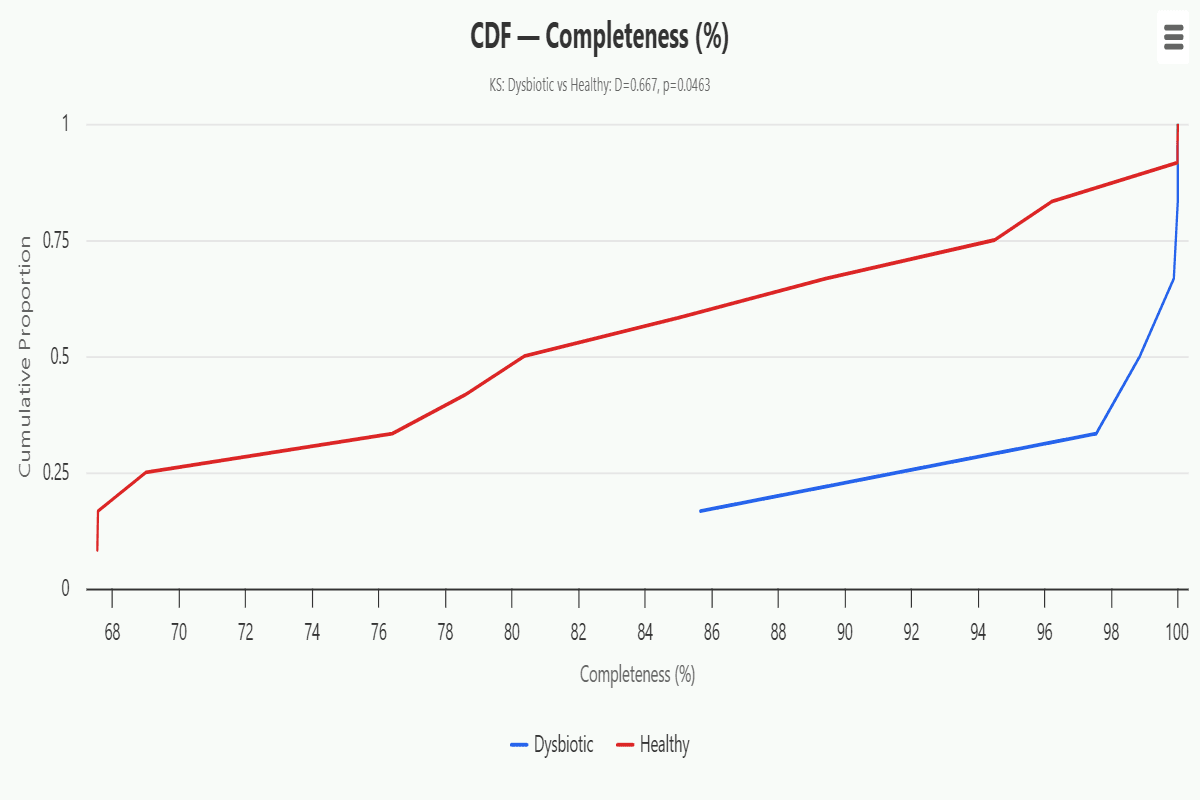
binning-group-cdf
Funciones de distribución acumulativa empírica (CDFs) superpuestas de una métrica seleccionada a través de grupos. La prueba de Kolmogorov-Smirnov de dos muestras cuantifica la distancia vertical máxima entre curvas — las estadísticas D significativas indican que las distribuciones de métrica de los grupos difieren en ubicación, dispersión o forma.
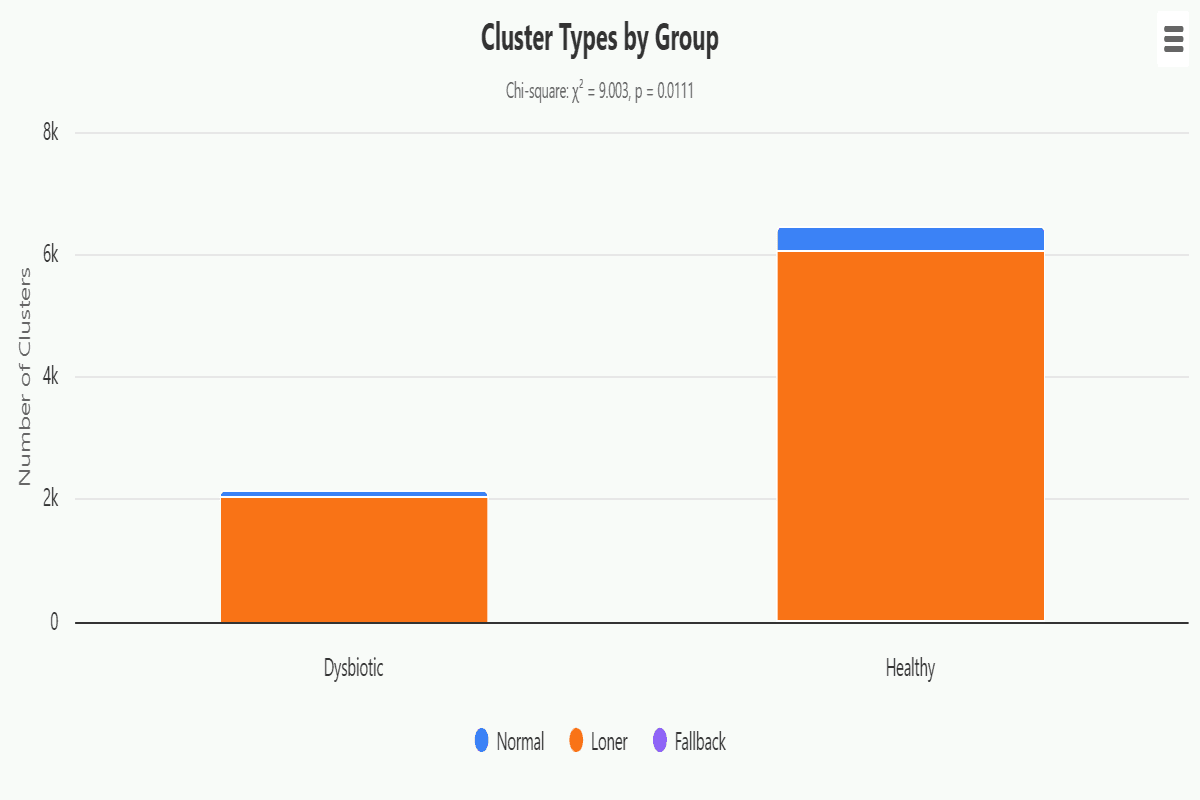
binning-group-cluster-types
Gráfico de barras apiladas de conteos de tipo de clúster (Normal / Loner / Fallback) por grupo, con prueba de Chi-cuadrado. Estos tres tipos de clúster son definidos por agrupamiento de pico de densidad de espacio latente de VAMB. Los valores p significativos sugieren que las condiciones experimentales influyen en la proporción de clústeres bien separados versus mal resueltos.
binning-group-total-recovery
Gráfico de barras apiladas de pares de bases totales medios recuperados por grupo, divididos por nivel de calidad. Las barras de error muestran ±1 DE. Mide el volumen de datos real binned por grupo, complementando gráficos de conteo de clúster y tasa de recuperación.