Análise de Comunidade de Microbioma
Análise de ComunidadeAnálise de comunidade de dados de censo de microbioma — uma tabela de abundância OTU/ASV, uma tabela de taxonomia e uma tabela de metadados da amostra — para composição, diversidade alfa e beta, ordenação e co-ocorrência. As três tabelas são a saída padrão de qualquer pipeline de amplicon ou metagenômica (QIIME 2, DADA2, mothur, USEARCH/VSEARCH, MetaPhlAn); traga-as de qualquer um que você tenha executado. [1]
Como Obter o Arquivo de Saída do Modelo
Abaixo está um breve fluxo de trabalho que a equipe executou para obter os exemplos de arquivo de saída que apresentamos na página de ferramentas.
Entrada
Uma tabela de features OTU/ASV + uma tabela de taxonomia + uma tabela de metadados de amostra (CSV/TSV) — exportada de QIIME 2, DADA2, mothur ou qualquer pipeline; por ex., o exemplo CARBOM incluído (metabarcoding 18S, 205 táxons × 54 amostras)
Saída
Três tabelas CSV/TSV carregadas no IntMeta — uma tabela de abundância OTU/ASV (táxons × amostras), uma tabela de taxonomia (id de táxon + ranks como Domain … Genus) e uma tabela de metadados de amostra (amostra + variáveis)
conda install -c bioconda bioconductor-phyloseq
Exporte a tabela de features e taxonomia de seus artefatos QIIME 2 (.qza) e converta a tabela de features para TSV. O TSV de metadados de amostra que você já usa no QIIME 2 é o terceiro arquivo, inalterado. Ver QIIME 2 — exporting data.
- 1
Exportar a tabela de features e converter para TSV
qiime tools export --input-path table.qza --output-path exported/
biom convert -i exported/feature-table.biom -o otu_table.tsv --to-tsv
Exclua a linha de comentário de liderança "# Constructed from biom file" de otu_table.tsv antes do upload, para que a linha de cabeçalho comece com a coluna de id de táxon.
- 2
Exportar a taxonomia
qiime tools export --input-path taxonomy.qza --output-path exported/
Produz exported/taxonomy.tsv (ID de Feature + Táxon + Confiança). Opcionalmente divida a string Táxon em uma coluna por rank.
- 3
Use seus metadados de amostra como estão
# sample-metadata.tsv — first column = sample id, remaining columns = variables
O mesmo TSV de metadados que você passou para QIIME 2 é o terceiro arquivo de upload.
Materiais Utilizados
Arquivos de Saída de Exemplo
Baixe os arquivos de saída usados nas demonstrações da página de ferramentas. Você pode enviá-los diretamente para IntMeta para explorar as visualizações.
Única & Comparação
Referência de Gráficos
Descrições detalhadas para todas as 6 visualizações geradas por Análise de Comunidade de Microbioma em IntMeta.
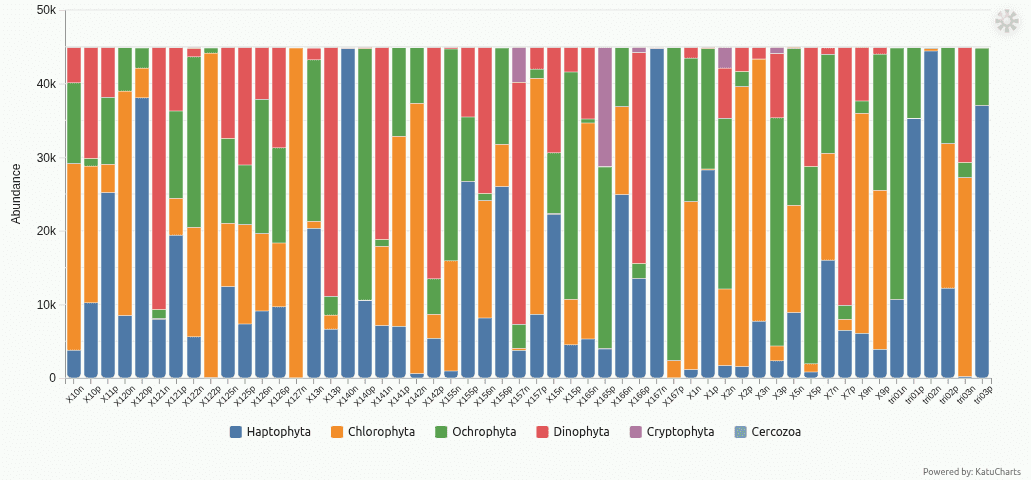
composition
Gráfico de barras empilhadas por amostra de abundância relativa em um rank taxonômico escolhido. Cada barra é uma amostra — ou um conjunto de amostras mescladas por uma variável de metadados — dividida em segmentos coloridos para os táxons mais abundantes, revelando como a composição da comunidade muda entre sítios, profundidades ou frações.
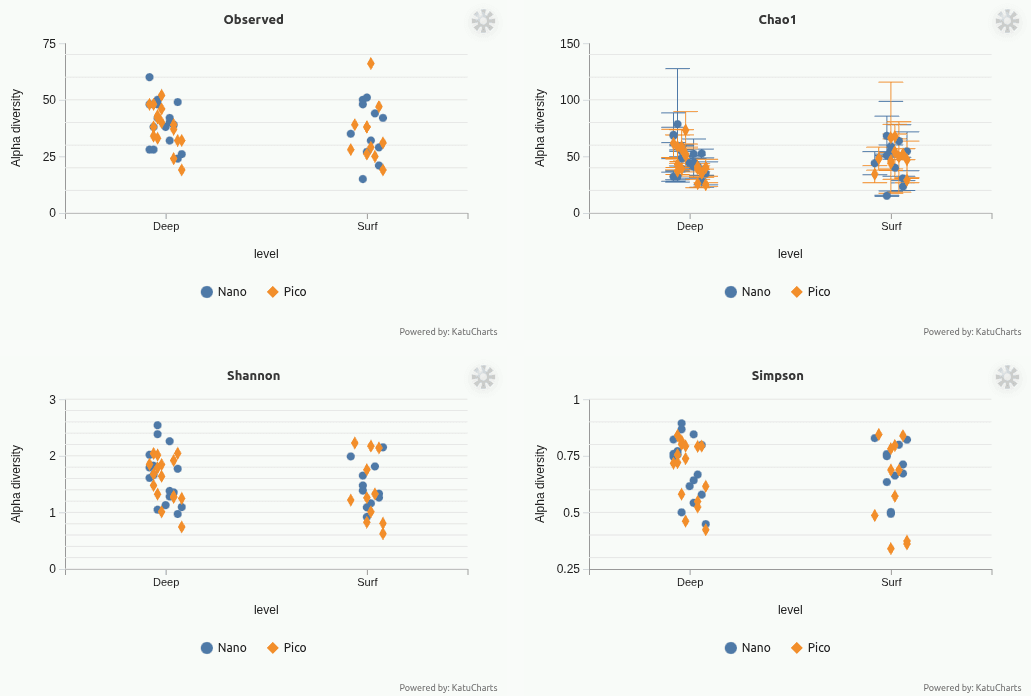
alpha-diversity
Diversidade intra-amostra como um ponto por amostra com intervalo de confiança, facetado por medida: riqueza Observada, Chao1 (com seu erro padrão desenhado como barras de erro com límite), entropiaShannon e índice Simpson. Os pontos ficam ao longo de uma variável de metadados categórica escolhida e são coloridos por uma segunda, assim efeitos de tratamento ou profundidade sobre diversidade se destacam.
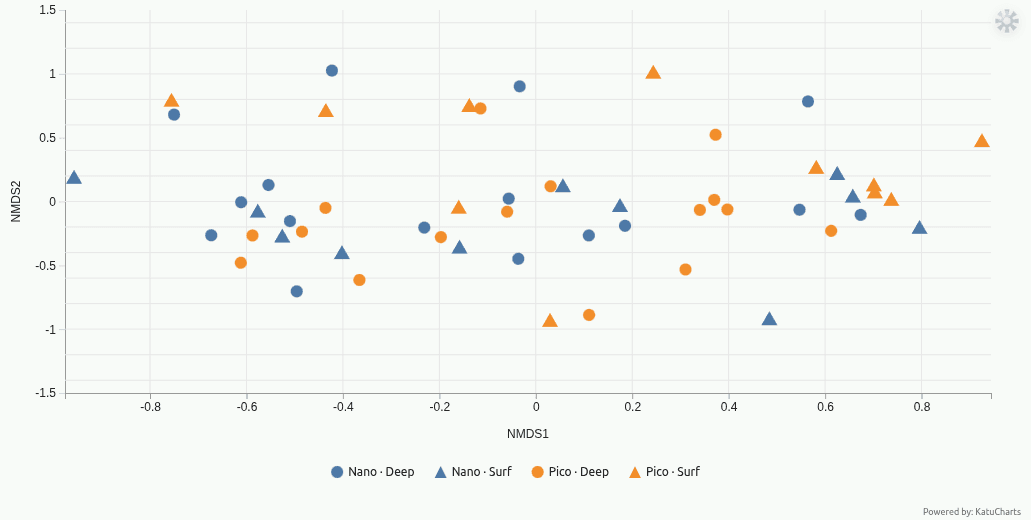
ordination-samples
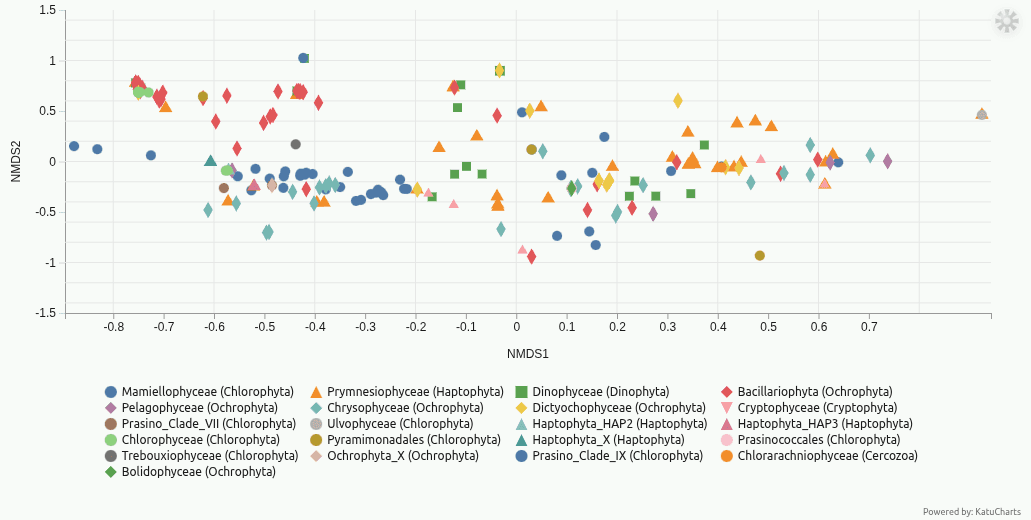
Ordenação de diversidade beta de amostras (NMDS ou PCoA) calculada em uma matriz de distância Bray-Curtis ou Jaccard. Cada ponto é uma amostra, colorida e moldada por variáveis de metadados; pontos próximos têm comunidades similares. Elipses de confiança de 95% opcionais resumem grupos.
ordination-taxa
A mesma ordenação projetada sobre táxons: cada ponto é um táxon colocado por seu escore de média ponderada, colorido por um rank e moldado por outro. Destaca quais táxons direcionam a separação entre amostras e como ranks superiores se agrupam em espaço de comunidade.
heatmap
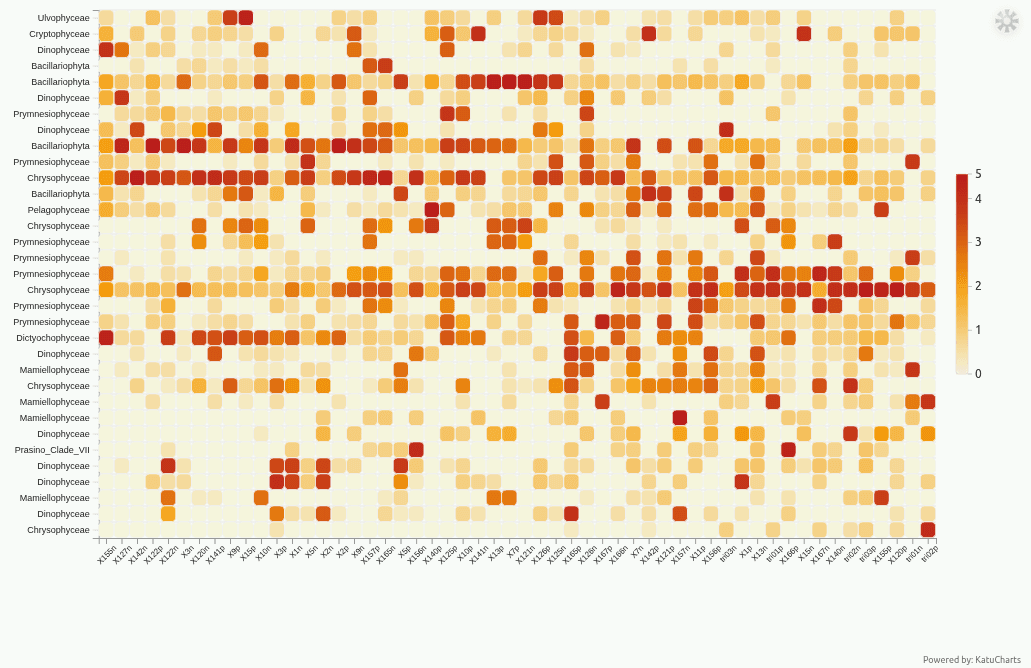
Mapa de calor de abundância dos táxons mais abundantes (linhas) entre amostras (colunas), com linhas e colunas ordenadas pela ordenação para que táxons co-ocorrentes e amostras similares fiquem juntos. A cor da célula codifica abundância em escala bege-para-vermelho; um limite de abundância controla quantos táxons são mostrados.
network
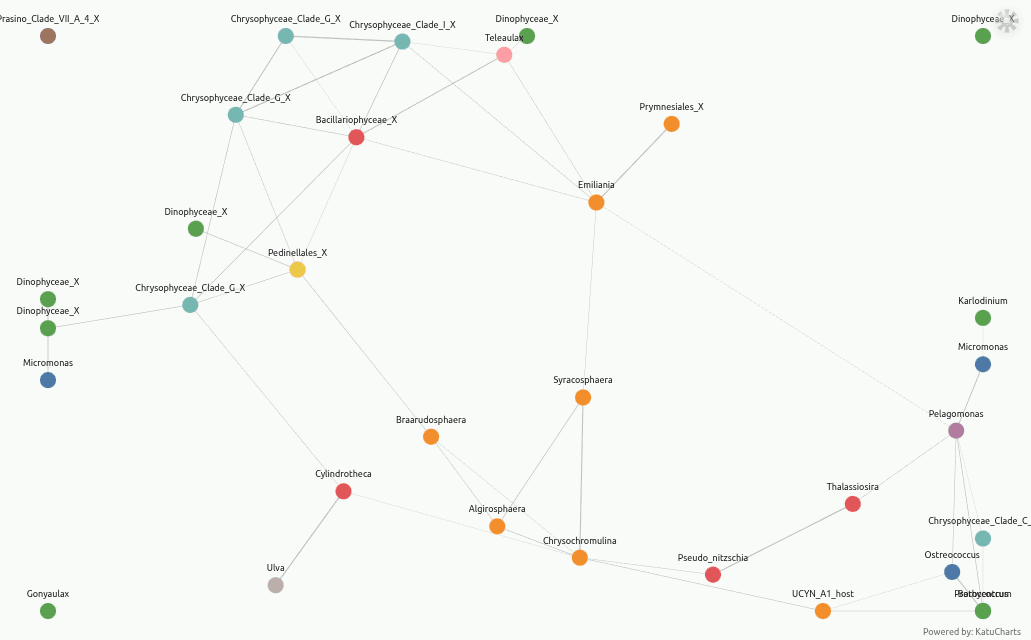
Rede de co-ocorrência dos táxons abundantes: nós são táxons (coloridos por um rank escolhido, rotulados por outro) vinculados quando seus perfis de abundância são similares — distância abaixo de um limite ajustável. A largura da aresta escala com closeness, nós são arrastáveis e rótulos são espalhados automaticamente para permanecer legíveis.