CheckM2
Binagem de MetagenômicaCheckM2 é uma ferramenta rápida baseada em aprendizado de máquina para avaliar a qualidade de genomas montados de metagenomas (MAGs). Usa modelos de gradiente potencializado treinados em características genômicas para prever completude e contaminação sem exigir genomas de referência. [1]
Como Obter o Arquivo de Saída do Modelo
Abaixo está um breve fluxo de trabalho que a equipe executou para obter os exemplos de arquivo de saída que apresentamos na página de ferramentas.
Entrada
Diretório de bins de genoma em formato FASTA (.fa, .fna, .fasta)
Saída
Arquivo TSV com métricas de qualidade por bin: completude, contaminação, densidade de codificação, conteúdo GC, tamanho do genoma, N50, contagem de contigs
conda install -c bioconda checkm2
Imagem Docker: nanozoo/checkm2:latest
Amostra 1 21 bins montados de metagenoma da co-montagem de microbioma intestinal PRJNA795985 avaliados com CheckM2 usando o Banco de dados.
- 1
Baixar 3 amostras do PRJNA795985
for SRR in SRR17531757 SRR17531762 SRR17531772; do fastq-dump --split-files --gzip -X 1000000 --outdir reads/ $SRR; done
1M pares de leituras por amostra de "Diet and Antimicrobial Resistance in Healthy US Adults" (Shrestha et al., mBio 2022).
- 2
Co-montar com MEGAHIT
megahit -1 reads/SRR17531757_1.fastq.gz,reads/SRR17531762_1.fastq.gz,reads/SRR17531772_1.fastq.gz -2 reads/SRR17531757_2.fastq.gz,reads/SRR17531762_2.fastq.gz,reads/SRR17531772_2.fastq.gz -o assembly --min-contig-len 1500 -t 8
A co-montagem produz 14.934 contigs (≥1.500 pb).
- 3
Mapear cada amostra para contigs
for SRR in SRR17531757 SRR17531762 SRR17531772; do minimap2 -ax sr -t 8 assembly/final.contigs.fa reads/${SRR}_1.fastq.gz reads/${SRR}_2.fastq.gz | samtools sort -@ 4 -o bams/${SRR}.sorted.bam && samtools index bams/${SRR}.sorted.bam; doneProduz alinhamentos BAM por amostra necessários para binning.
- 4
Binnar contigs
vamb bin default --outdir vamb_out --fasta assembly/final.contigs.fa --bamdir bams/ -m 1500 --minfasta 200000 -p 8
Produz 21 arquivos FASTA de bin (≥200 Kbp).
- 5
Baixar banco de dados CheckM2
checkm2 database --download --path checkm2_db/
Baixa o banco de dados DIAMOND (uniref100.KO.1.dmnd, ~1,74 GB).
- 6
Executar CheckM2 em todos os 21 bins
checkm2 predict --input bins/ --output-directory checkm2_output/ -x fna --threads 8 --database_path checkm2_db/uniref100.KO.1.dmnd
Produz quality_report.tsv com completude, contaminação, densidade de codificação, conteúdo GC, N50 e tamanho de genoma para todos os 21 bins.
Materiais Utilizados
Arquivos de Saída de Exemplo
Baixe os arquivos de saída usados nas demonstrações da página de ferramentas. Você pode enviá-los diretamente para IntMeta para explorar as visualizações.
Única & Comparação
Análise de Grupo
Referência de Gráficos
Descrições detalhadas para todas as 32 visualizações geradas por CheckM2 em IntMeta.
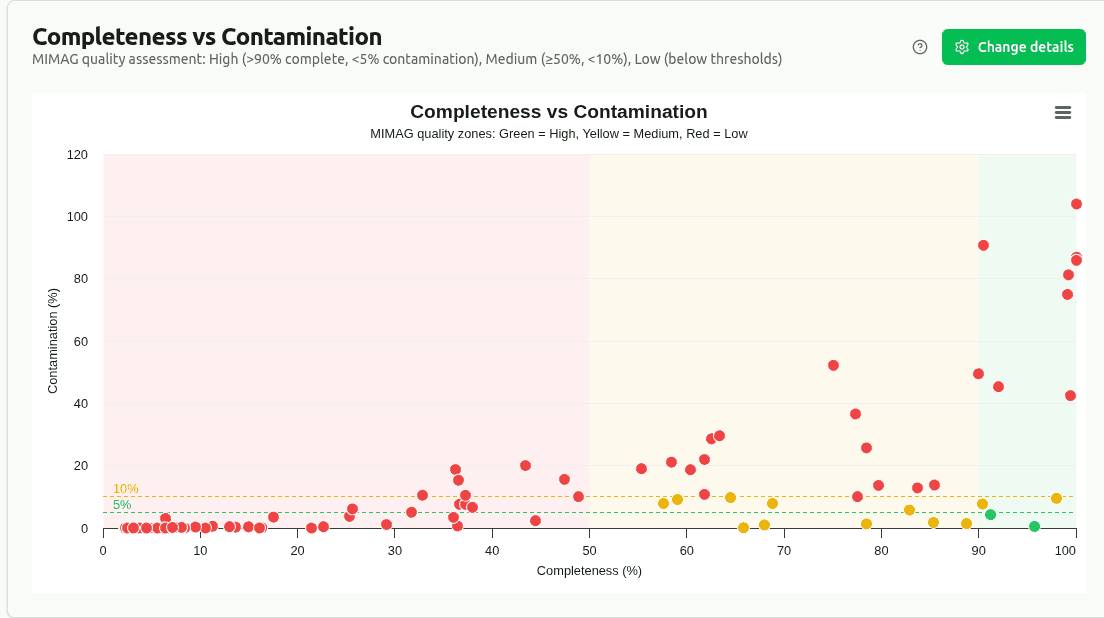
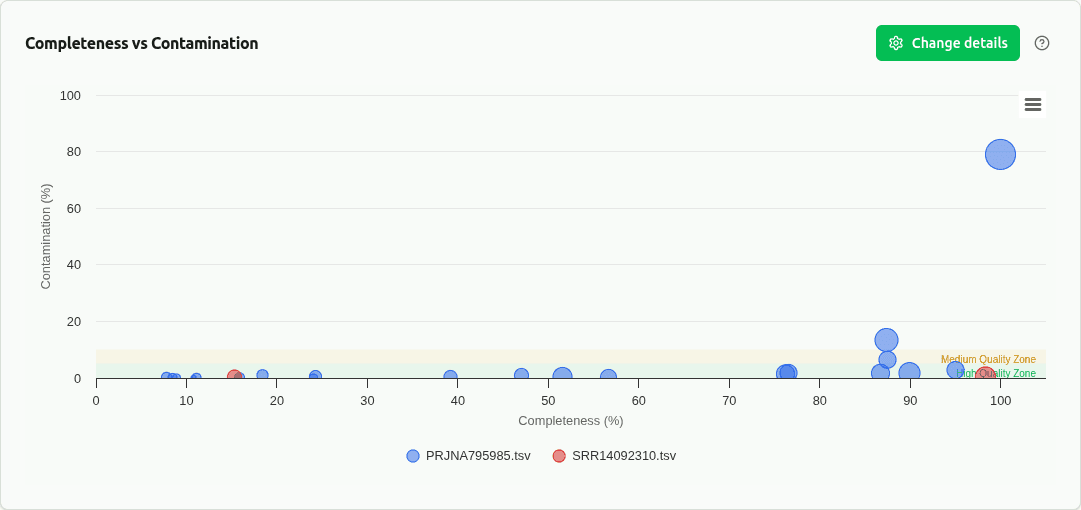
completeness-vs-contamination
Gráfico de dispersão de completude (%) prevista por ML versus contaminação (%) para cada bin, colorido por nível de qualidade MIMAG. Os bins ideais ficam no canto superior esquerdo. As linhas tracejadas marcam limites MIMAG: Alta qualidade (>90% completo, <5% contaminação) e Qualidade Média (≥50% completo, <10% contaminação).
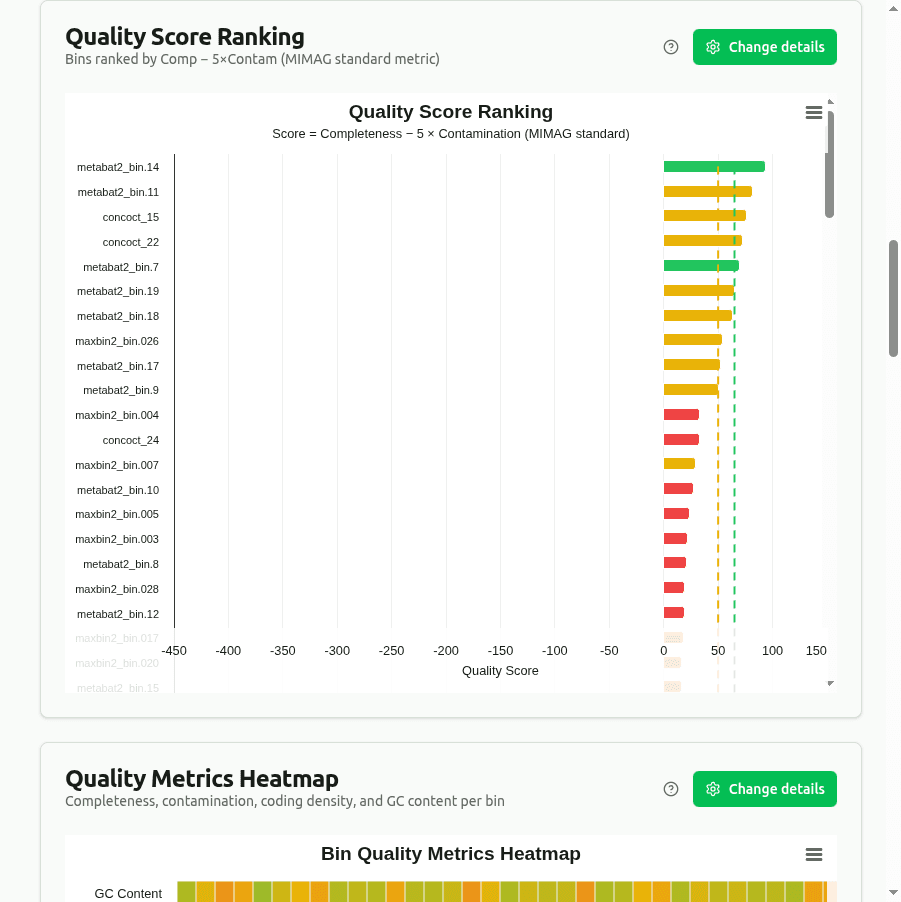
quality-score-ranking
Gráfico de barras horizontal classificando bins por escore de qualidade composto = Completude − 5 × Contaminação (fórmula padrão MIMAG). Um bin com 95% completude e 2% contaminação marca 85. A cor reflete o nível de qualidade MIMAG (Alto / Médio / Baixo).
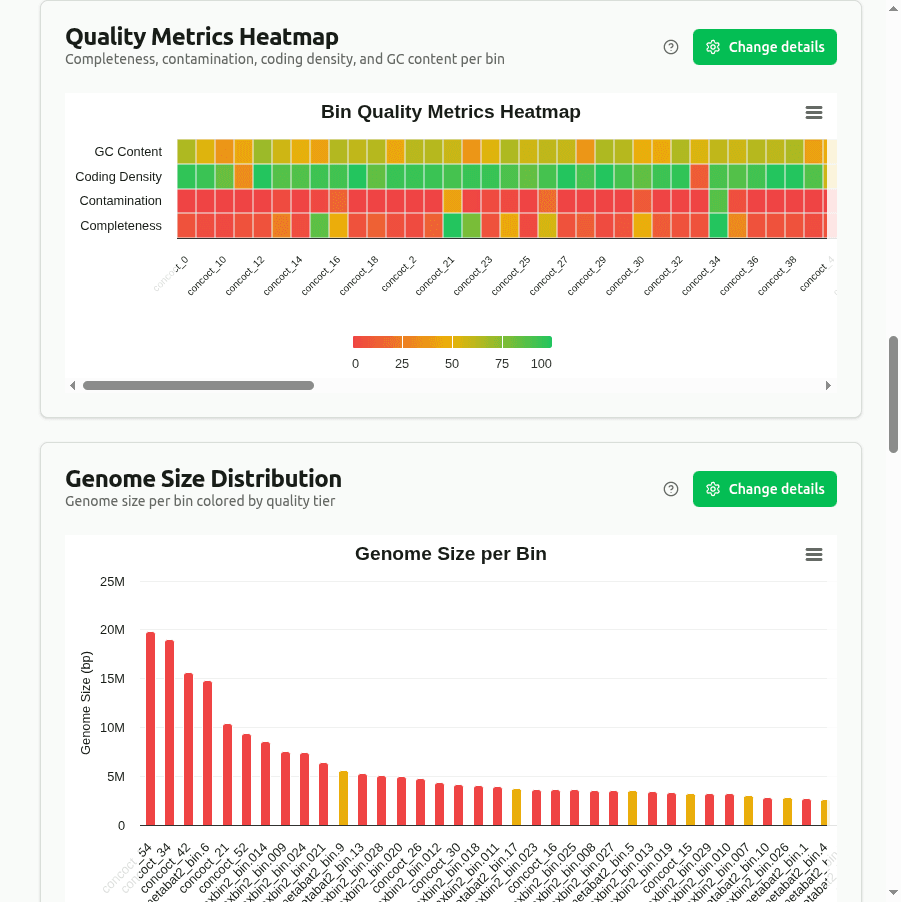
quality-metrics-heatmap
Mapa de calor de valores normalizados min-max de Completude, Contaminação, Densidade_de_Codificação e Conteúdo_GC entre todos os bins. Cada métrica é escalada 0–1 dentro de sua coluna; células mais escuras indicam valores relativos mais altos. Útil para detectar bins outlier rapidamente.
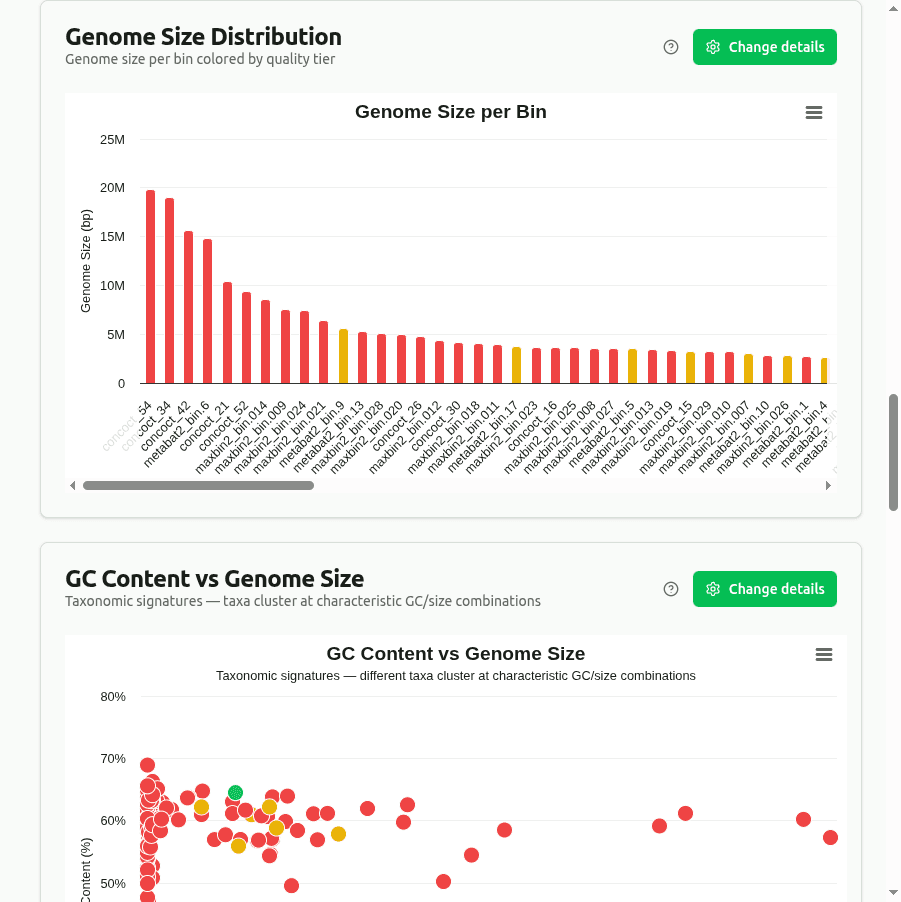
genome-size-distribution
Gráfico de barras do Tamanho_do_Genoma (Mbp) por bin, ordenado por tamanho e colorido por nível de qualidade MIMAG. As linhas de referência tracejadas indicam intervalos típicos de tamanho de genoma bacteriano (a maioria tem 1–8 Mbp). Bins inusitadamente pequenos ou grandes podem precisar de inspeção manual.
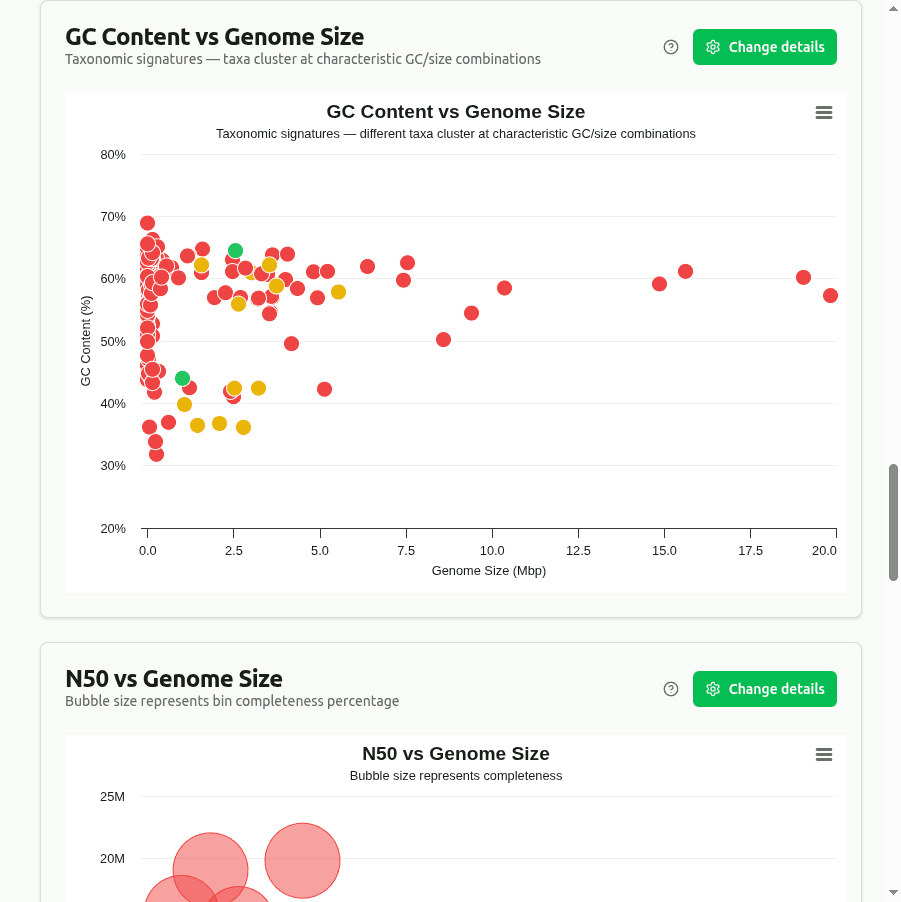
gc-content-vs-genome-size
Gráfico de dispersão de Conteúdo_GC (%) versus Tamanho_do_Genoma. Diferentes táxons se agrupam em combinações características de GC/tamanho — por ex., Firmicutes tendem para 30–40% GC enquanto Actinobacteria frequentemente excedem 60%. Posições outlier podem indicar bins quiméricos misturando contigs de organismos não relacionados.
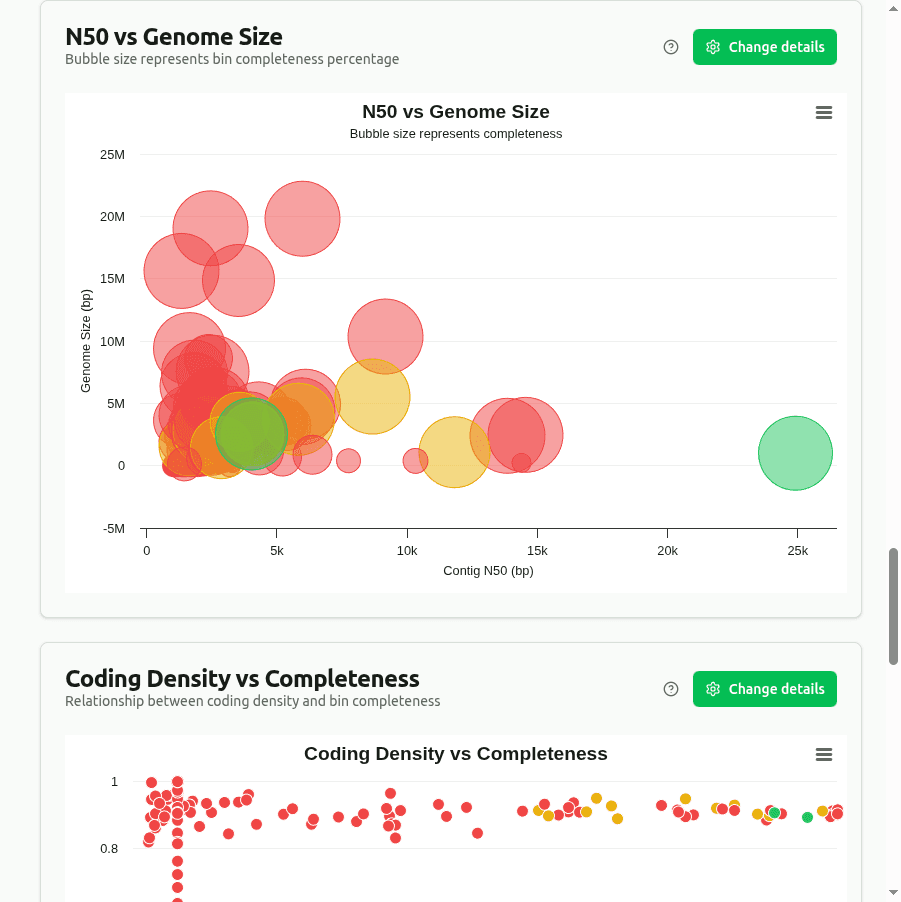
n50-vs-genome-size
Gráfico de bolhas onde X = Tamanho_do_Genoma, Y = N50_do_Contig (metade do comprimento da montagem está em contigs ≥ este tamanho), e diâmetro da bolha = Completude (%). As bolhas maiores no topo-direito representam genomas bem montados e completos.
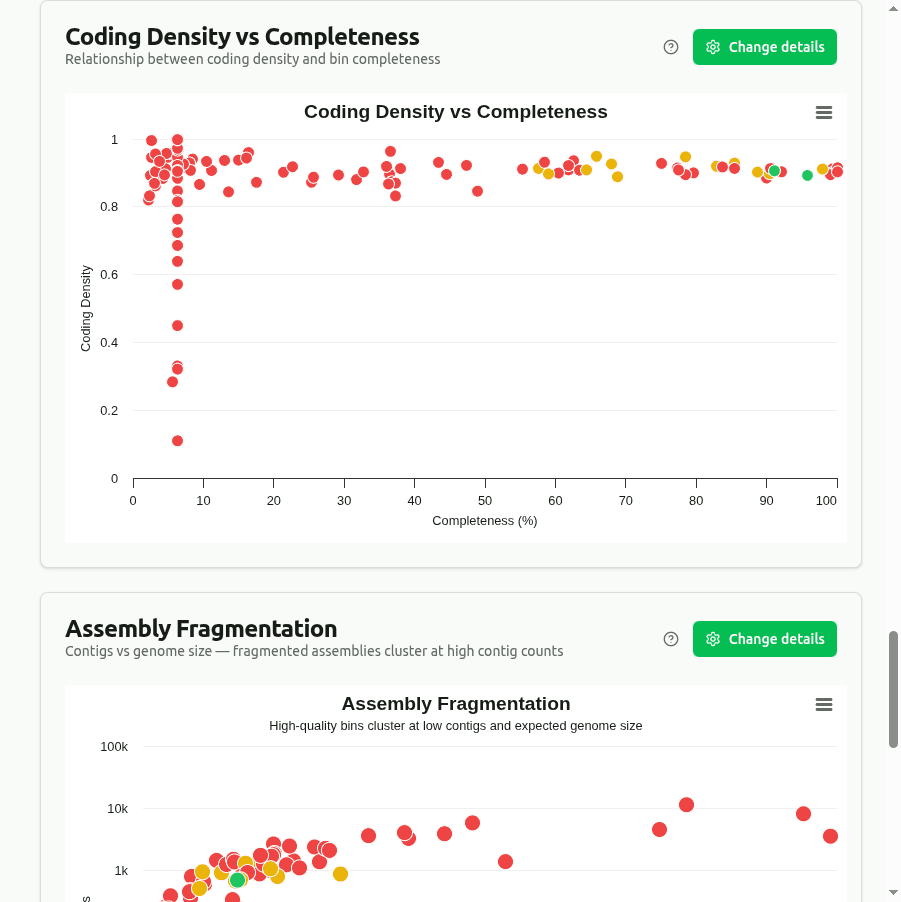
coding-density-vs-completeness
Gráfico de dispersão de Densidade_de_Codificação (fração de bases em sequências de codificação) versus Completude, colorido por nível de qualidade. A maioria dos genomas procarióticos tem densidade de codificação entre 85–95%. Densidade de codificação baixa combinada com completude alta pode sinalizar contaminação com DNA não-codificante.
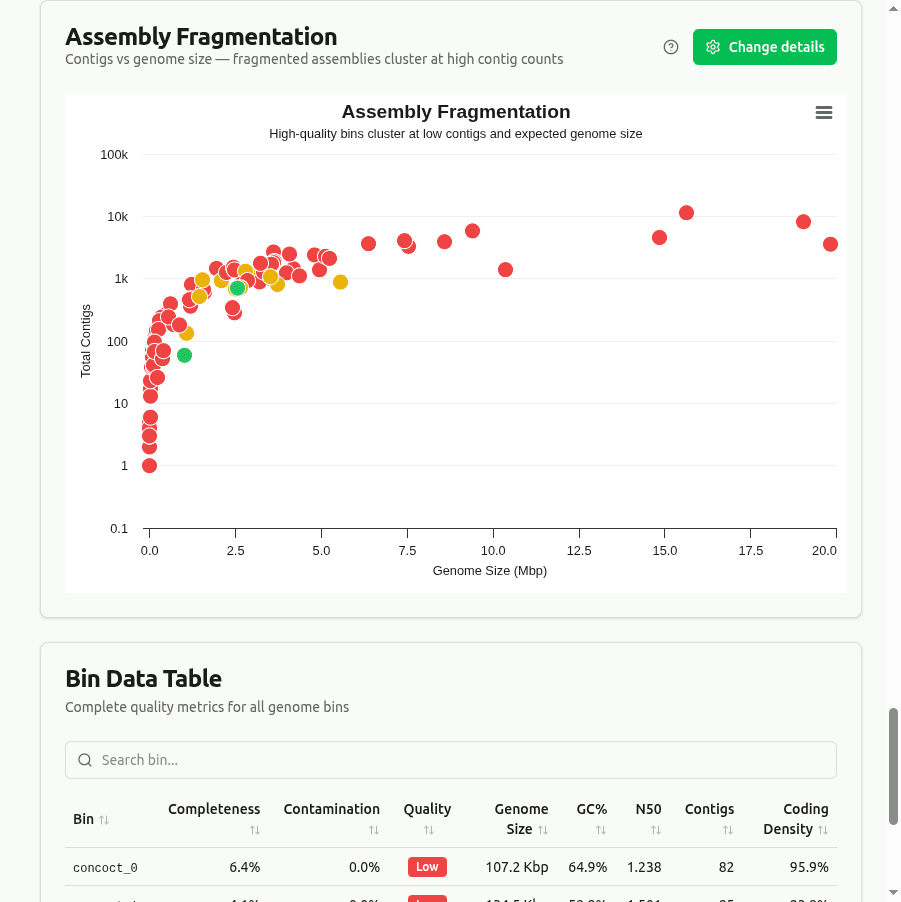
assembly-fragmentation
Gráfico de dispersão de Total_de_Contigs (contagem de contig) versus Tamanho_do_Genoma. As montagens altamente fragmentadas aparecem no canto superior esquerdo (muitos contigs, genoma pequeno). Os genomas bem montados se agrupam no canto inferior-direito (poucos contigs, genoma grande). A fragmentação afeta análises posteriores como predição de genes.
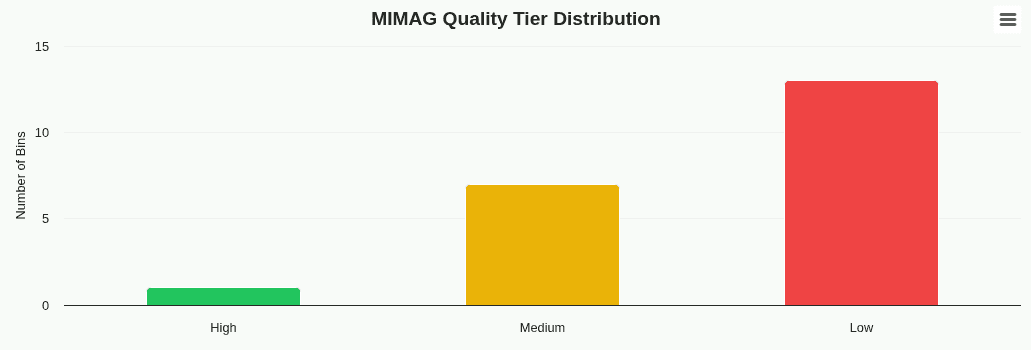
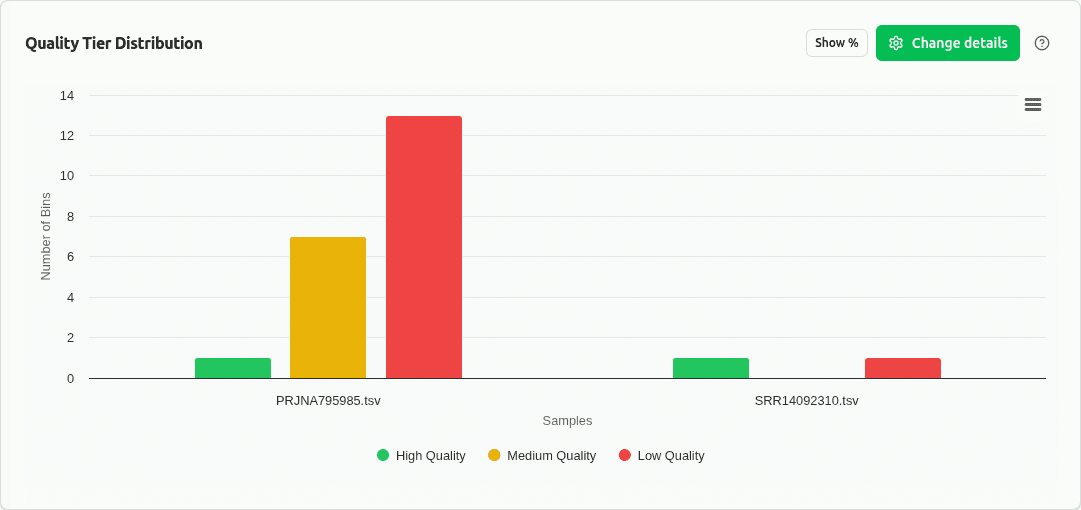
quality-tier-distribution
Gráfico de barras contando bins em cada nível de qualidade MIMAG: Alto (>90% completude, <5% contaminação), Médio (≥50% completude, <10% contaminação), Baixo (abaixo de ambos os limites). O gráfico de resumo mais comum em publicações de MAG.
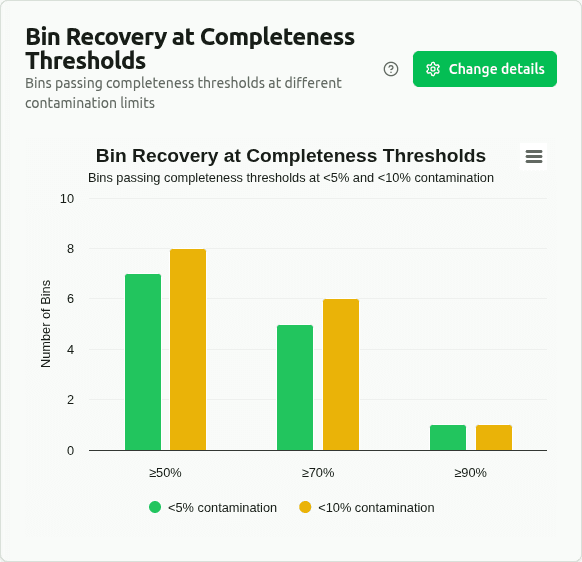
completeness-threshold-recovery
Gráfico de barras agrupadas mostrando quantos bins passam em ≥50% / ≥70% / ≥90% completude em limites de <5% e <10% contaminação. Visualização de benchmarking padrão de desafios CAMI, DAS Tool, SemiBin2 e artigos VAMB.
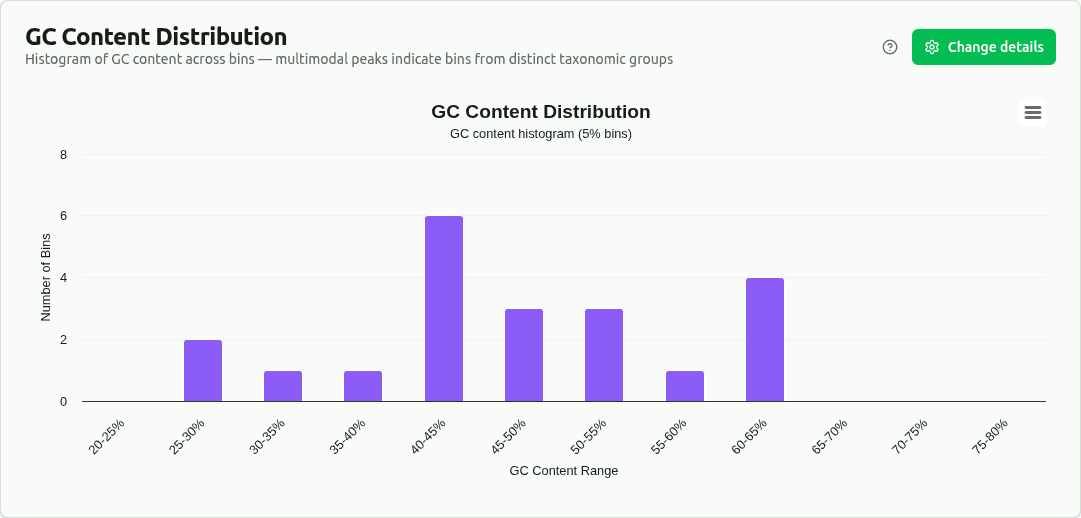
gc-content-histogram
Histograma de conteúdo GC em compartimentos de 5%. Distribuições bimodais ou multimodais sugerem recuperação de MAGs de grupos taxonômicos distintos, pois diferentes táxons tendem a se agrupar em intervalos GC característicos.
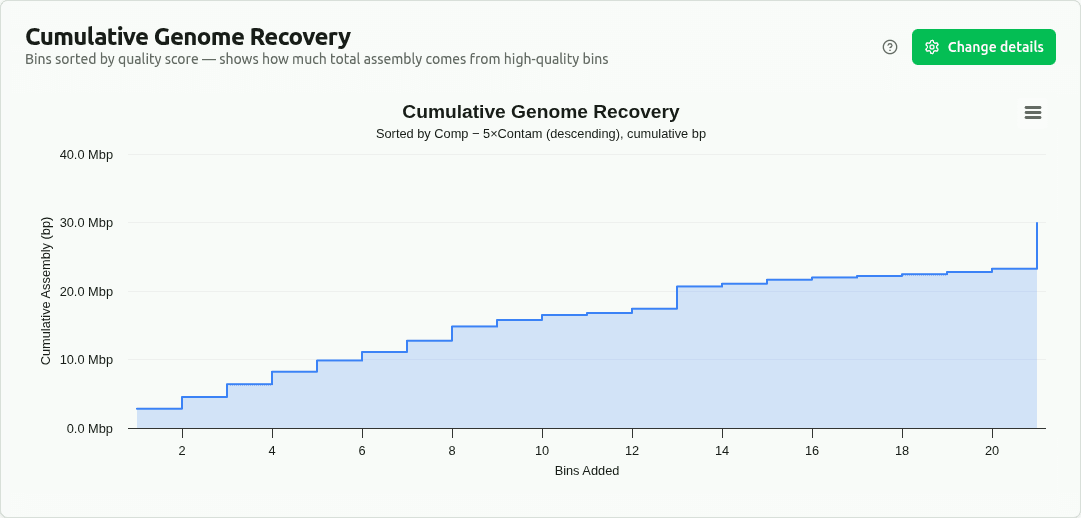
cumulative-genome-recovery
Gráfico de área escalonada cumulativa com bins ordenados por escore de qualidade (Completude − 5×Contaminação, descendente). O eixo y mostra total executivo de tamanho de genoma em bp. Uma ascensão inicial abrupta indica que a maioria da sequência montada vem de bins de alta qualidade.
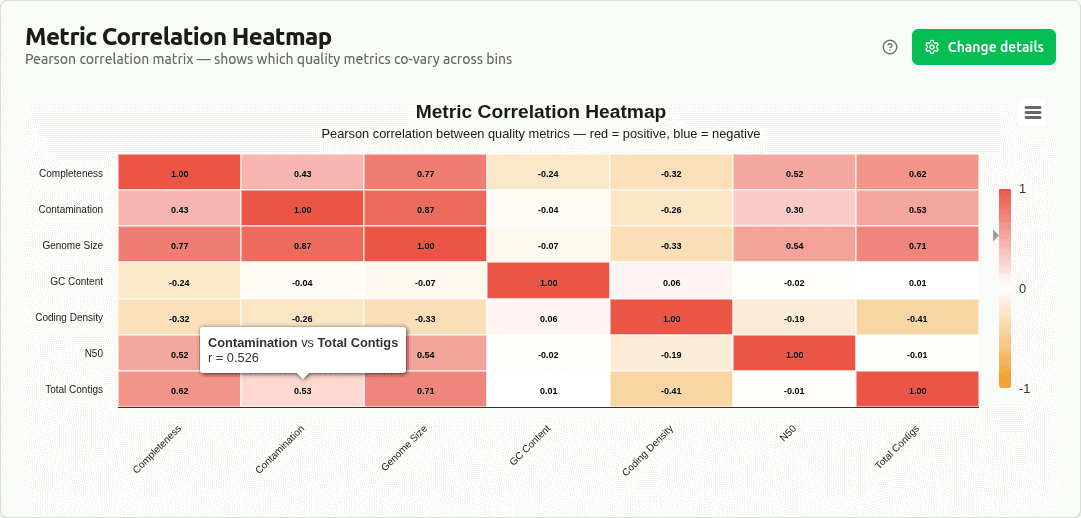
metric-correlation-heatmap
Matriz de correlação de Pearson simétrica em todas as métricas de qualidade numérica. Vermelho = correlação positiva, azul = correlação negativa. Revela quais métricas co-variam (por ex., completude versus tamanho de genoma) e quais são independentes, útil para entender direcionadores de qualidade de MAG.
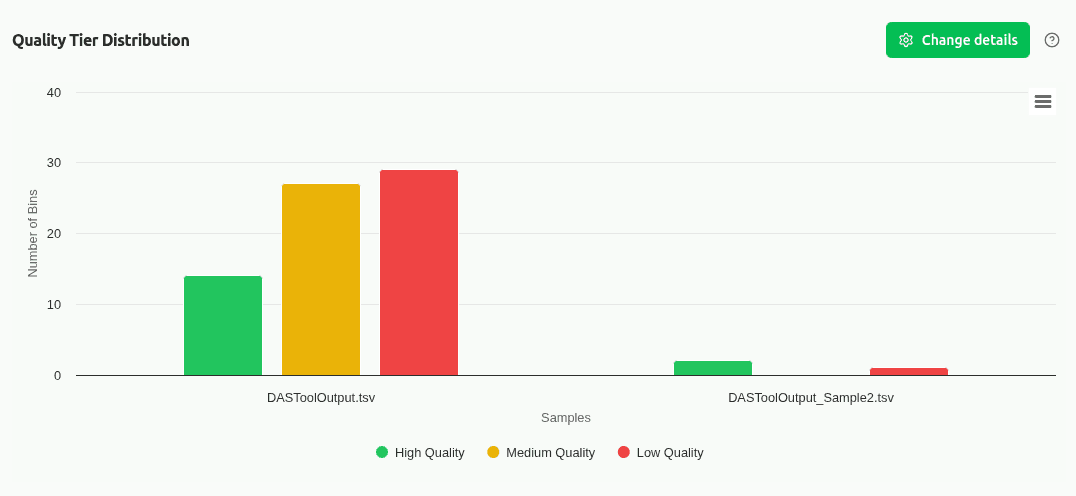
comp-quality-tiers
Gráfico de barras agrupadas comparando a distribuição de níveis de qualidade MIMAG (Alto / Médio / Baixo) entre amostras. Cada grupo mostra uma barra por amostra, permitindo avaliação rápida de qual amostra produziu bins de qualidade geral mais alta.
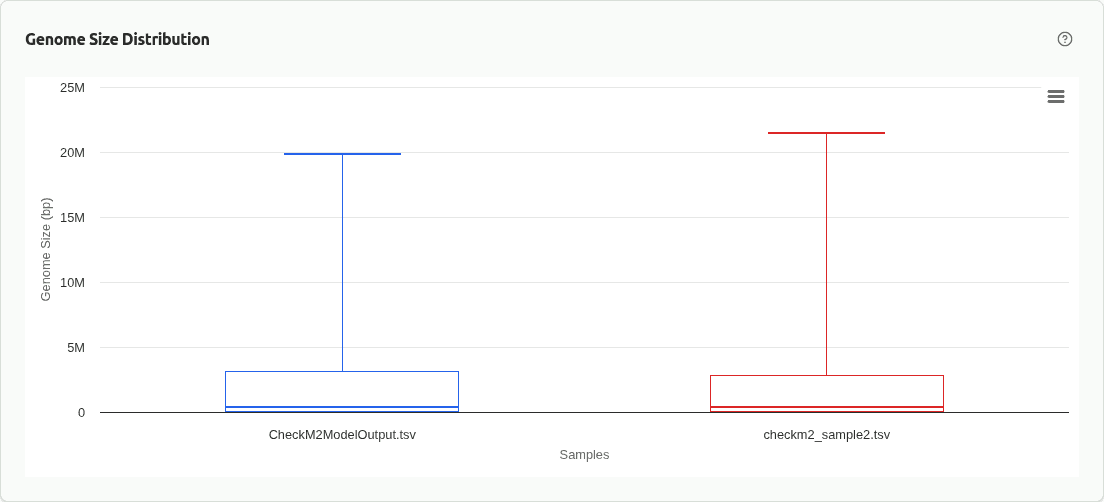
comp-genome-size
Gráfico de caixa ou gráfico de barras agrupadas comparando a distribuição de tamanho de genoma de bins entre amostras. Revela se certas amostras produzem sistematicamente MAGs maiores ou menores, que podem refletir diferenças de composição da comunidade.
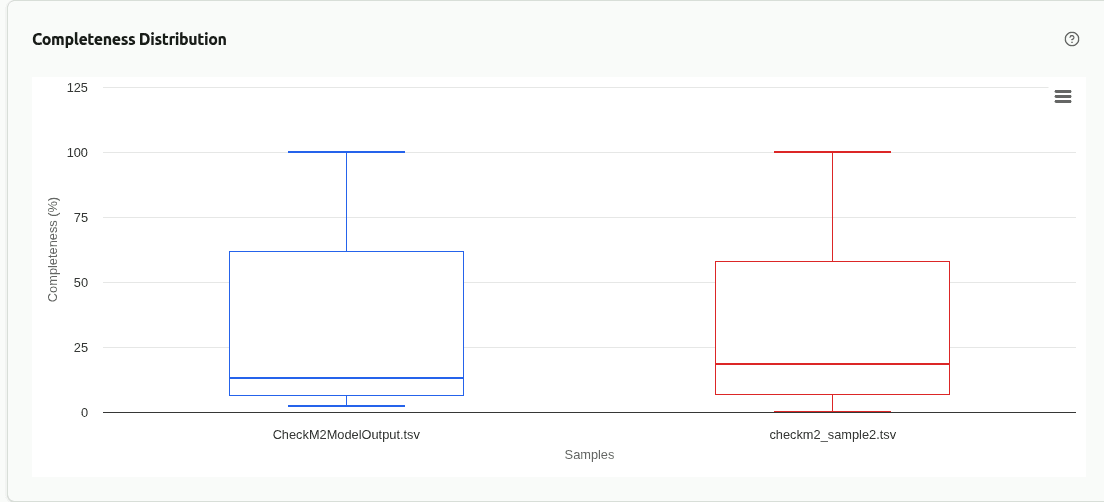
comp-completeness
Gráfico de caixa comparando a distribuição de completude prevista por ML (%) entre amostras. Medianas mais altas e intervalos interquartis mais apertados indicam bins mais consistentemente completos naquela amostra.
comp-contamination
Gráfico de caixa comparando distribuição de contaminação (%) entre amostras. Valores mais baixos são melhores — amostras com contaminação elevada podem precisar de parâmetros de binning mais rigorosos ou refinamento adicional.
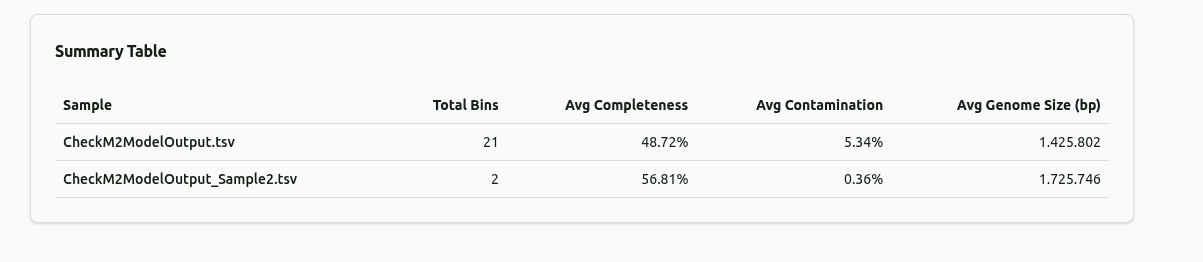
comp-summary-table
Tabela de resumo agregada mostrando métricas-chave por amostra: número total de bins, completude média, contaminação média, tamanho de genoma médio e número de bins de alta qualidade. Fornece visão geral numérica rápida para comparação entre amostras.
comp-quality-pct
Gráfico de barras empilhadas 100% mostrando a proporção de bins de qualidade Alto / Médio / Baixo por amostra. Normaliza para diferentes contagens de bins, permitindo comparação direta de qualidade de recuperação de MAG. Padrão em benchmarks de desafio CAMI.
comp-cdf
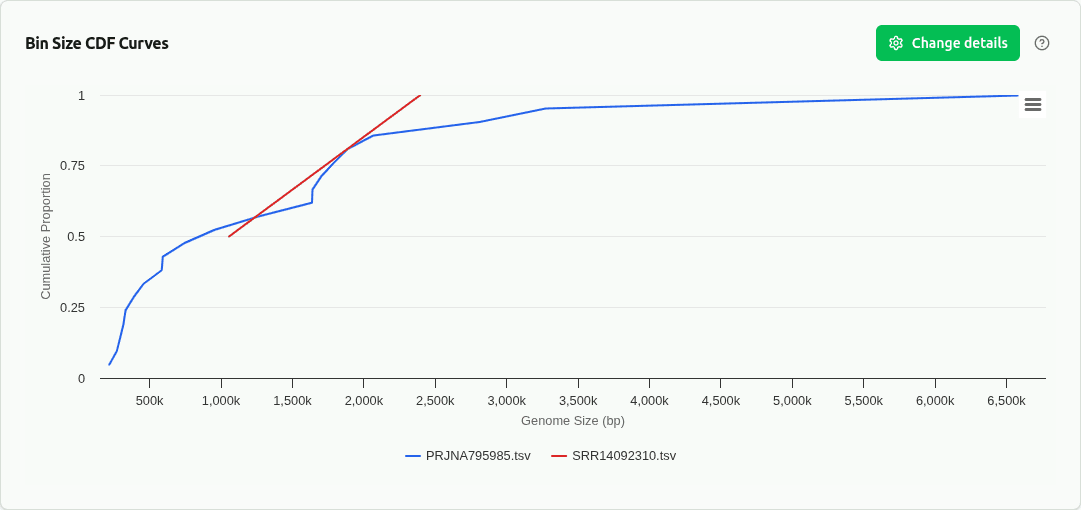
Função de distribuição cumulativa empírica (CDF) de tamanhos de bin sobreposta por amostra. Revela forma de distribuição completa além de resumos de boxplot — caudas, bimodalidade e qual fração de bins excede limites de tamanho. Padrão em benchmarking CAMI.
comp-gc-content
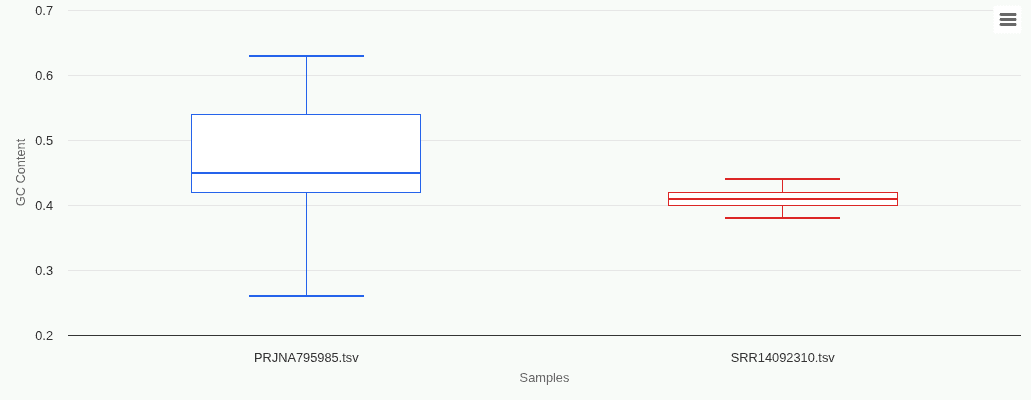
Boxplot de distribuição de conteúdo GC (%) por amostra. Perfis GC diferem entre ambientes (solo versus intestino versus marinho) e protocolos de extração, servindo como proxy para diferenças de composição da comunidade.
comp-contig-n50
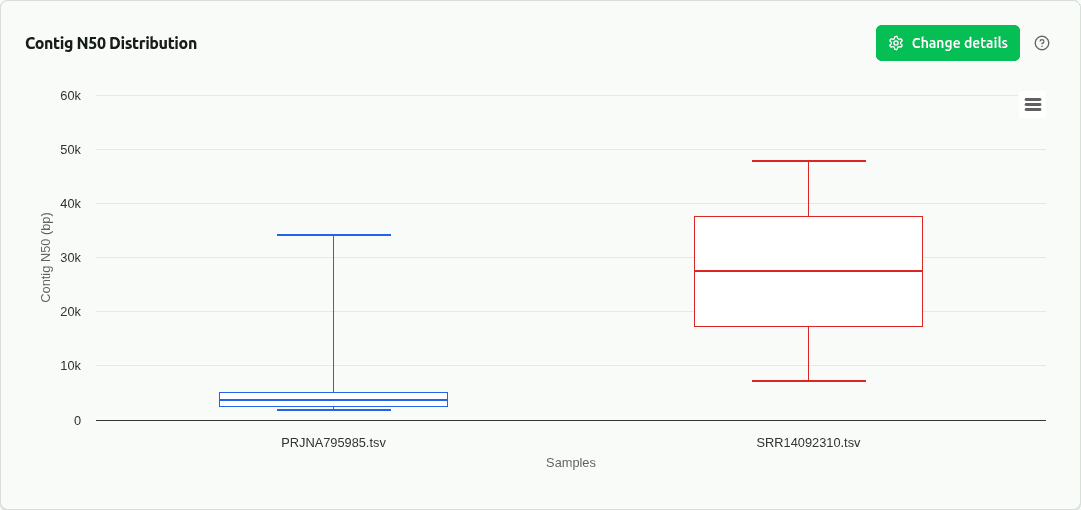
Boxplot de N50 de contig por bin entre amostras. N50 é a métrica principal de contiguidade de montagem — valores mais altos indicam bins menos fragmentados. Reportado em praticamente toda avaliação de qualidade de MAG.
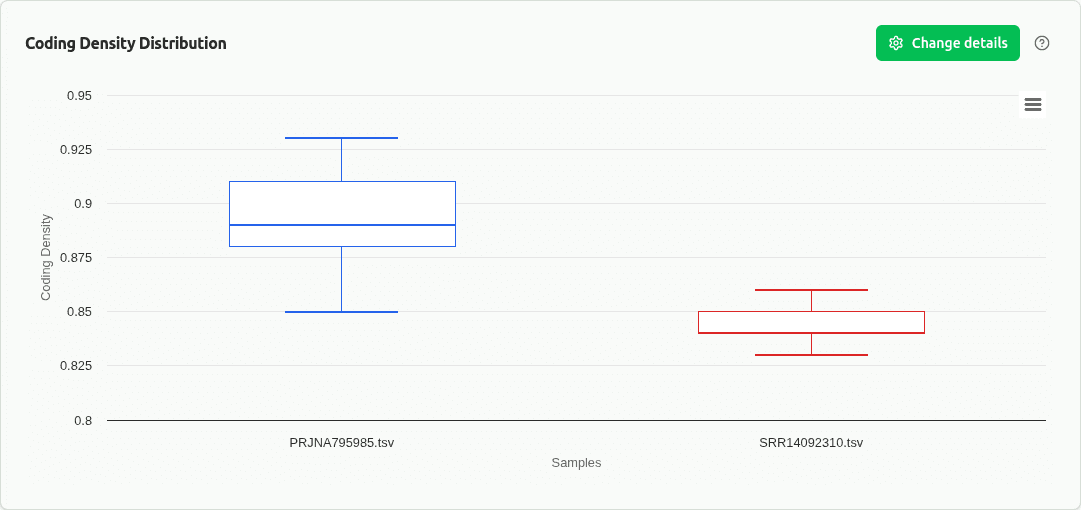
comp-coding-density
Boxplot de densidade de codificação (fração do genoma codificando proteínas) por amostra. Densidade de codificação mais baixa pode indicar contaminação com DNA não-codificante ou sequências eucarióticas. Avaliado pelos modelos ML de CheckM2.
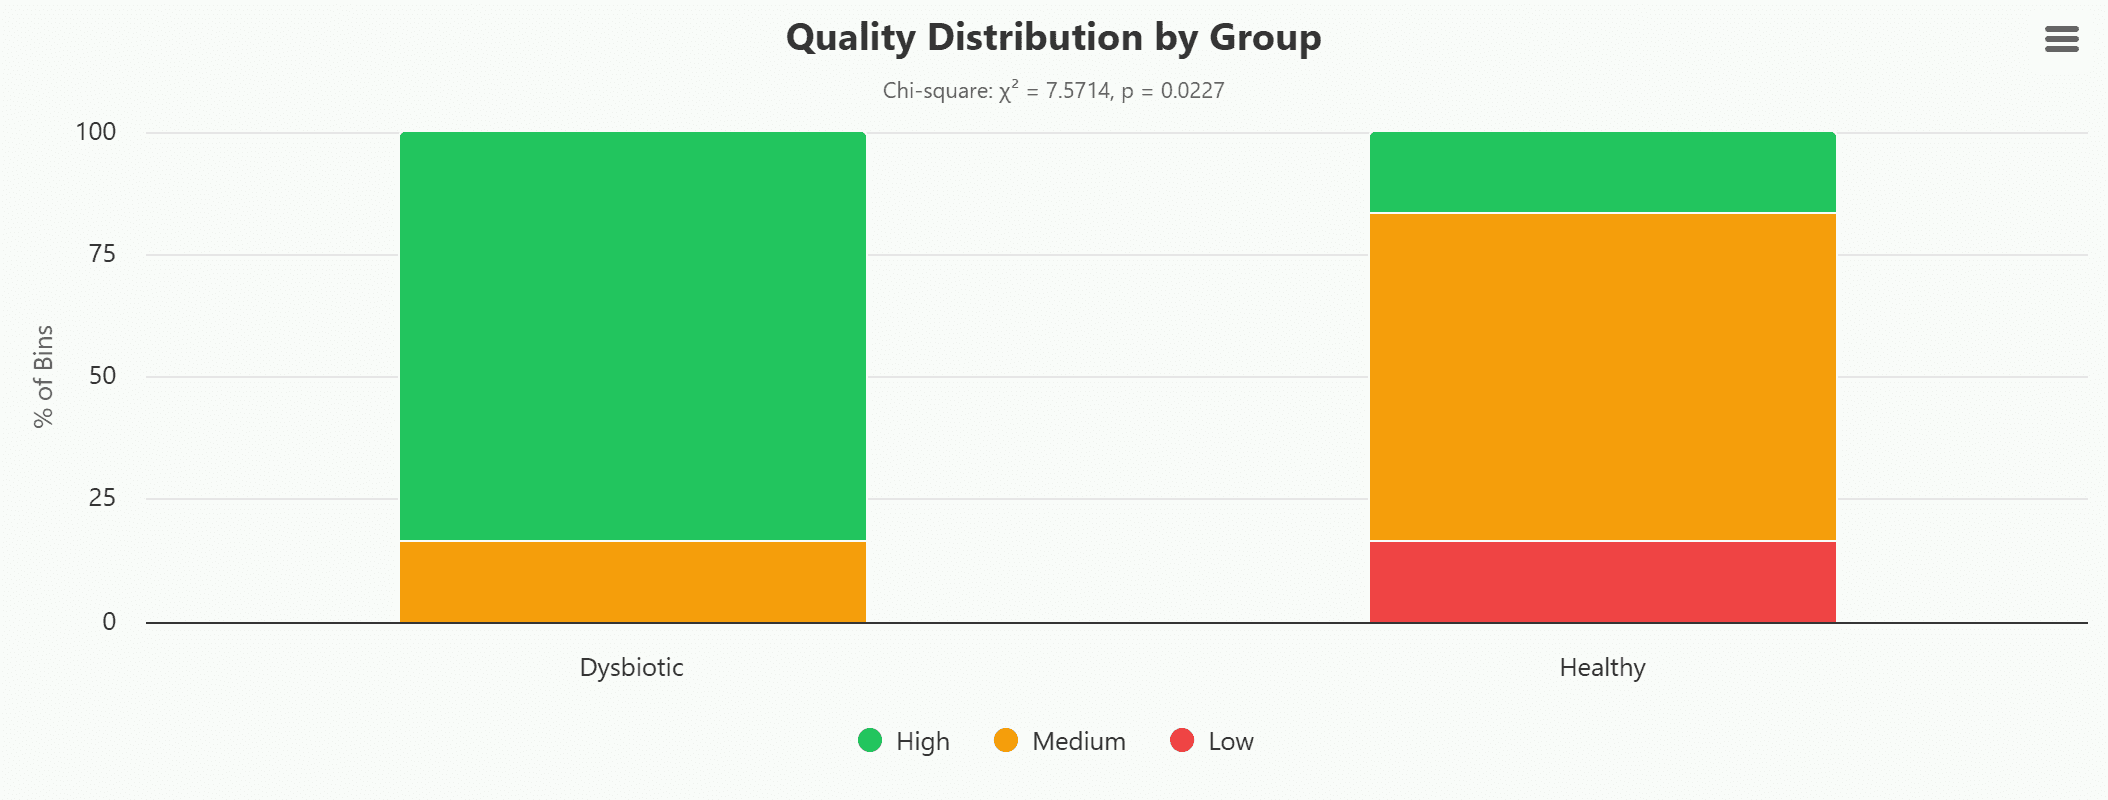
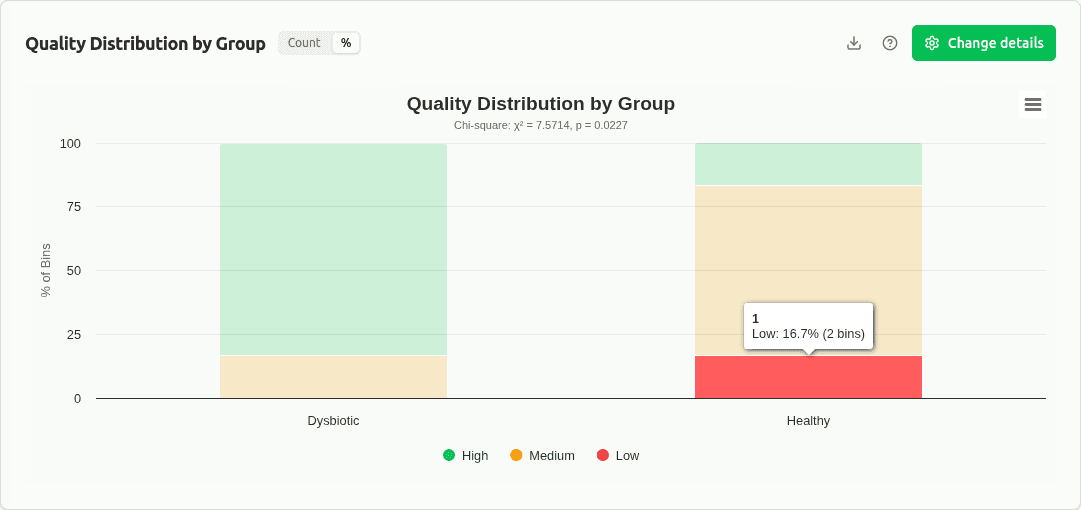
binning-group-quality-tiers
Gráfico de barras agrupadas de contagens de nível de qualidade MIMAG (Alto / Médio / Baixo) por grupo experimental, com teste qui-quadrado para independência. Os níveis seguem Bowers et al.: Alto (>90% completude, <5% contaminação), Médio (≥50%, <10%). Valores p qui-quadrado significativos indicam que distribuições de qualidade de MAG diferem entre grupos.
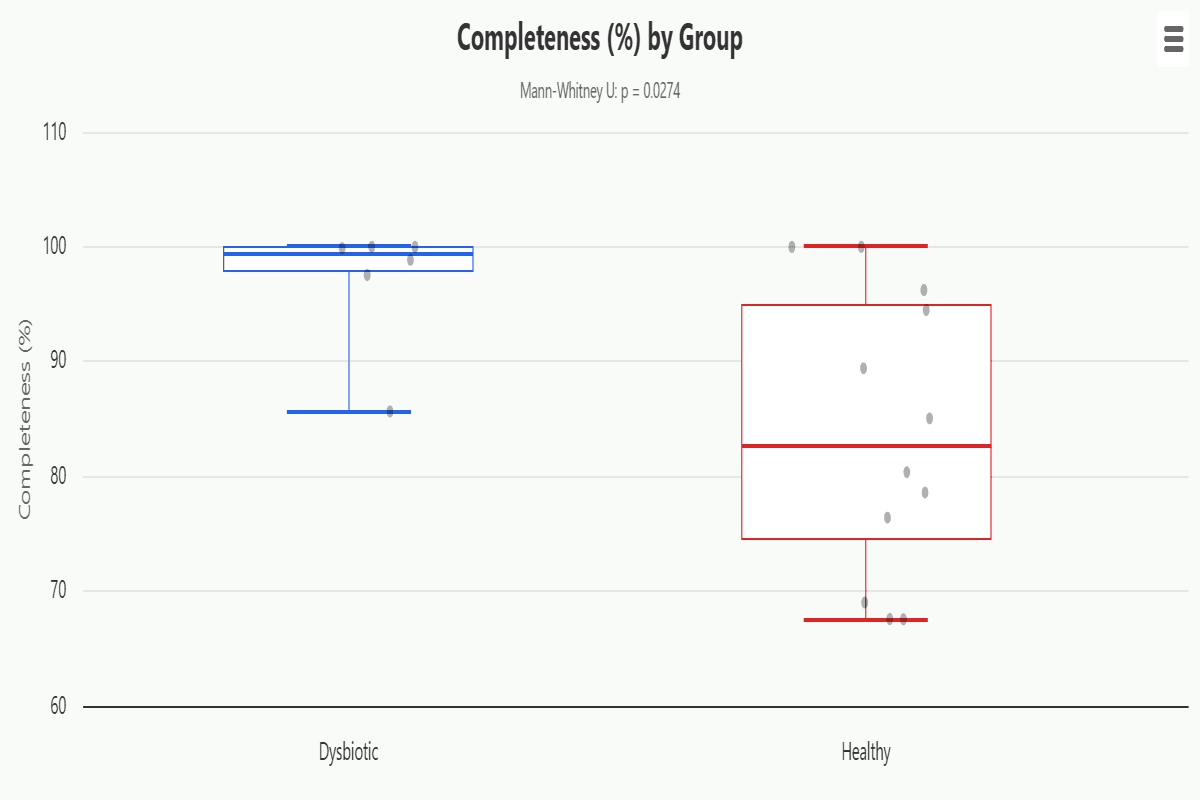
binning-group-metric-boxplots
Boxplots comparando uma métrica de qualidade selecionada (Completude, Contaminação, Tamanho de Genoma, Conteúdo GC, N50 ou Densidade de Codificação) entre grupos. Todos os valores de bin individual são agrupados por grupo. Teste de Kruskal-Wallis (≥3 grupos) ou teste U de Mann-Whitney (2 grupos) avalia significância; comparações pareadas usam correção BH FDR.
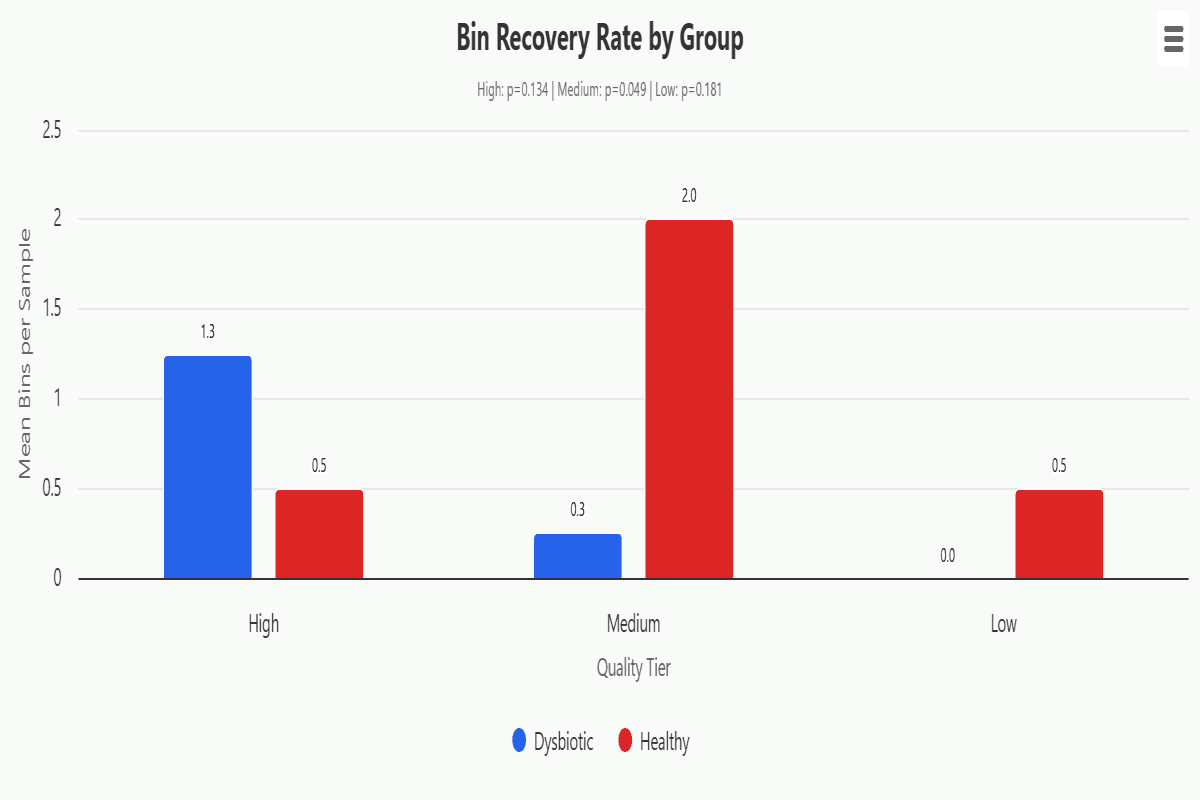
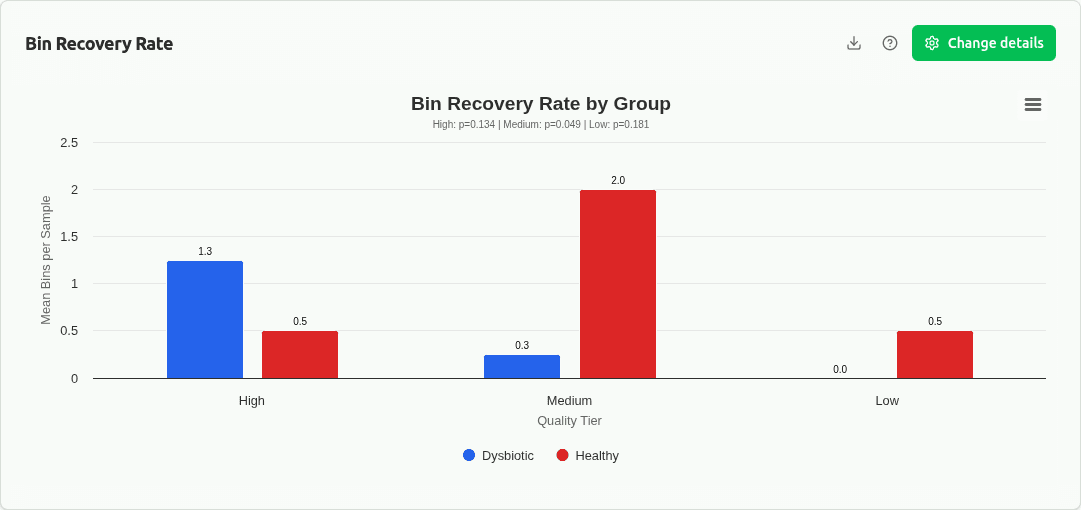
binning-group-recovery-rate
Gráfico de barras agrupadas de contagem média de bins por amostra em cada nível de qualidade (Alto, Médio, Baixo, Total) entre grupos, com barras de erro mostrando ±1 SD. Testa se grupos diferem em quantos MAGs recuperam — um benchmarkchave no marco de desafio CAMI.
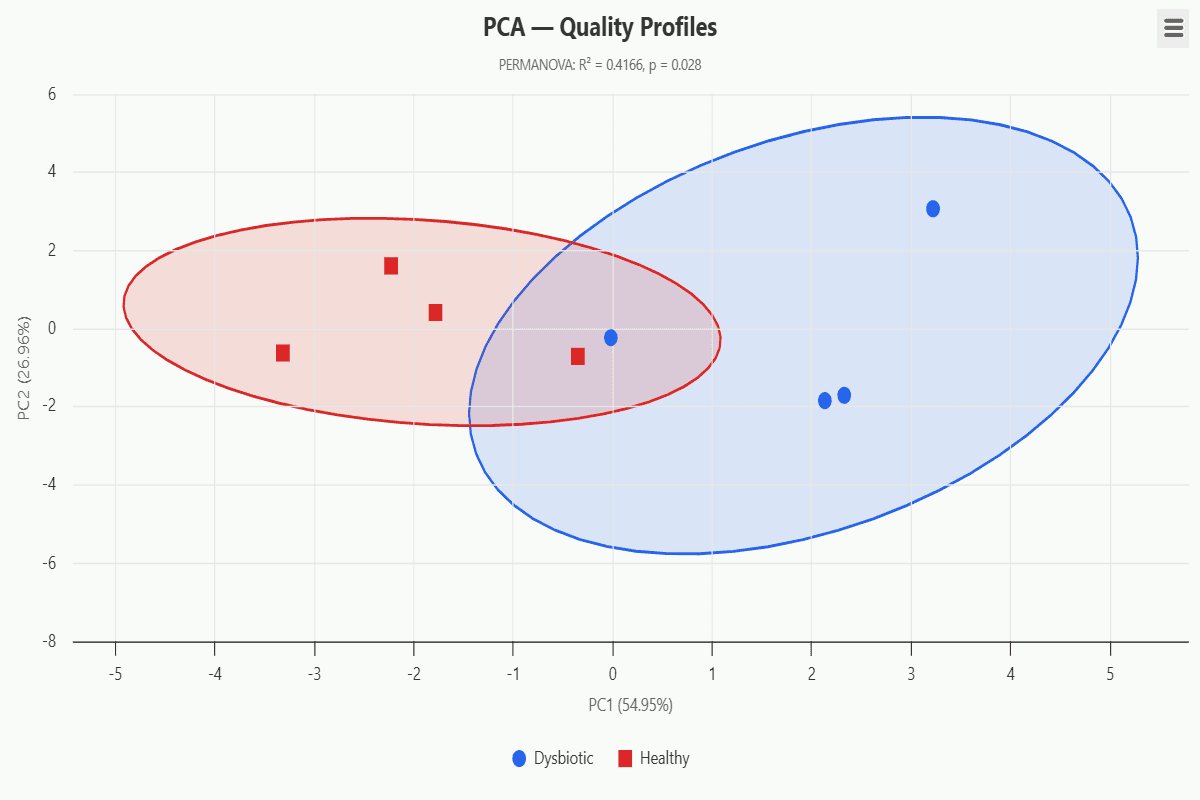
binning-group-pca
Ordenação de PCA de perfis de qualidade por amostra (completude média, contaminação, tamanho de genoma, GC, N50, densidade de codificação, %HQ, %MQ). Características são padronizadas z-score antes da decomposição. PERMANOVA na matriz de distância euclidiana testa se centroides de grupo diferem significativamente. Elipses de confiança de 95% são desenhadas para grupos com ≥3 amostras.
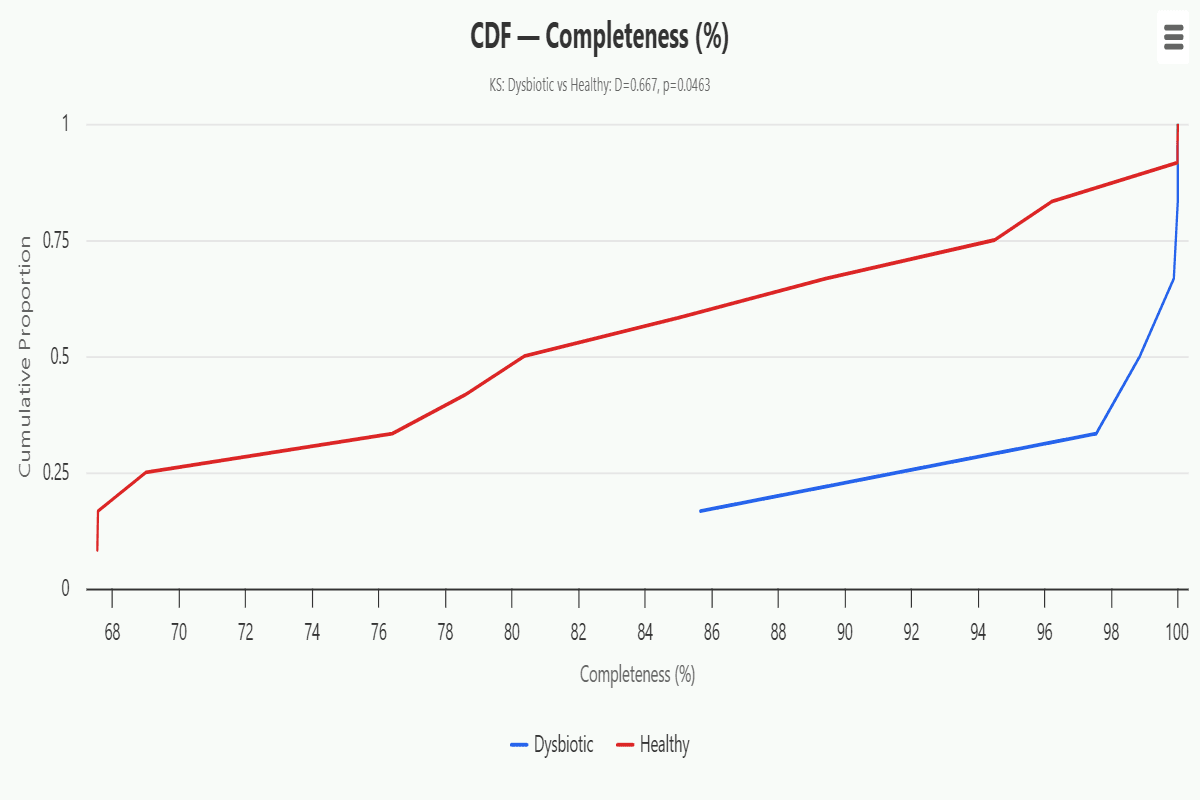
binning-group-cdf
Funções de distribuição cumulativa empírica sobrepostas (CDFs) de uma métrica selecionada entre grupos. O teste de Kolmogorov-Smirnov de duas amostras quantifica a distância vertical máxima entre curvas — D-estatísticas significativas indicam que distribuições de métrica dos grupos diferem em localização, propagação ou forma.
binning-group-scatter
Sobreposição de dispersão entre grupos de métricas de qualidade, colorida por grupo. As zonas de fundo marcam níveis de qualidade. Mostra se grupos experimentais produzem sistematicamente diferentes perfis de qualidade de MAG. Baseado em padrões MIMAG.
binning-group-total-recovery
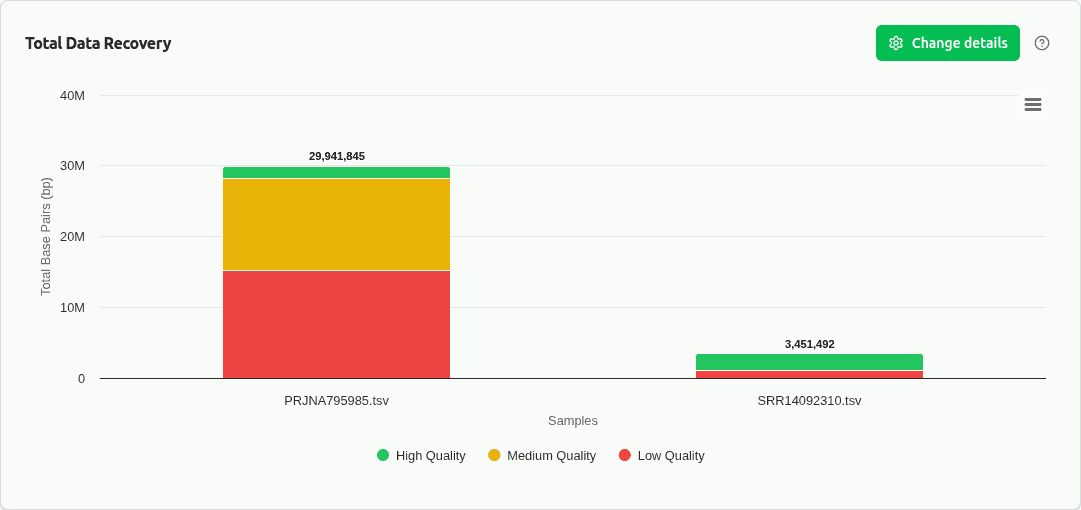
Gráfico de barras empilhadas de pares de bases totais médios recuperados por grupo, divididos por nível de qualidade. Barras de erro mostram ±1 SD. Mede volume de dados real vinculado por grupo, complementando gráficos de contagem e taxa de recuperação de bins.