Análisis de Comunidad de Microbioma
Análisis de ComunidadAnálisis comunitario de datos de censo de microbioma — una tabla de abundancia OTU/ASV, una tabla de taxonomía y una tabla de metadatos de muestra — para composición, diversidad alfa y beta, ordenación y coocurrencia. Las tres tablas son la salida estándar de cualquier tubería de amplicón o metagenómica (QIIME 2, DADA2, mothur, USEARCH/VSEARCH, MetaPhlAn); tráelas de la que ejecutaste. [1]
Cómo Obtener el Archivo de Modelo de Salida
A continuación se muestra un breve flujo de trabajo que ejecutó el equipo para obtener los ejemplos de modelo de salida que presentamos en la página de herramientas.
Entrada
Una tabla de características OTU/ASV + una tabla de taxonomía + una tabla de metadatos de muestra (CSV/TSV) — exportada de QIIME 2, DADA2, mothur o cualquier tubería; p. ej. el ejemplo CARBOM incluido (metabarcoding 18S, 205 taxones × 54 muestras)
Salida
Tres tablas CSV/TSV cargadas en IntMeta — una tabla de abundancia OTU/ASV (taxones × muestras), una tabla de taxonomía (id de taxón + rangos como Dominio … Género), y una tabla de metadatos de muestra (muestra + variables)
conda install -c bioconda bioconductor-phyloseq
Exporta la tabla de características y taxonomía de tus artefactos QIIME 2 (.qza) y convierte la tabla de características a TSV. El TSV de metadatos de muestra que ya usas en QIIME 2 es el tercer archivo, sin cambios. Ver QIIME 2 — exportar datos.
- 1
Exportar la tabla de características y convertir a TSV
qiime tools export --input-path table.qza --output-path exported/
biom convert -i exported/feature-table.biom -o otu_table.tsv --to-tsv
Eliminar la línea de comentario inicial "# Constructed from biom file" de otu_table.tsv antes de carga, para que la fila de encabezado comience con la columna id de taxón.
- 2
Exportar la taxonomía
qiime tools export --input-path taxonomy.qza --output-path exported/
Produce exported/taxonomy.tsv (Feature ID + Taxon + Confidence). Opcionalmente dividir la cadena de Taxón en una columna por rango.
- 3
Usar los metadatos de muestra tal cual
# sample-metadata.tsv — first column = sample id, remaining columns = variables
El mismo metadatos TSV que pasaste a QIIME 2 es el tercer archivo de carga.
Materiales Utilizados
Archivos de Salida de Ejemplo
Descarga los archivos de salida utilizados en las demostraciones de la página de herramientas. Puedes cargarlos directamente a IntMeta para explorar las visualizaciones.
Único y Comparación
Referencia de Gráficos
Descripciones detalladas de todas las 6 visualizaciones generadas por Análisis de Comunidad de Microbioma en IntMeta.
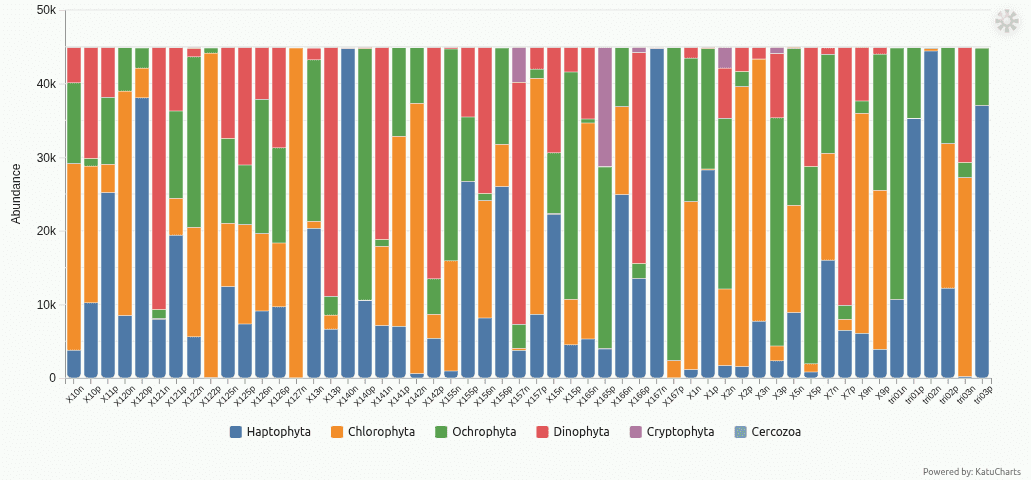
composition
Gráfico de barras apiladas por muestra de abundancia relativa en un rango taxonómico elegido. Cada barra es una muestra — o un conjunto de muestras fusionadas por una variable de metadatos — dividida en segmentos de colores para los taxones más abundantes, revelando cómo cambia la composición comunitaria a través de sitios, profundidades o fracciones.
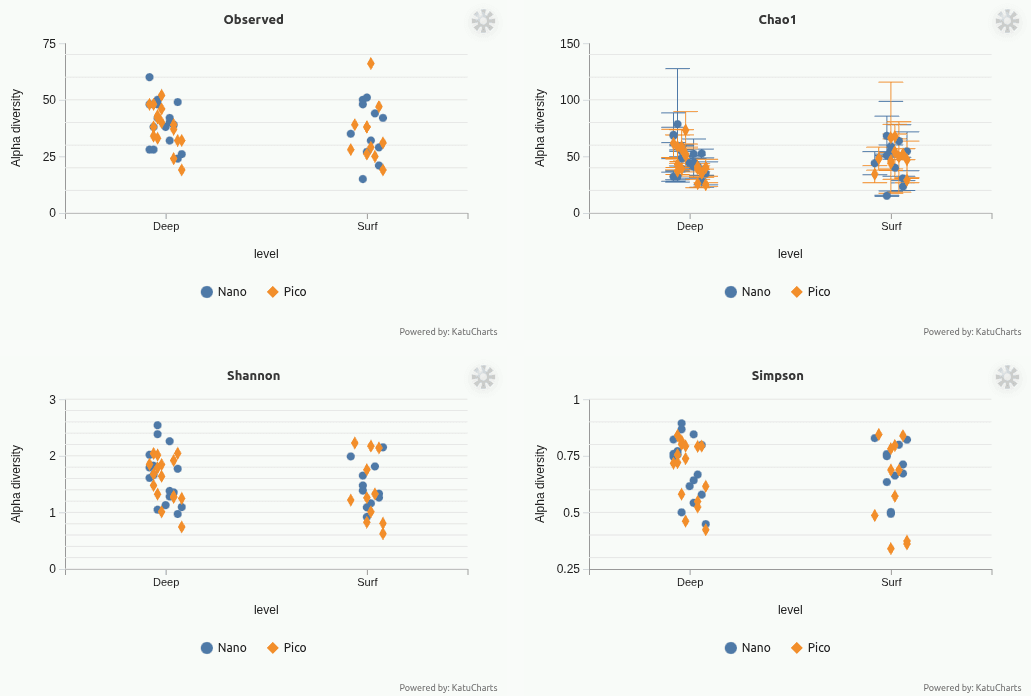
alpha-diversity
Diversidad dentro de la muestra como un punto por muestra con intervalo de confianza, facetado por medida: riqueza observada, Chao1 (con su error estándar dibujado como barras de error con gorro), entropía de Shannon e índice de Simpson. Los puntos se sitúan a lo largo de una variable de metadatos categóricos elegida y están coloreados por una segunda, para que los efectos de tratamiento o profundidad en la diversidad destaquen.
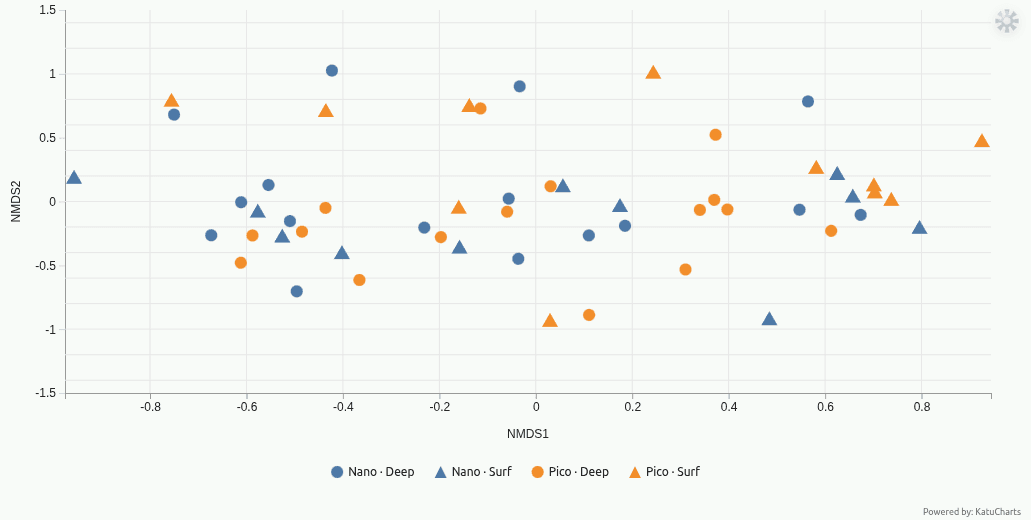
ordination-samples
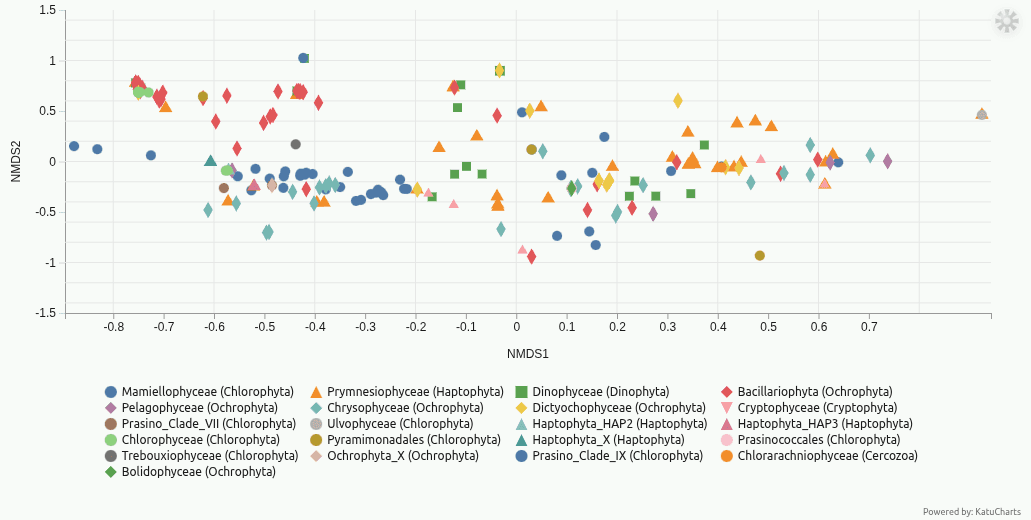
Ordenación de diversidad beta de muestras (NMDS o PCoA) calculada en una matriz de distancia de Bray-Curtis o Jaccard. Cada punto es una muestra, coloreada y con forma según variables de metadatos; puntos cercanos tienen comunidades similares. Elipses de confianza opcionales del 95% resumen grupos.
ordination-taxa
La misma ordenación proyectada en taxones: cada punto es un taxón colocado por su puntuación de promedio ponderado, coloreado por un rango y con forma según otro. Destaca qué taxones impulsan la separación entre muestras y cómo se agrupan los rangos más altos en el espacio comunitario.
heatmap
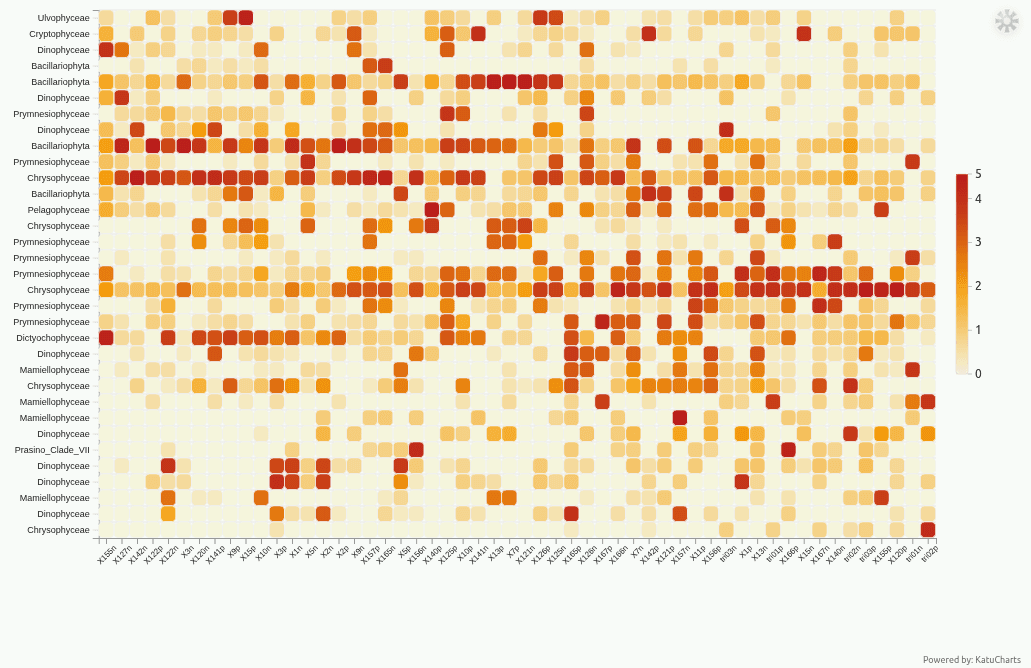
Mapa de calor de abundancia de los taxones más abundantes (filas) a través de muestras (columnas), con filas y columnas ordenadas por la ordenación para que los taxones coocurrentes y muestras similares se sienten juntos. El color de la celda codifica abundancia en una escala beige-a-rojo; un umbral de abundancia controla cuántos taxones se muestran.
network
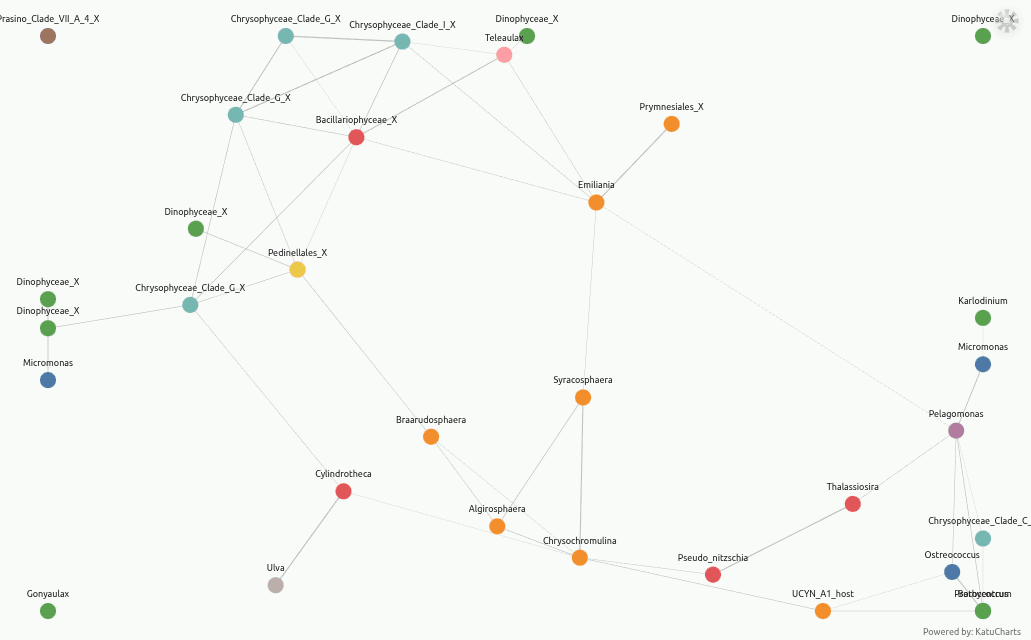
Red de coocurrencia de los taxones abundantes: los nodos son taxones (coloreados por un rango elegido, etiquetados por otro) vinculados cuando sus perfiles de abundancia son similares — distancia por debajo de un umbral ajustable. El ancho de arista se escala con cercanía, los nodos son arrastrables, y las etiquetas se espacian automáticamente para mantenerse legibles.