CheckM2
Agrupamiento MetagenómicoCheckM2 es una herramienta rápida basada en aprendizaje automático para evaluar la calidad de genomas ensamblados de metagenomas (MAGs). Utiliza modelos potenciados por gradiente entrenados en características genómicas para predecir completitud y contaminación sin requerir genomas de referencia. [1]
Cómo Obtener el Archivo de Modelo de Salida
A continuación se muestra un breve flujo de trabajo que ejecutó el equipo para obtener los ejemplos de modelo de salida que presentamos en la página de herramientas.
Entrada
Directorio de bins de genoma en formato FASTA (.fa, .fna, .fasta)
Salida
Archivo TSV con métricas de calidad por bin: completitud, contaminación, densidad de codificación, contenido GC, tamaño de genoma, N50, conteo de contigs
conda install -c bioconda checkm2
Imagen Docker: nanozoo/checkm2:latest
Muestra 1 21 bins ensamblados de metagenoma de la co-asamblea PRJNA795985 de microbioma intestinal evaluados con CheckM2 usando la Base de datos.
- 1
Descargar 3 muestras de PRJNA795985
for SRR in SRR17531757 SRR17531762 SRR17531772; do fastq-dump --split-files --gzip -X 1000000 --outdir reads/ $SRR; done
1M pares de lecturas por muestra de "Diet and Antimicrobial Resistance in Healthy US Adults" (Shrestha et al., mBio 2022).
- 2
Co-ensamblar con MEGAHIT
megahit -1 reads/SRR17531757_1.fastq.gz,reads/SRR17531762_1.fastq.gz,reads/SRR17531772_1.fastq.gz -2 reads/SRR17531757_2.fastq.gz,reads/SRR17531762_2.fastq.gz,reads/SRR17531772_2.fastq.gz -o assembly --min-contig-len 1500 -t 8
La co-asamblea produce 14,934 contigs (≥1,500 bp).
- 3
Mapear cada muestra a contigs
for SRR in SRR17531757 SRR17531762 SRR17531772; do minimap2 -ax sr -t 8 assembly/final.contigs.fa reads/${SRR}_1.fastq.gz reads/${SRR}_2.fastq.gz | samtools sort -@ 4 -o bams/${SRR}.sorted.bam && samtools index bams/${SRR}.sorted.bam; doneProduce alineamientos BAM por muestra requeridos para binning.
- 4
Bin contigs
vamb bin default --outdir vamb_out --fasta assembly/final.contigs.fa --bamdir bams/ -m 1500 --minfasta 200000 -p 8
Produce 21 archivos FASTA de bin (≥200 Kbp).
- 5
Descargar base de datos de CheckM2
checkm2 database --download --path checkm2_db/
Descarga la base de datos DIAMOND (uniref100.KO.1.dmnd, ~1.74 GB).
- 6
Ejecutar CheckM2 en todos los 21 bins
checkm2 predict --input bins/ --output-directory checkm2_output/ -x fna --threads 8 --database_path checkm2_db/uniref100.KO.1.dmnd
Produce quality_report.tsv con completitud, contaminación, densidad de codificación, contenido GC, N50 y tamaño de genoma para todos los 21 bins.
Materiales Utilizados
Archivos de Salida de Ejemplo
Descarga los archivos de salida utilizados en las demostraciones de la página de herramientas. Puedes cargarlos directamente a IntMeta para explorar las visualizaciones.
Único y Comparación
Análisis de Grupo
Referencia de Gráficos
Descripciones detalladas de todas las 32 visualizaciones generadas por CheckM2 en IntMeta.
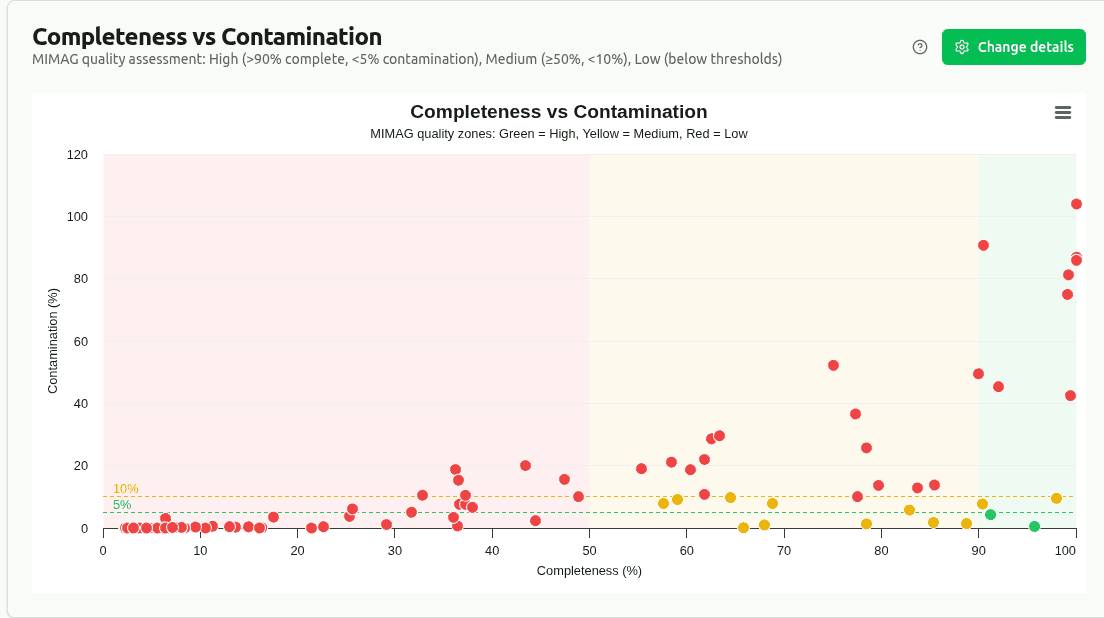
completeness-vs-contamination
Gráfico de dispersión de completitud predicida por ML (%) versus contaminación (%) para cada bin, coloreado por nivel de calidad MIMAG. Los bins ideales se sitúan en la esquina superior izquierda. Las líneas punteadas marcan umbrales MIMAG: Calidad Alta (>90% completo, <5% contaminación) y Calidad Media (≥50% completo, <10% contaminación).
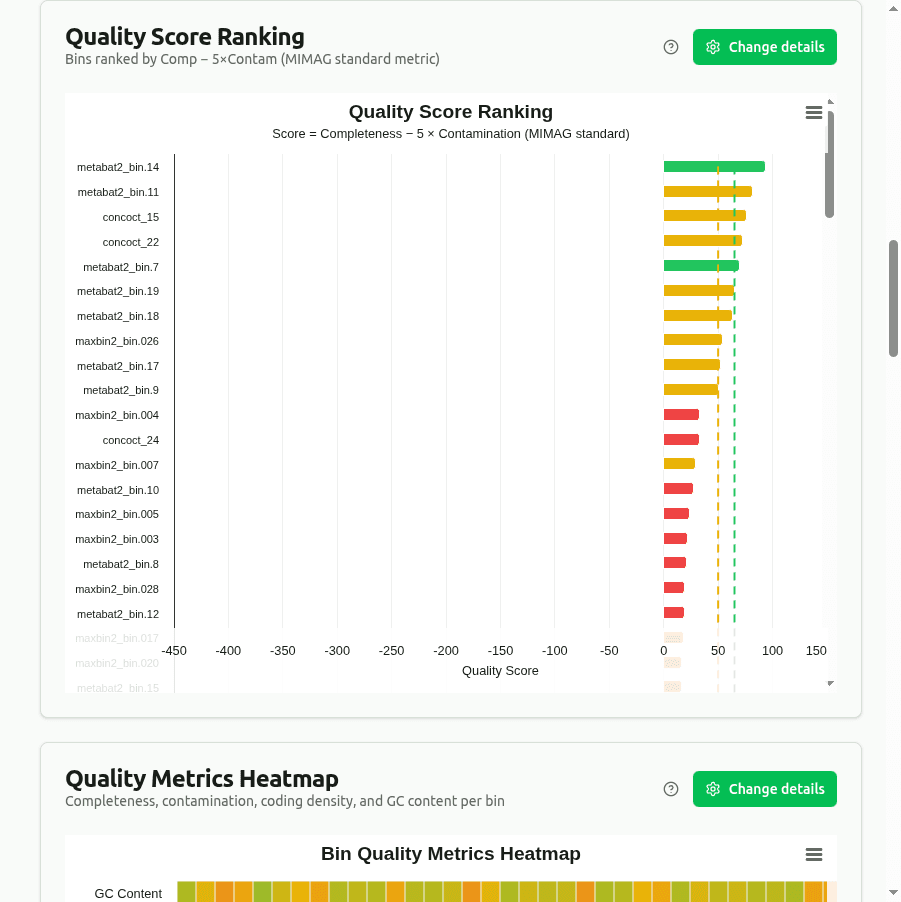
quality-score-ranking
Gráfico de barras horizontales clasificando bins por puntuación de calidad compuesta = Completitud − 5 × Contaminación (la fórmula estándar MIMAG). Un bin con 95% completitud y 2% contaminación puntúa 85. El color refleja el nivel de calidad MIMAG (Alto / Medio / Bajo).
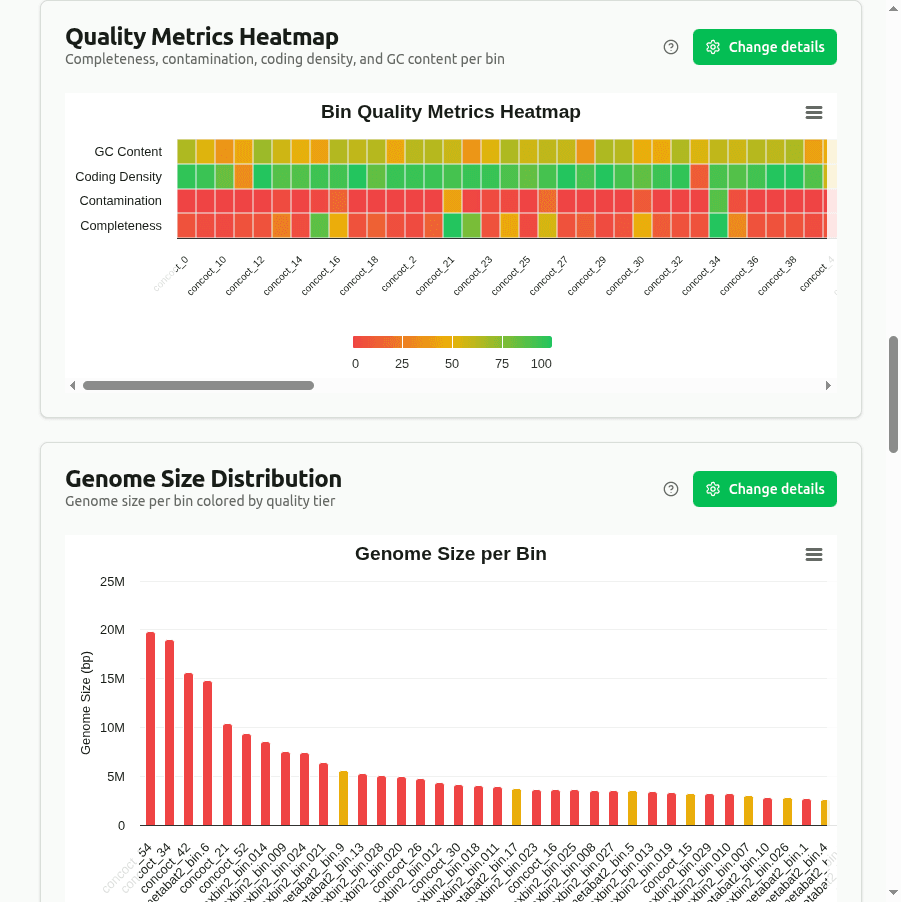
quality-metrics-heatmap
Mapa de calor de valores normalizados por min-max de Completitud, Contaminación, Coding_Density, y GC_Content a través de todos los bins. Cada métrica se escala 0–1 dentro de su columna; celdas más oscuras indican valores relativos más altos. Útil para detectar bins atípicos de un vistazo.
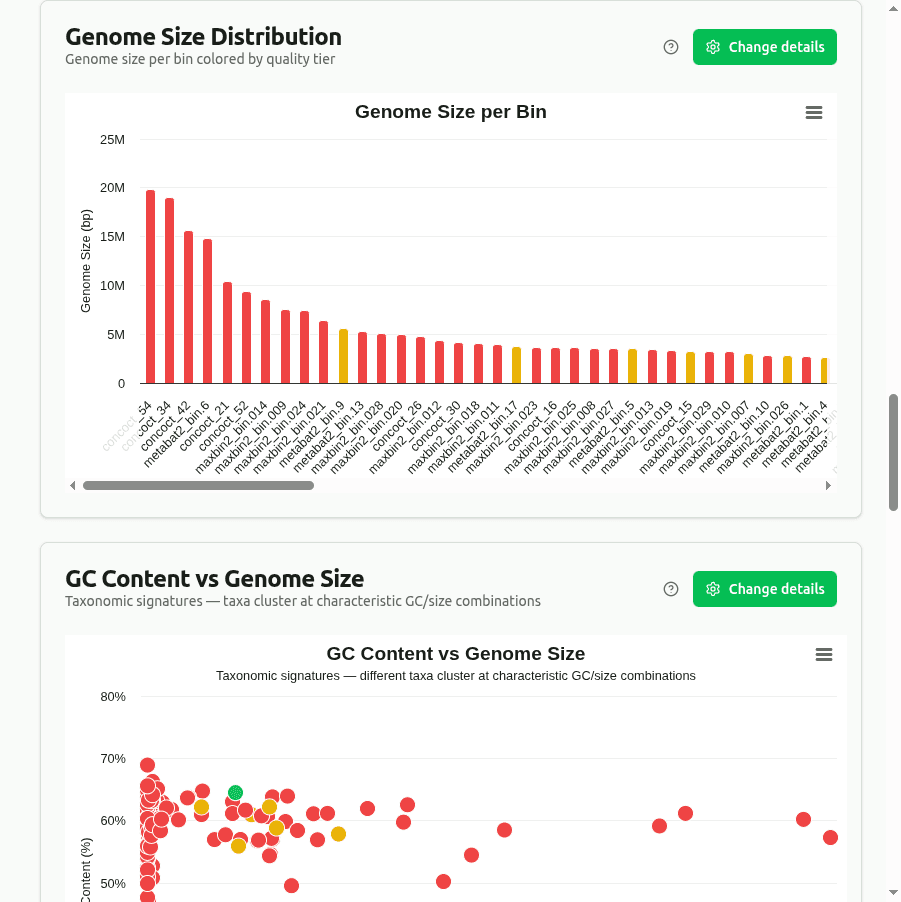
genome-size-distribution
Gráfico de barras de Genome_Size (Mbp) por bin, clasificado por tamaño y coloreado por nivel de calidad MIMAG. Las líneas de referencia punteadas indican rangos de tamaño de genoma bacteriano típicos (la mayoría son 1–8 Mbp). Los bins inusualmente pequeños o grandes pueden requerir inspección manual.
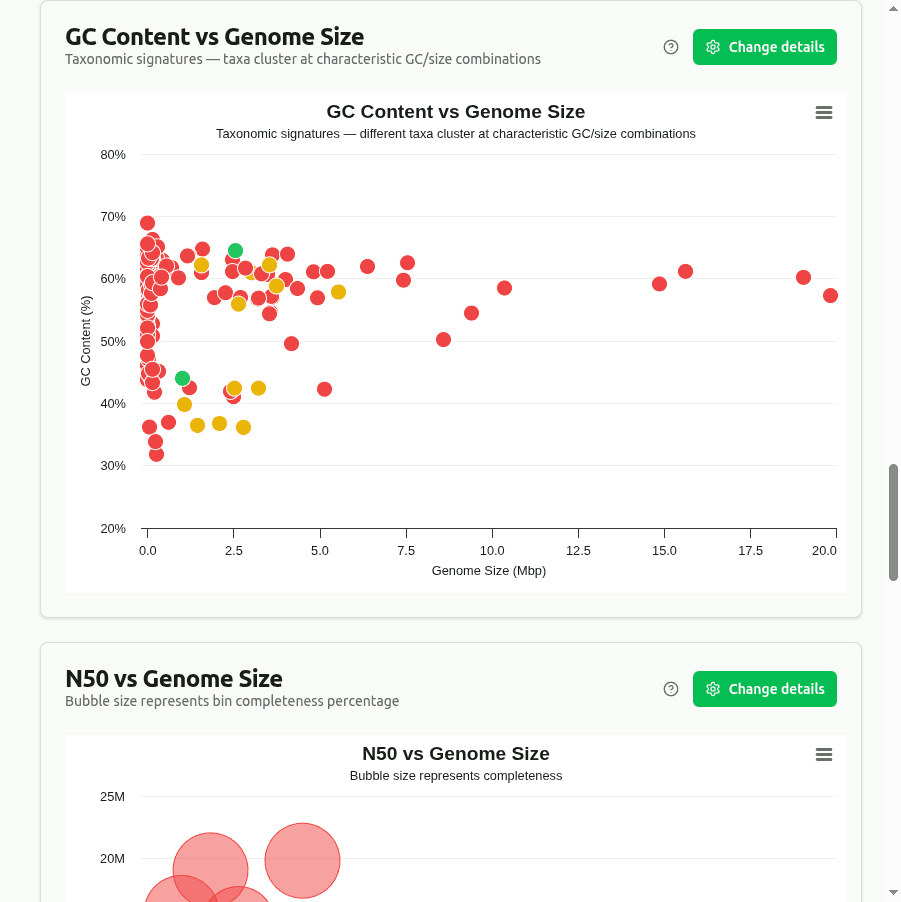
gc-content-vs-genome-size
Gráfico de dispersión de GC_Content (%) versus Genome_Size. Diferentes taxones se agrupan en combinaciones características de GC/tamaño — p. ej., Firmicutes tienden hacia 30–40% GC mientras que Actinobacteria a menudo superan 60%. Las posiciones atípicas pueden indicar bins quiméricos que mezclan contigs de organismos no relacionados.
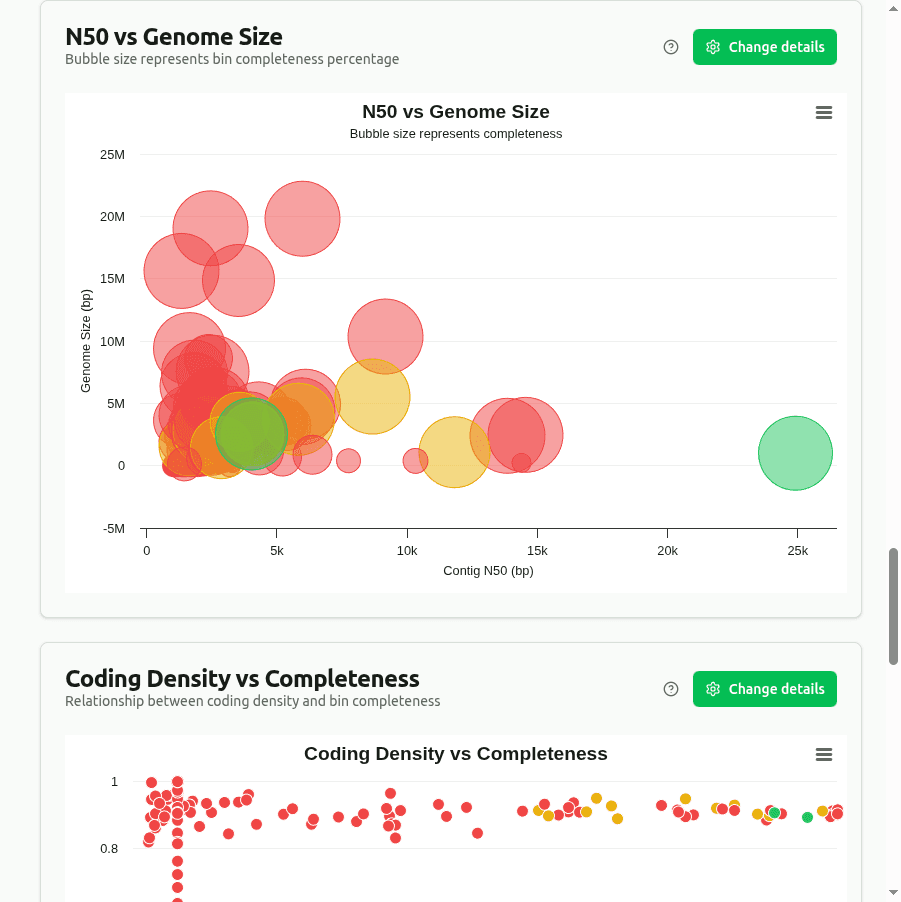
n50-vs-genome-size
Gráfico de burbujas donde X = Genome_Size, Y = Contig_N50 (la mitad de la longitud de la asamblea está en contigs ≥ este tamaño), y diámetro de burbuja = Completitud (%). Las burbujas grandes en la esquina superior derecha representan genomas bien ensamblados y completos.
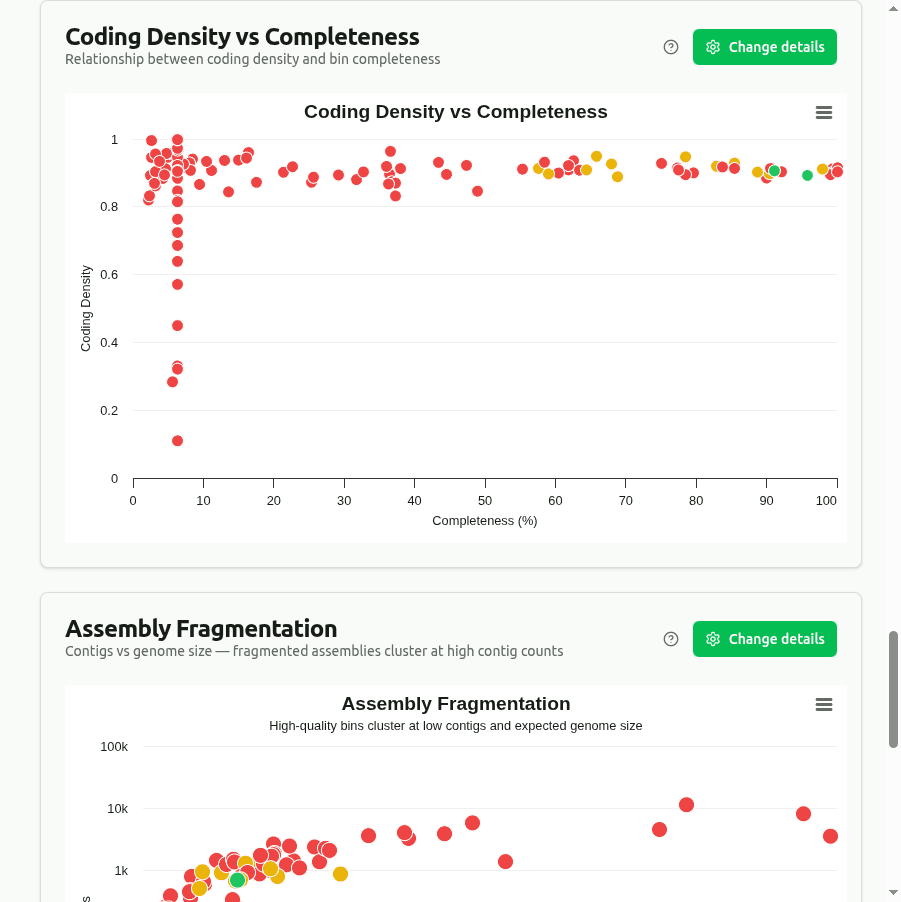
coding-density-vs-completeness
Gráfico de dispersión de Coding_Density (fracción de bases en secuencias de codificación) versus Completitud, coloreado por nivel de calidad. La mayoría de genomas procarióticos tienen densidad de codificación entre 85–95%. La baja densidad de codificación combinada con alta completitud puede señalar contaminación con ADN no codificante.
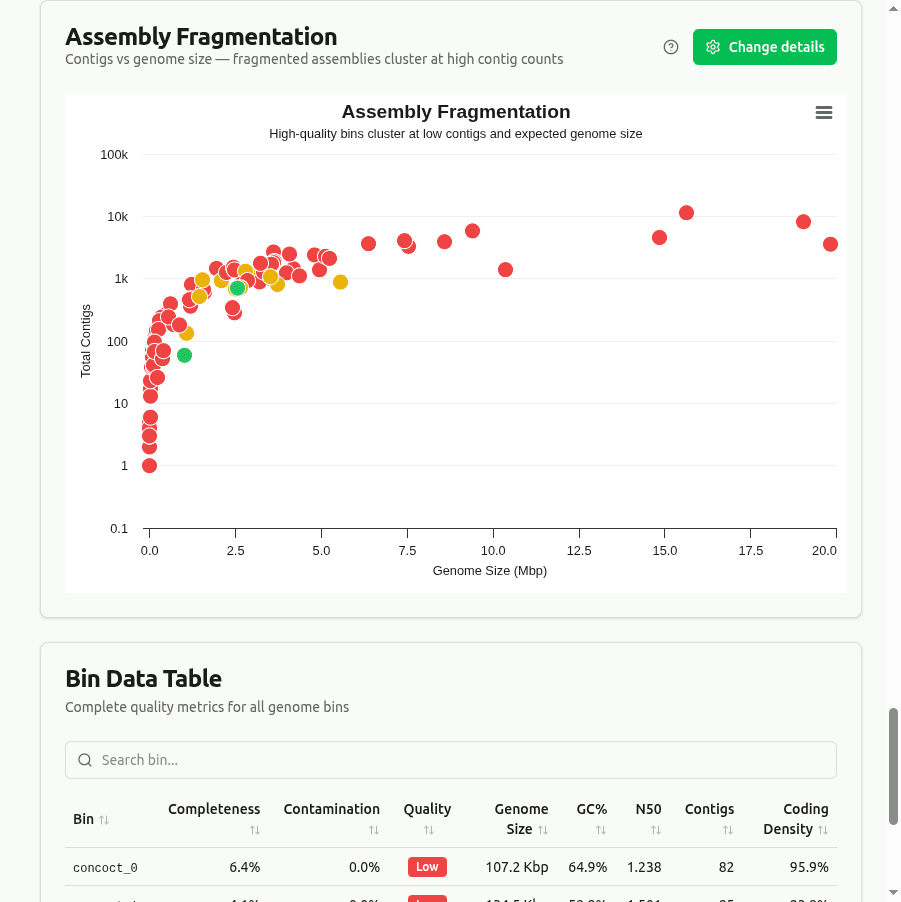
assembly-fragmentation
Gráfico de dispersión de Total_Contigs (conteo de contigs) versus Genome_Size. Las asambleas altamente fragmentadas aparecen en la esquina superior izquierda (muchos contigs, genoma pequeño). Los genomas bien ensamblados se agrupan en la esquina inferior derecha (pocos contigs, genoma grande). La fragmentación afecta análisis posteriores como predicción de genes.
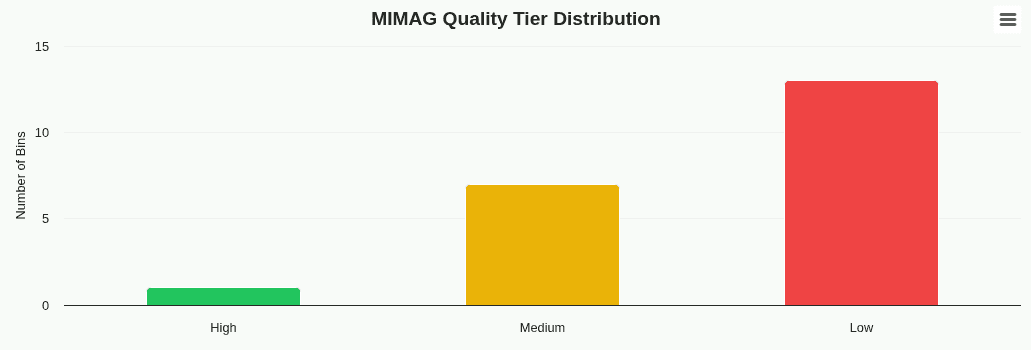
quality-tier-distribution
Gráfico de barras contando bins en cada nivel de calidad MIMAG: Alto (>90% completitud, <5% contaminación), Medio (≥50% completitud, <10% contaminación), Bajo (debajo de ambos umbrales). El gráfico de resumen más común en publicaciones de MAG.
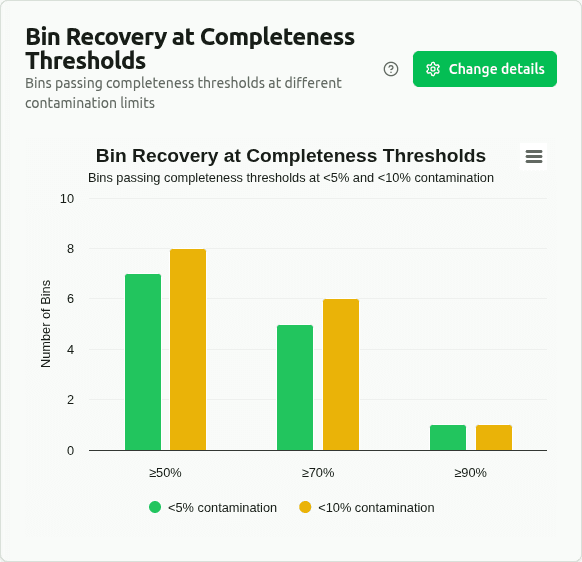
completeness-threshold-recovery
Gráfico de barras agrupadas mostrando cuántos bins pasan ≥50% / ≥70% / ≥90% completitud en límites de <5% y <10% contaminación. Visualización de evaluación estándar de desafíos CAMI, artículos de DAS Tool, SemiBin2 y VAMB.
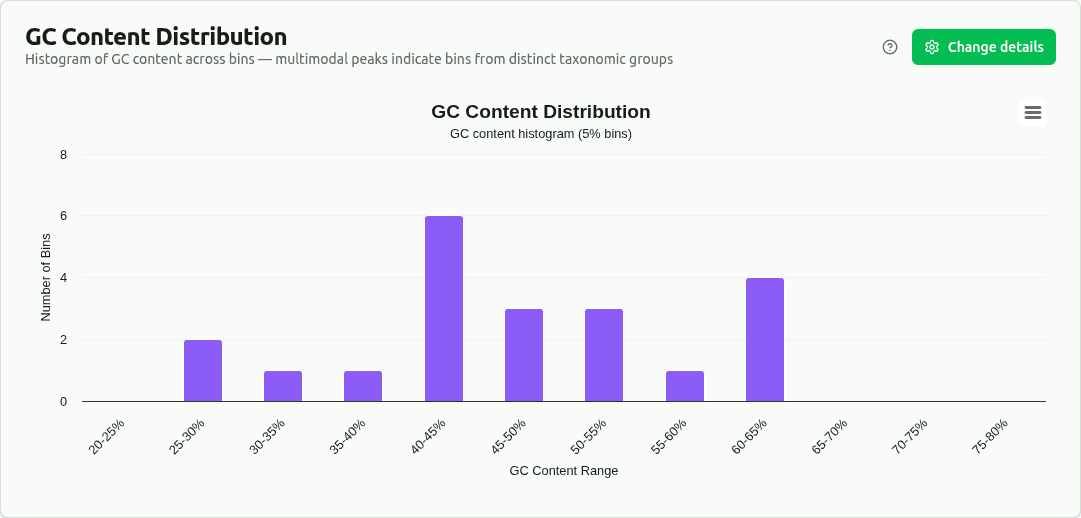
gc-content-histogram
Histograma de contenido GC en bins del 5%. Las distribuciones bimodales o multimodales sugieren recuperación de MAGs de grupos taxonómicos distintos, ya que diferentes taxones tienden a agruparse en rangos GC característicos.
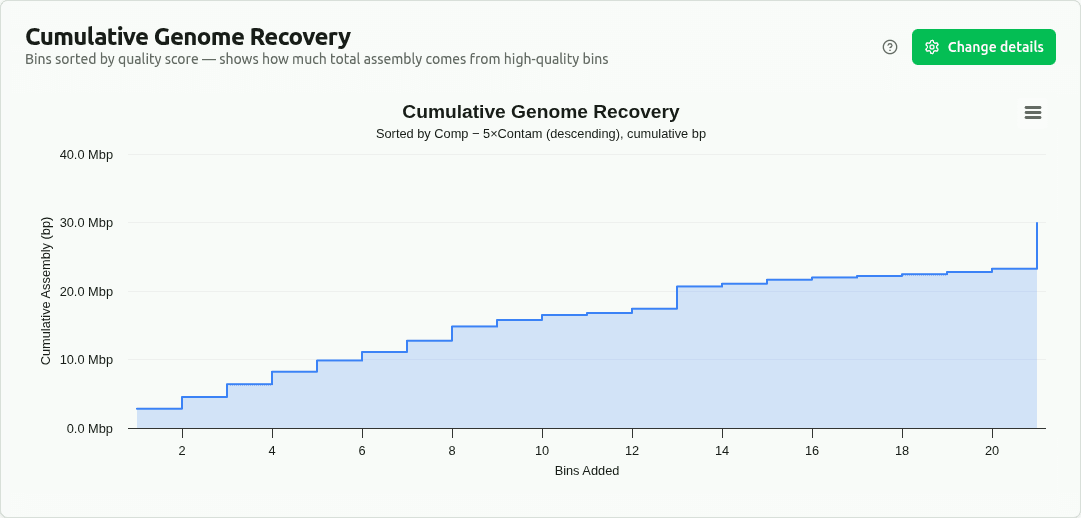
cumulative-genome-recovery
Gráfico de área acumulativa de pasos con bins clasificados por puntuación de calidad (Completitud − 5×Contaminación, descendente). El eje y muestra el total acumulativo del tamaño de genoma en bp. Un aumento inicial pronunciado indica que la mayoría de la secuencia ensamblada proviene de bins de alta calidad.
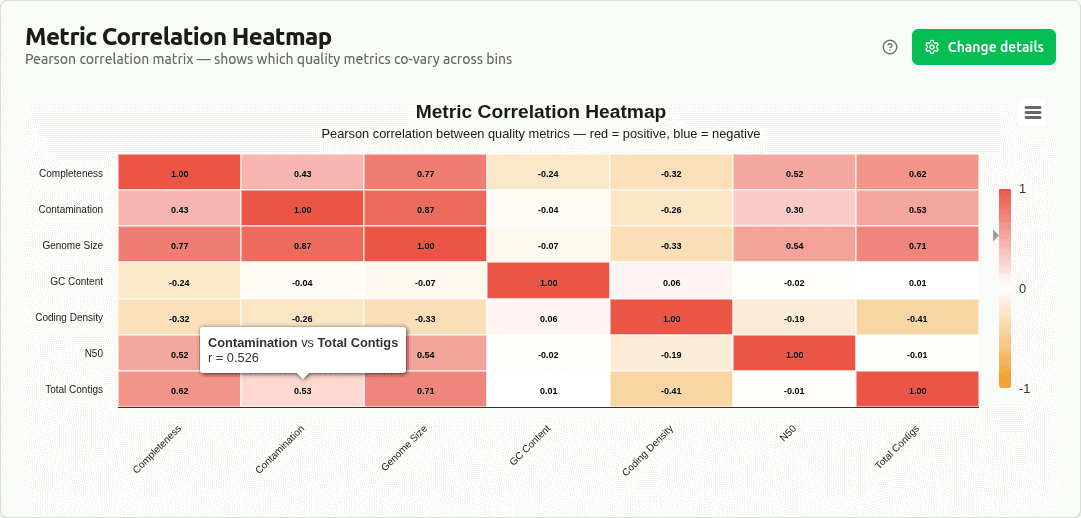
metric-correlation-heatmap
Matriz de correlación de Pearson simétrica a través de todas las métricas de calidad numéricas. Rojo = correlación positiva, azul = negativa. Revela qué métricas covarían (p. ej., completitud versus tamaño de genoma) y cuáles son independientes, útil para entender los impulsores de calidad de MAG.
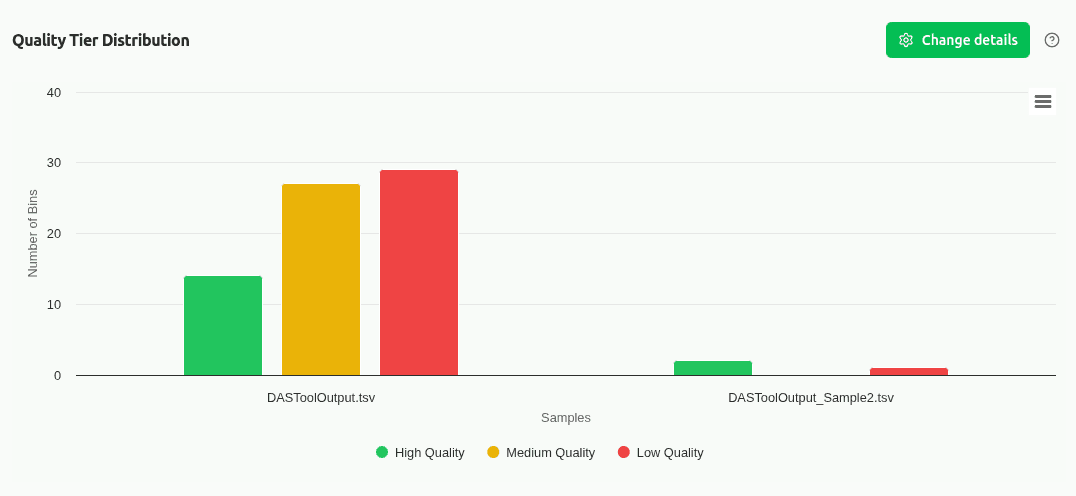
comp-quality-tiers
Gráfico de barras agrupadas comparando la distribución de niveles de calidad MIMAG (Alto / Medio / Bajo) a través de muestras. Cada grupo muestra una barra por muestra, permitiendo evaluación rápida de qué muestra produjo bins de mayor calidad en general.
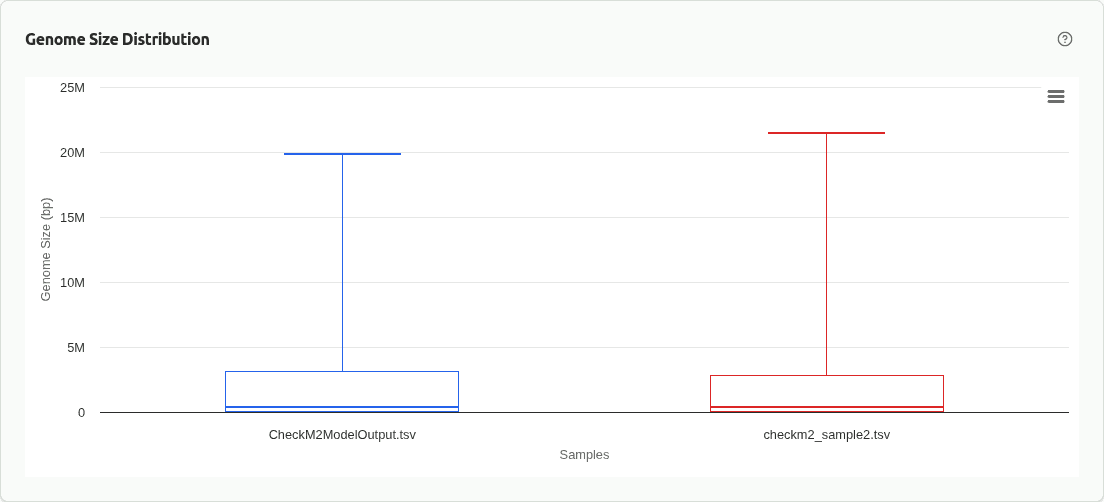
comp-genome-size
Gráfico de caja o gráfico de barras agrupadas comparando la distribución de tamaño de genoma de bins a través de muestras. Revela si ciertas muestras producen MAGs sistemáticamente más grandes o más pequeños, que puede reflejar diferencias en composición comunitaria.
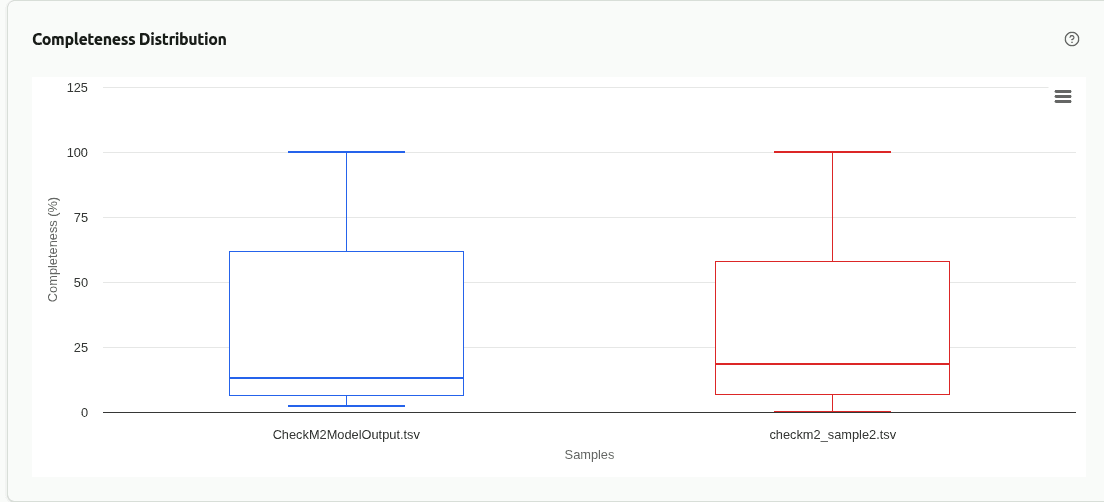
comp-completeness
Gráfico de caja comparando la distribución de completitud predicha por ML (%) a través de muestras. Las medianas más altas y rangos intercuartílicos más estrechos indican bins más consistentemente completos en esa muestra.
comp-contamination
Gráfico de caja comparando la distribución de contaminación (%) a través de muestras. Los valores más bajos son mejores — las muestras con contaminación elevada pueden necesitar parámetros de binning más estrictos o refinamiento adicional.
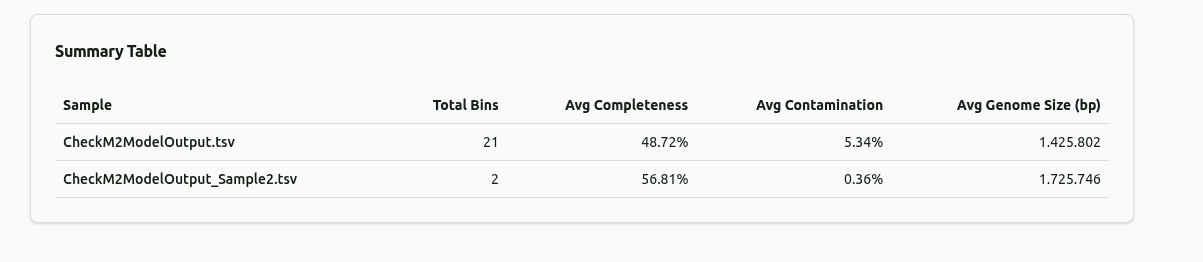
comp-summary-table
Tabla de resumen agregado mostrando métricas clave por muestra: número total de bins, completitud media, contaminación media, tamaño de genoma medio, y número de bins de alta calidad. Proporciona una descripción general numérica rápida para comparación entre muestras.
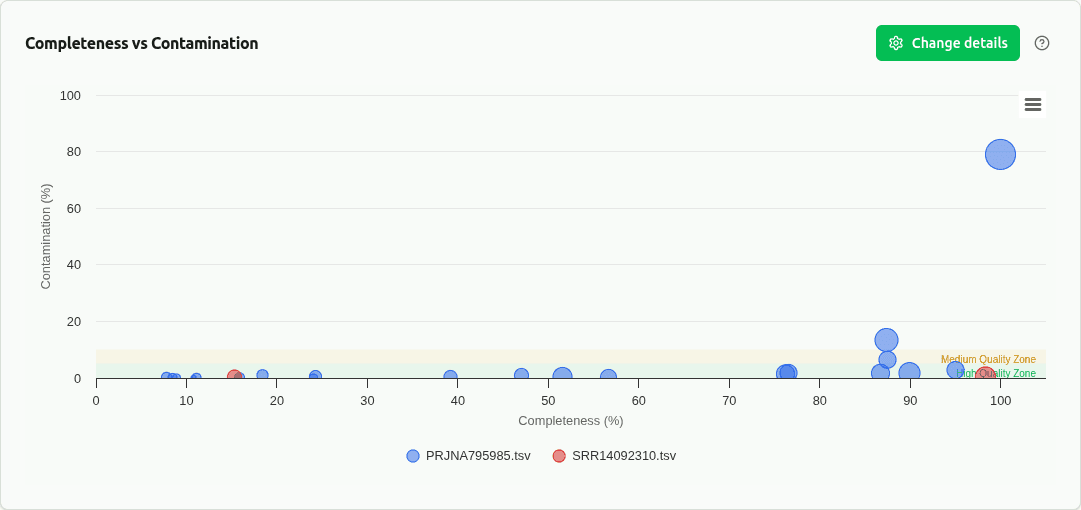
comp-scatter
Superposición de dispersión entre muestras de métricas de calidad MIMAG. Cada punto es un bin, coloreado por muestra. Las zonas de fondo marcan niveles de calidad MIMAG (Alto: >90% completitud & <5% contaminación; Medio: ≥50% & <10%). Visualización estándar en evaluaciones de CheckM2 y CAMI.
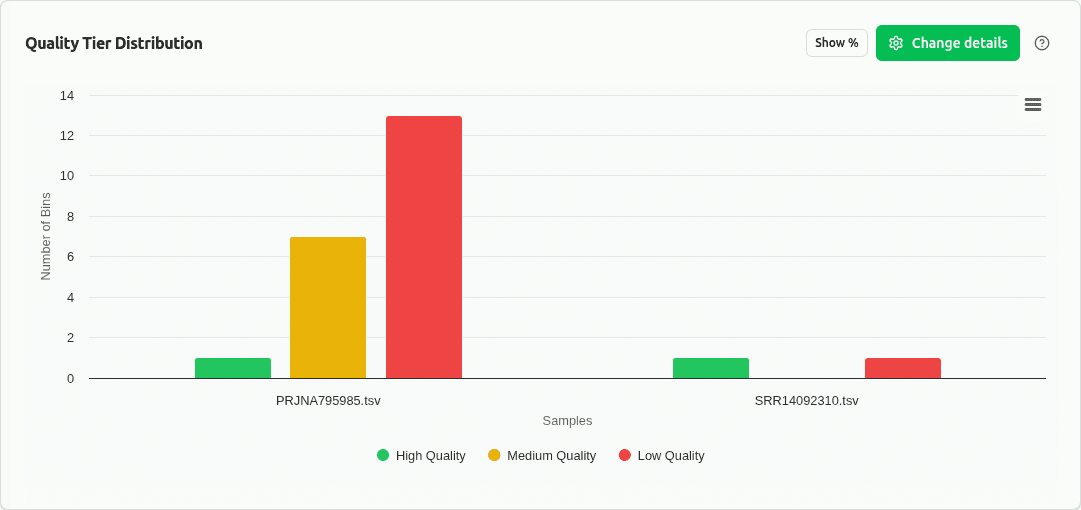
comp-quality-pct
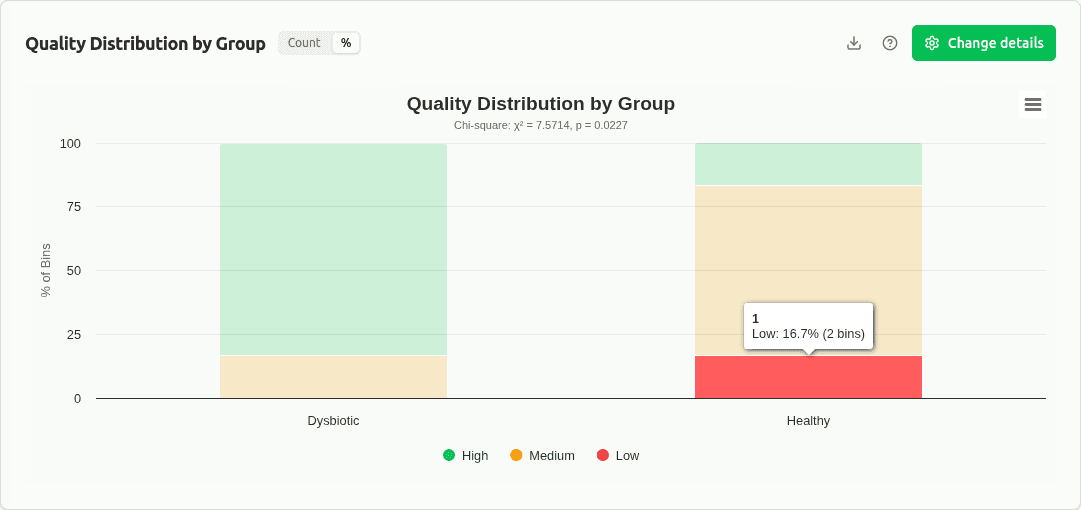
Gráfico de barras apiladas al 100% mostrando la proporción de bins de calidad Alto / Medio / Bajo por muestra. Normaliza por conteos de bins diferentes, permitiendo comparación directa de calidad de recuperación de MAG. Estándar en evaluaciones de desafíos CAMI.
comp-cdf
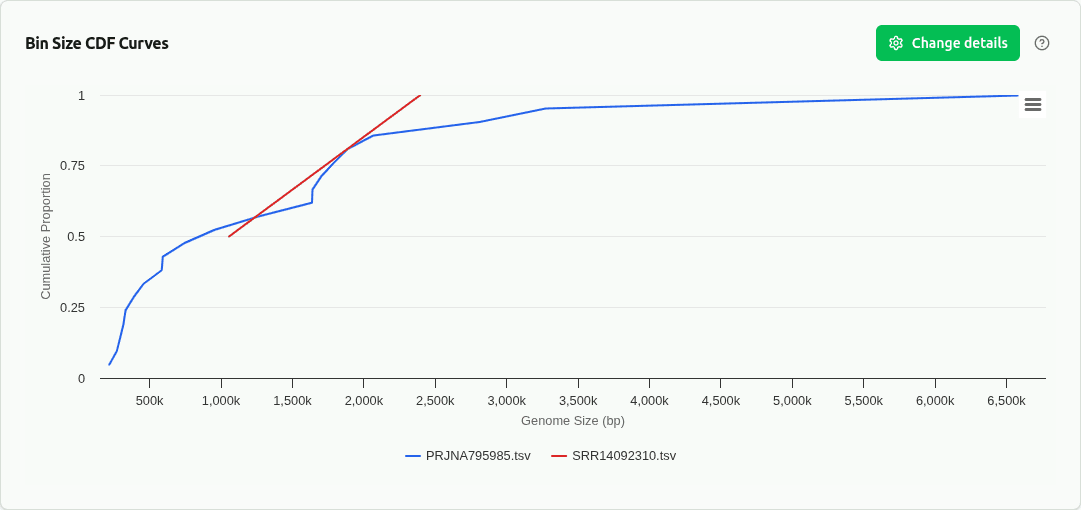
Función de distribución acumulativa empírica (CDF) de tamaños de bin superpuestos por muestra. Revela forma de distribución completa más allá de resúmenes de gráfico de caja — colas, bimodalidad, y qué fracción de bins excede umbrales de tamaño. Estándar en evaluación CAMI.
comp-gc-content
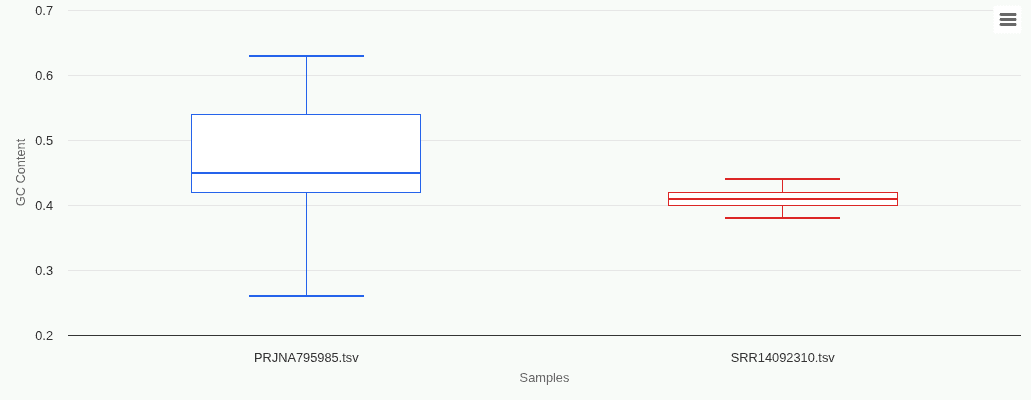
Gráfico de caja de distribución de contenido GC (%) por muestra. Los perfiles GC difieren a través de entornos (suelo vs. intestino vs. marino) y protocolos de extracción, sirviendo como proxy para diferencias en composición comunitaria.
comp-contig-n50
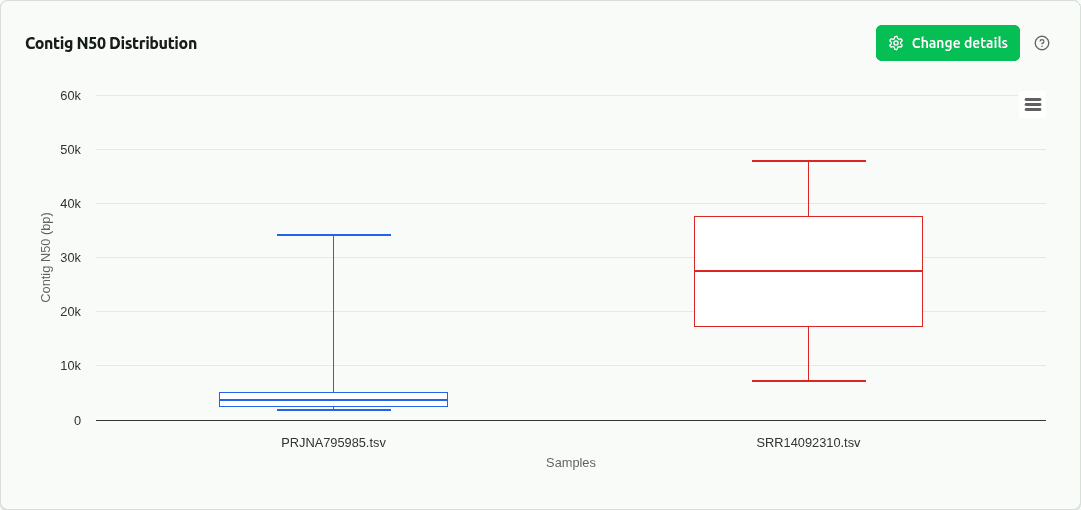
Gráfico de caja de N50 de contig por bin a través de muestras. N50 es la métrica primaria de continuidad de asamblea — valores más altos indican bins menos fragmentados. Reportado en prácticamente cada evaluación de calidad de MAG.
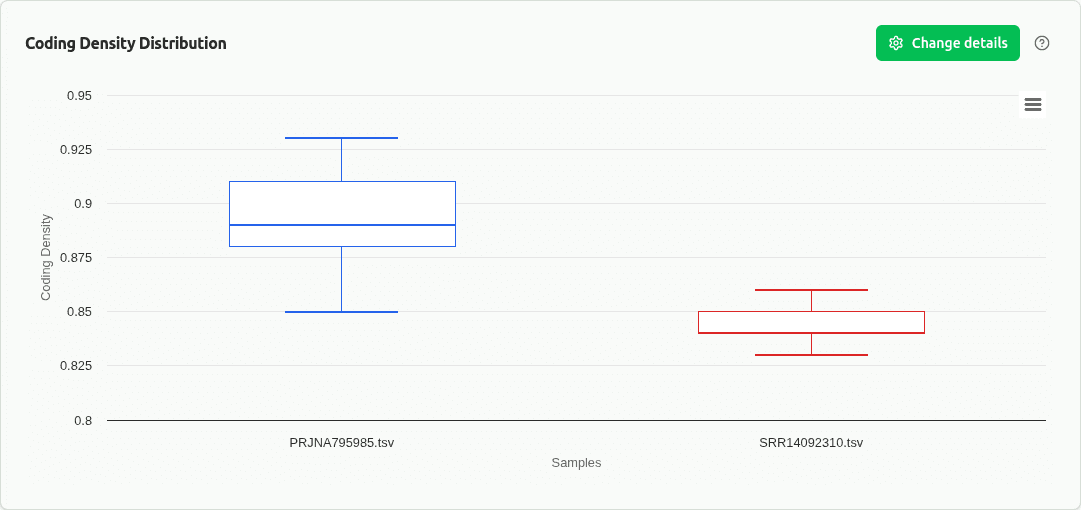
comp-coding-density
Gráfico de caja de densidad de codificación (fracción de genoma codificante de proteínas) por muestra. La baja densidad de codificación puede indicar contaminación con ADN no codificante o secuencias eucariotas. Evaluado por modelos de ML de CheckM2.
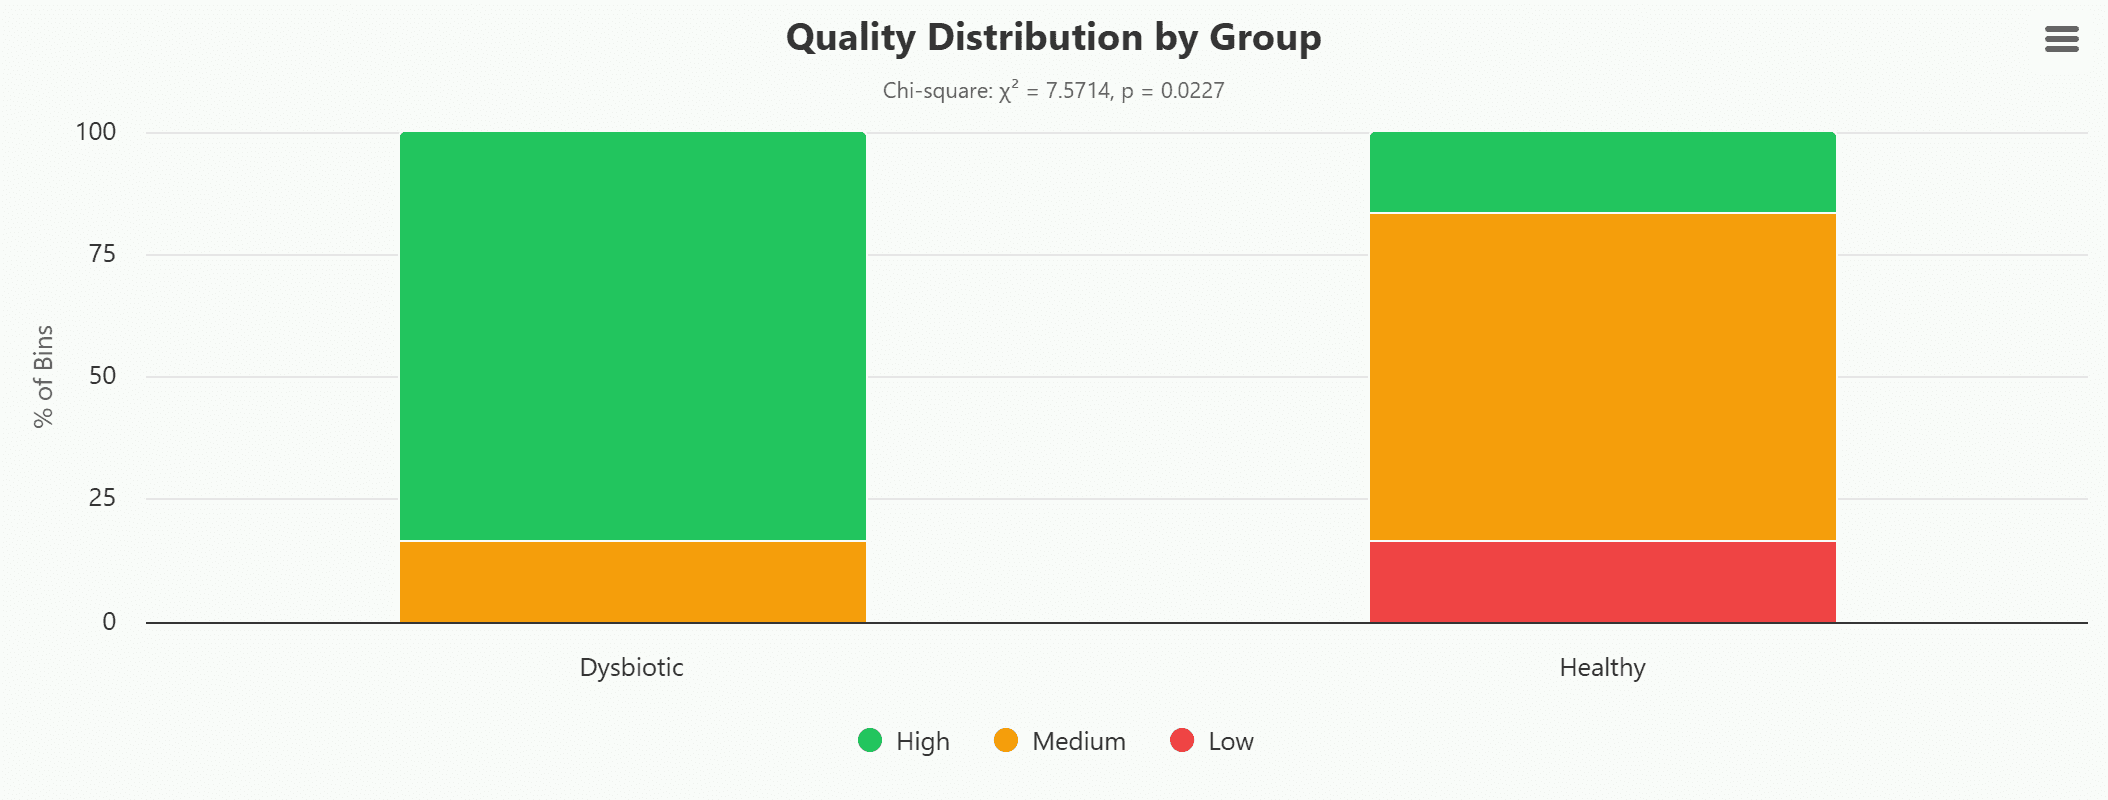
binning-group-quality-tiers
Gráfico de barras agrupadas de conteos de nivel de calidad MIMAG (Alto / Medio / Bajo) por grupo experimental, con prueba de Chi-cuadrado de independencia. Los niveles siguen Bowers et al.: Alto (>90% completitud, <5% contaminación), Medio (≥50%, <10%). Los valores p significativos de Chi-cuadrado indican que las distribuciones de calidad de MAG difieren entre grupos.
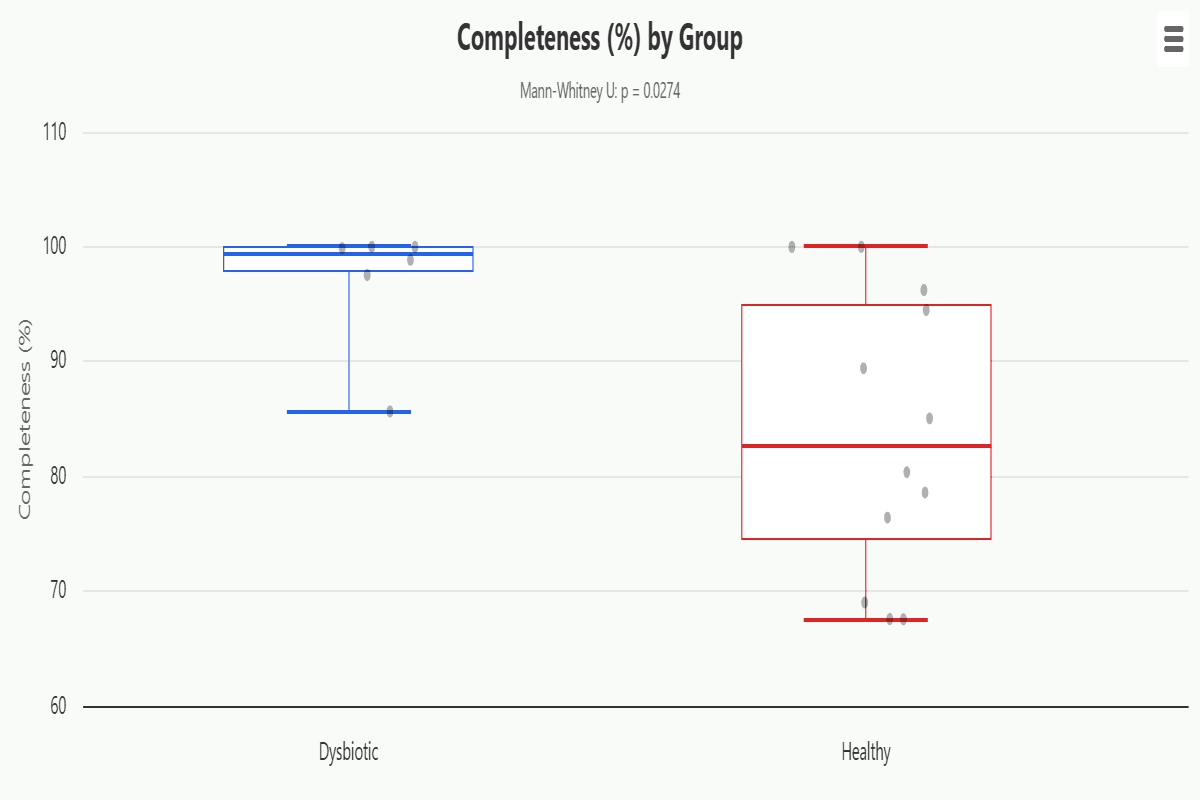
binning-group-metric-boxplots
Gráficos de caja comparando una métrica de calidad seleccionada (Completitud, Contaminación, Tamaño de Genoma, Contenido GC, N50, o Densidad de Codificación) a través de grupos. Todos los valores de bin individuales se agrupan por grupo. La prueba de Kruskal-Wallis (≥3 grupos) o prueba de Mann-Whitney U (2 grupos) evalúa significancia; las comparaciones pareadas utilizan corrección FDR de Benjamini-Hochberg.
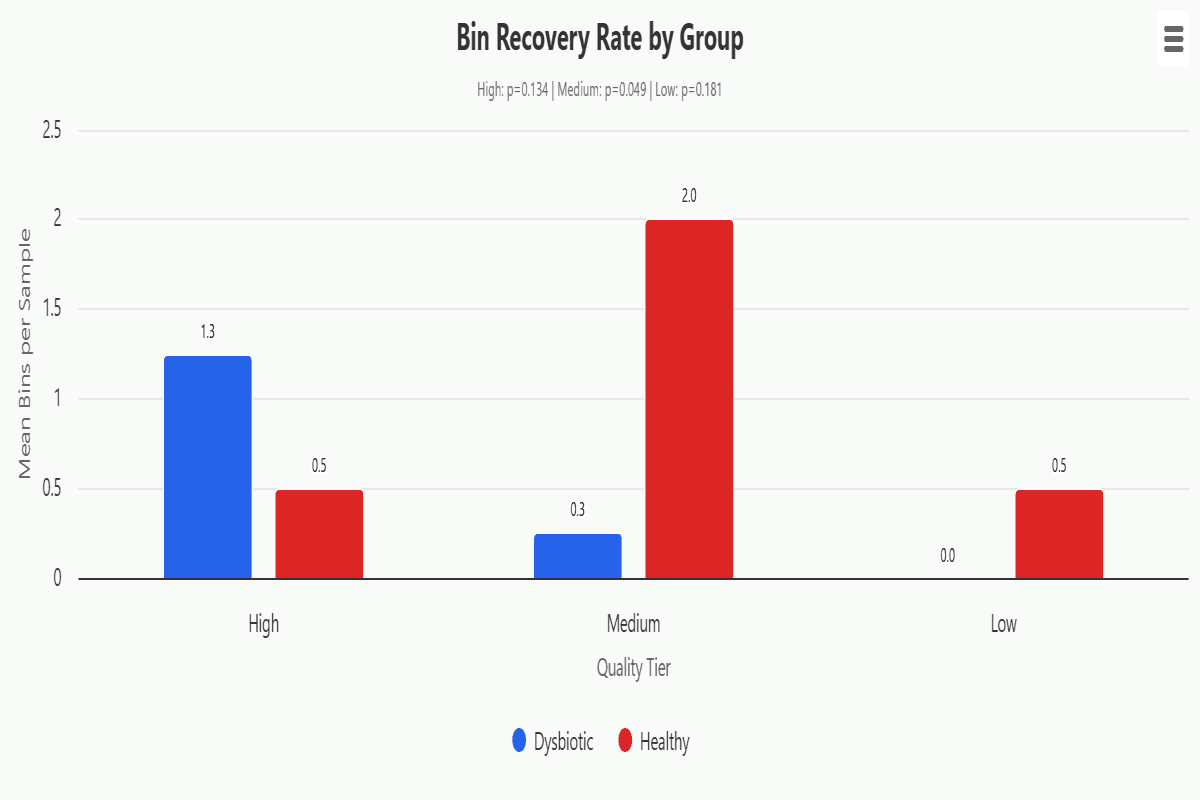
binning-group-recovery-rate
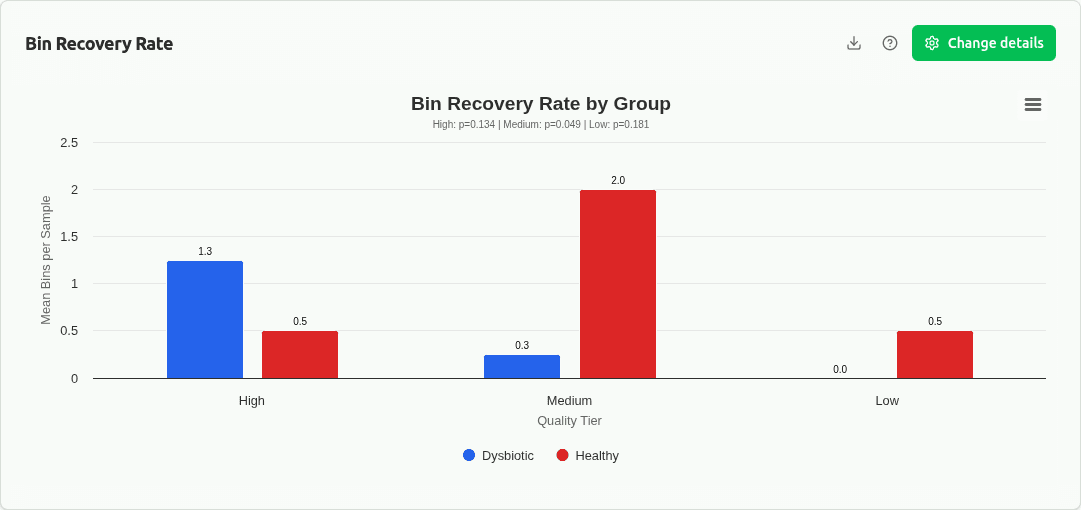
Gráfico de barras agrupadas de conteo de bin promedio por muestra en cada nivel de calidad (Alto, Medio, Bajo, Total) a través de grupos, con barras de error mostrando ±1 DE. Prueba si los grupos difieren en cuántos MAGs recuperan — un punto de referencia clave en el marco del desafío CAMI.
binning-group-pca
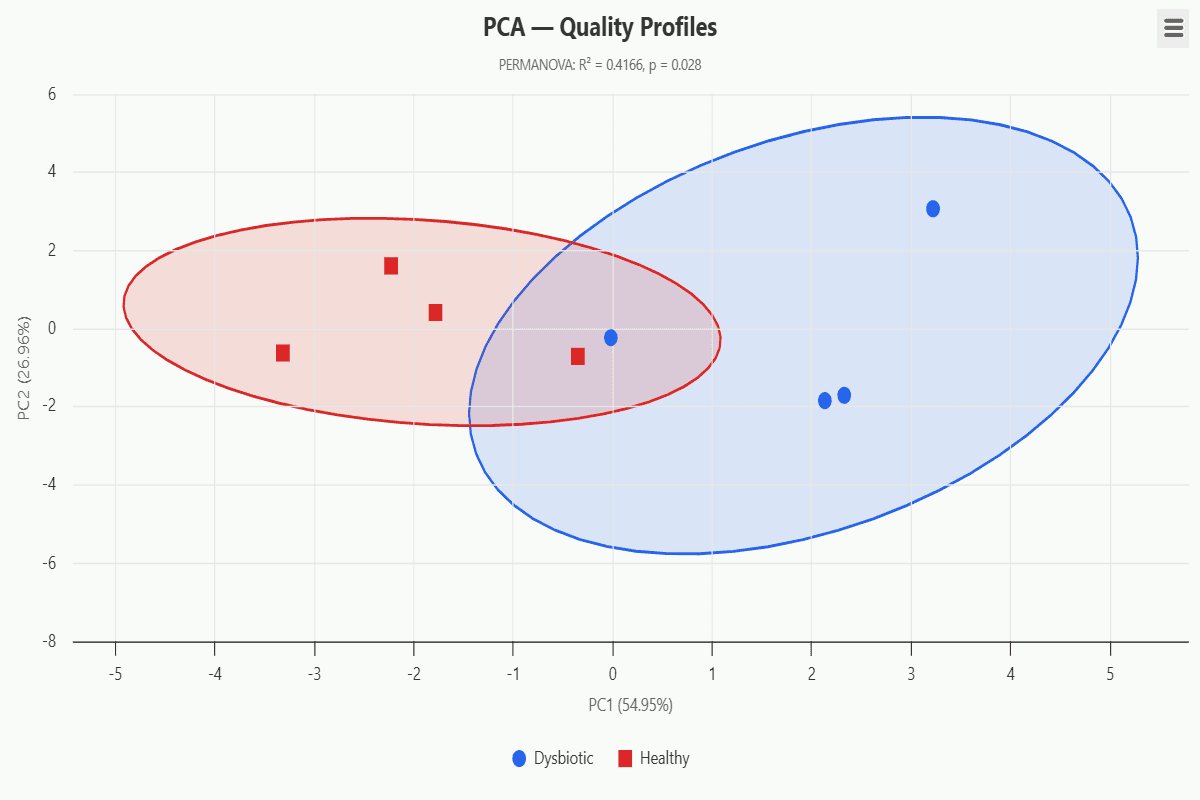
Ordenación PCA de perfiles de calidad por muestra (completitud media, contaminación, tamaño de genoma, GC, N50, densidad de codificación, %HQ, %MQ). Las características se estandarizan por puntuación z antes de descomposición. PERMANOVA en la matriz de distancia euclidiana prueba si los centroides de grupo difieren significativamente. Se dibujan elipses de confianza del 95% para grupos con ≥3 muestras.
binning-group-cdf
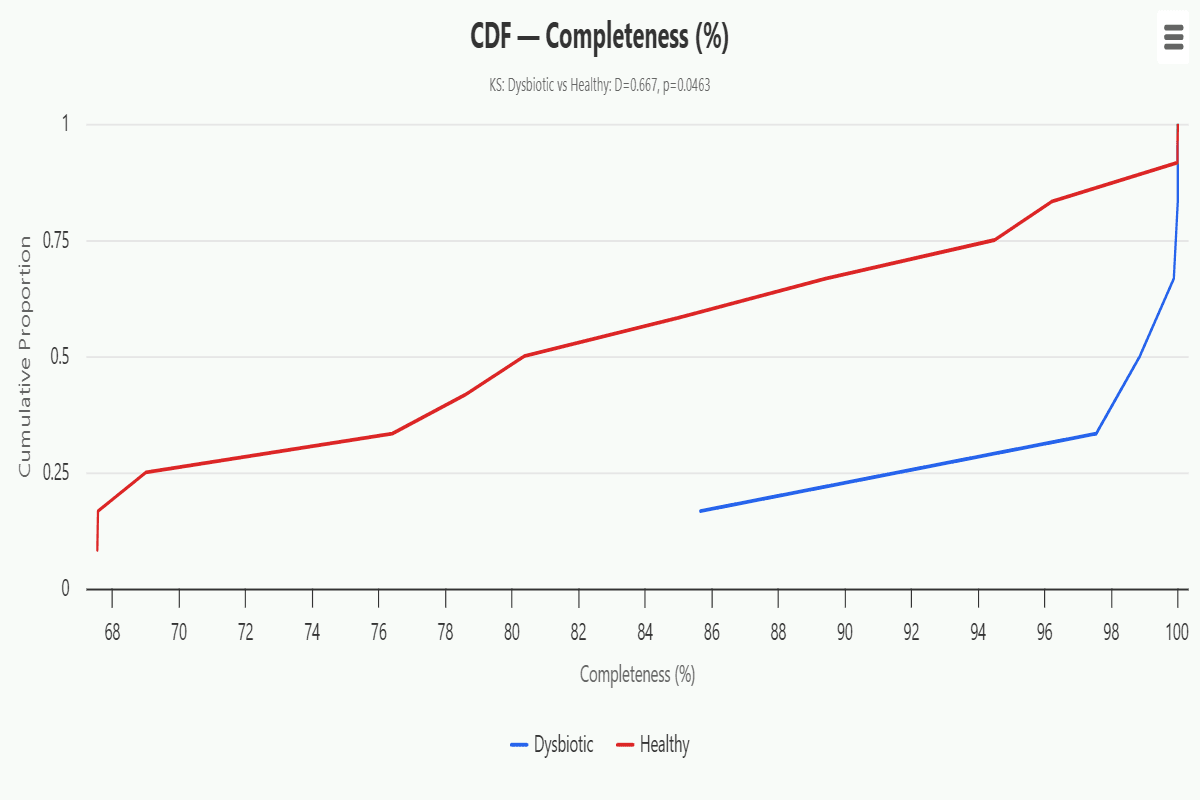
Funciones de distribución acumulativa empírica (CDFs) superpuestas de una métrica seleccionada a través de grupos. La prueba de Kolmogorov-Smirnov de dos muestras cuantifica la distancia vertical máxima entre curvas — las estadísticas D significativas indican que las distribuciones de métrica de los grupos difieren en ubicación, dispersión o forma.
binning-group-scatter
Superposición de dispersión entre grupos de métricas de calidad, coloreada por grupo. Muestra si los grupos experimentales producen perfiles de calidad de MAG sistemáticamente diferentes. Basado en estándares MIMAG.
binning-group-total-recovery
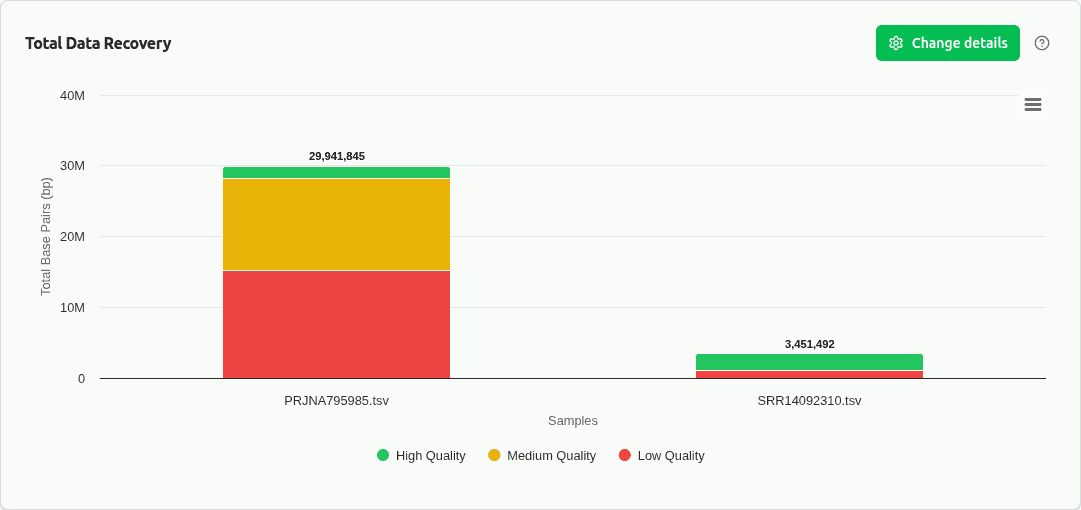
Gráfico de barras apiladas de pares de bases totales medios recuperados por grupo, divididos por nivel de calidad. Las barras de error muestran ±1 DE. Mide el volumen de datos real binned por grupo, complementando gráficos de conteo de bins y tasa de recuperación.