CLARK
物种分类CLARK(CLAssifier based on Reduced K-mers,基于精简 k-mer 的分类器)是一种监督式序列分类方法,使用特征 k-mer(特定分类单元特有的 k-mer)进行快速且精准的宏基因组分类。 [1]
如何获取输出模型文件
以下是团队运行的简要工作流,用于获取我们在工具页面上呈现的输出模型示例。
输入
FASTQ/FASTA 文件(单端或配对末端 reads)
输出
CSV 分类结果,包含置信度评分和估算丰度表
conda install -c bioconda clark
样本 1 人类肠道宏基因组(SRR14092160,500 万读段子集),使用 CLARK-l 对自定义 数据库(31 个肠道相关细菌基因组)进行分类。
- 1
从 NCBI SRA 下载 reads
prefetch SRR14092160 && fasterq-dump SRR14092160 -O /data --split-files && gzip /data/SRR14092160_*.fastq
人类肠道宏基因组,VRE 定植前时间点(Day -9)。Illumina 配对末端,约 550 万读段对(部分提取)。
- 2
子集化为 500 万读段并解压
zcat SRR14092160_1.fastq.gz | head -20000000 > subset_1.fastq && zcat SRR14092160_2.fastq.gz | head -20000000 > subset_2.fastq
CLARK 不支持 gzip 压缩的 FASTQ。500 万读段 = FASTQ 格式中的 2000 万行。
- 3
构建自定义 31 基因组数据库
通过 NCBI Datasets 下载 31 个 RefSeq 基因组,准备 targets.txt 和 NCBI 分类文件(nodes.dmp、names.dmp)。
- 4
运行 CLARK-l 分类
CLARK-l -T /db/targets.txt -D /db/custom_0/ -P subset_1.fastq subset_2.fastq -R clark_result -n 8 -m 0
CLARK-l 是轻量级模式(~4 GB RAM)。0.20% 分类(10,049 / 5,000,000 reads)。检测到 26 种物种。
- 5
估算丰度
estimate_abundance.sh -F clark_result.csv -D /db --highconfidence
生成 CSV 丰度文件供 IntMeta 读取。--highconfidence 标志过滤低置信度分配。
使用的材料
示例输出文件
下载工具页面演示中使用的输出文件。您可以直接上传到 IntMeta 来探索可视化。
单个和比较
分组分析
图表参考
IntMeta 中 CLARK 生成的所有 30 个可视化的详细描述。
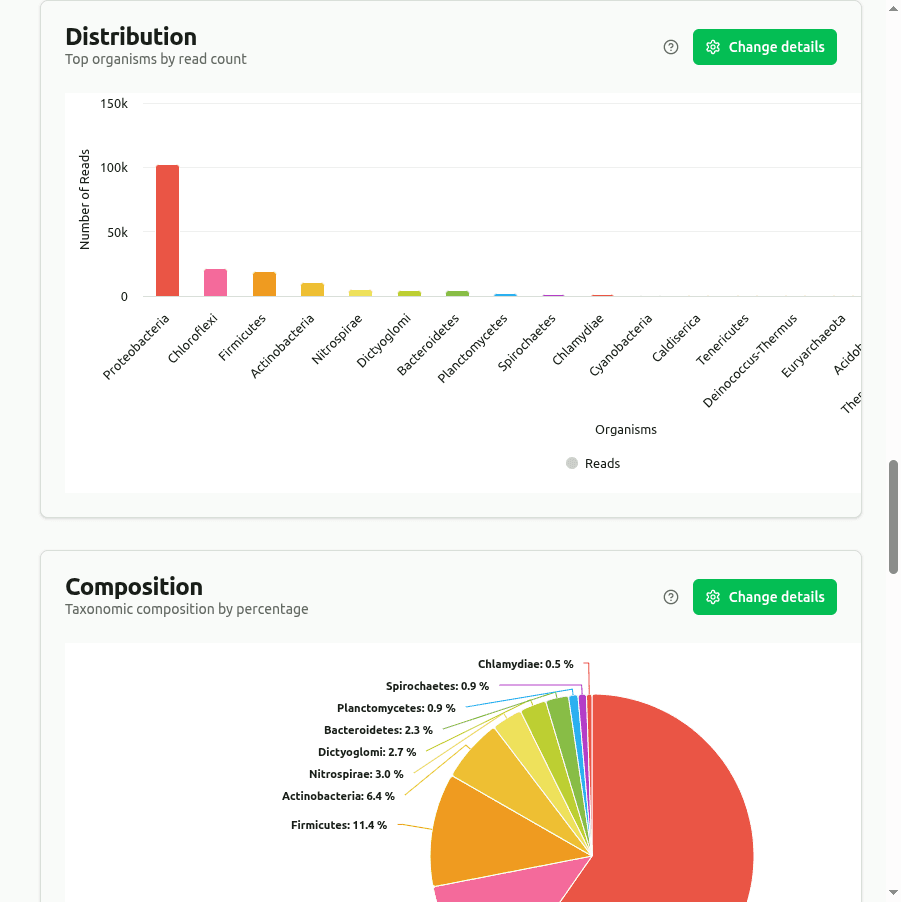
distribution
柱状图,展示 CLARK 判别式 k-mer 分类中按读段数排名靠前的生物体。仅计算与单个分类单元特有 k-mer 匹配的读段,产生高置信度的分配结果。
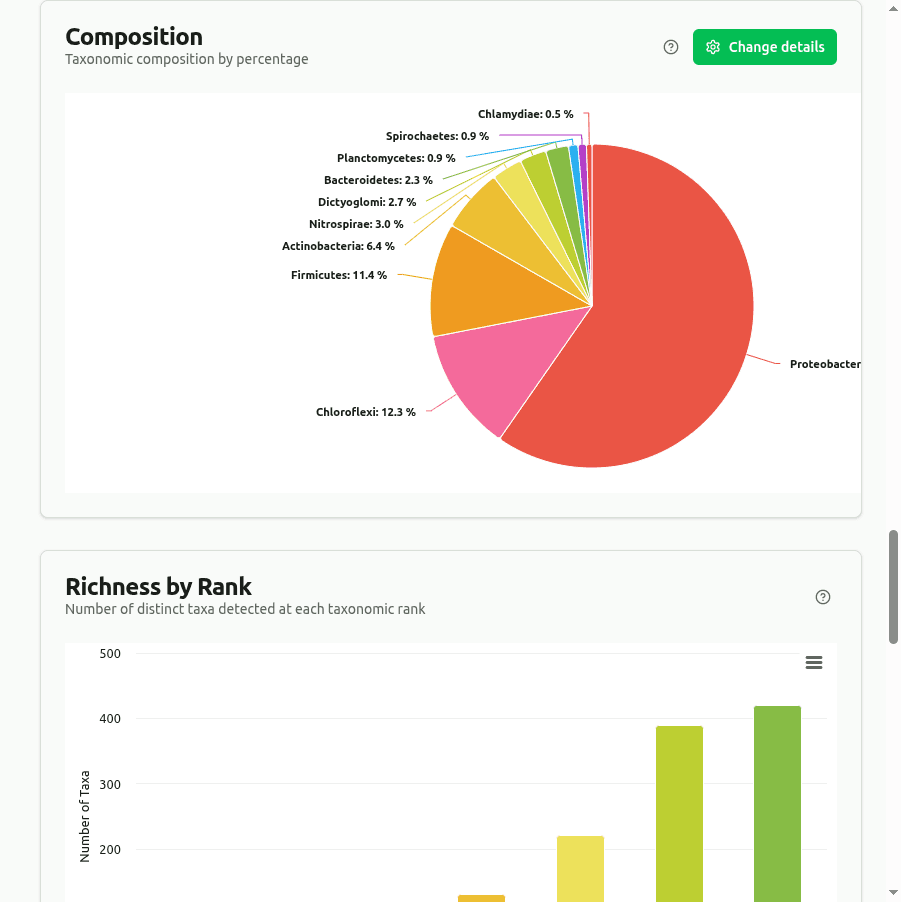
composition
饼图/环形图,展示按照所选排名靠前的分类单元,占其合并读段数的百分比。每个切片的值为(分类单元 reads 数 / 显示 reads 总数)× 100。
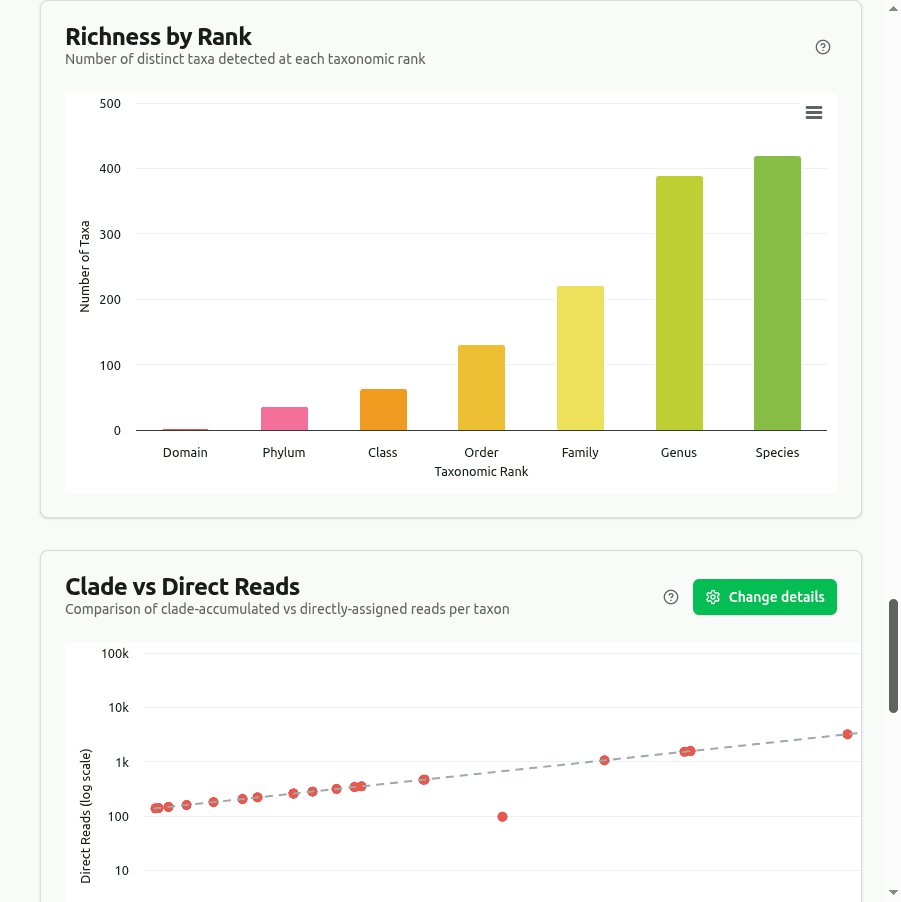
richness
统计在每个主要分类等级(Domain 到 Species)中至少有一条分配读段的不同生物体数量。CLARK 的判别式 k-mer 方法通常比 Kraken2 报告的分类单元数量少,但每个分配都具有更高的特异性。
diversity
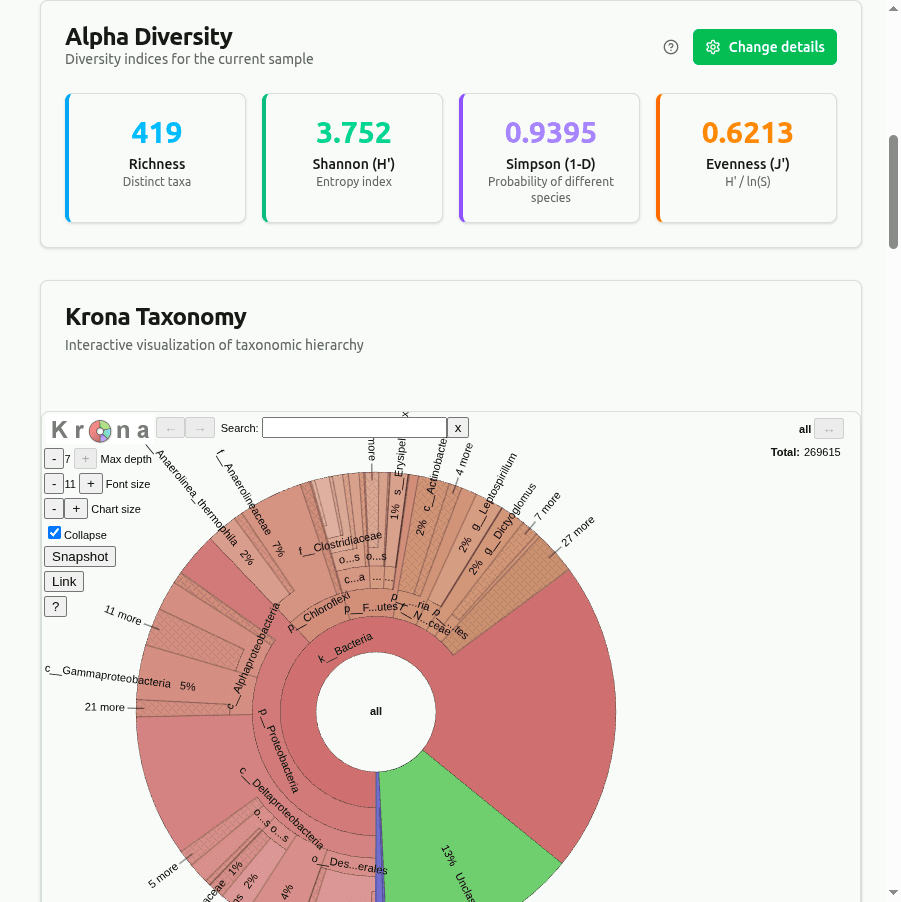
由各分类单元读段计数比例计算的 α 多样性指数:Shannon H = −Σ(pᵢ · ln pᵢ),Simpson D = 1 − Σ(nᵢ(nᵢ−1))/(N(N−1)),以及 Pielou 均匀度 J = H / ln(丰富度)。用于比较样本间的群落均匀性。
multilevel-composition
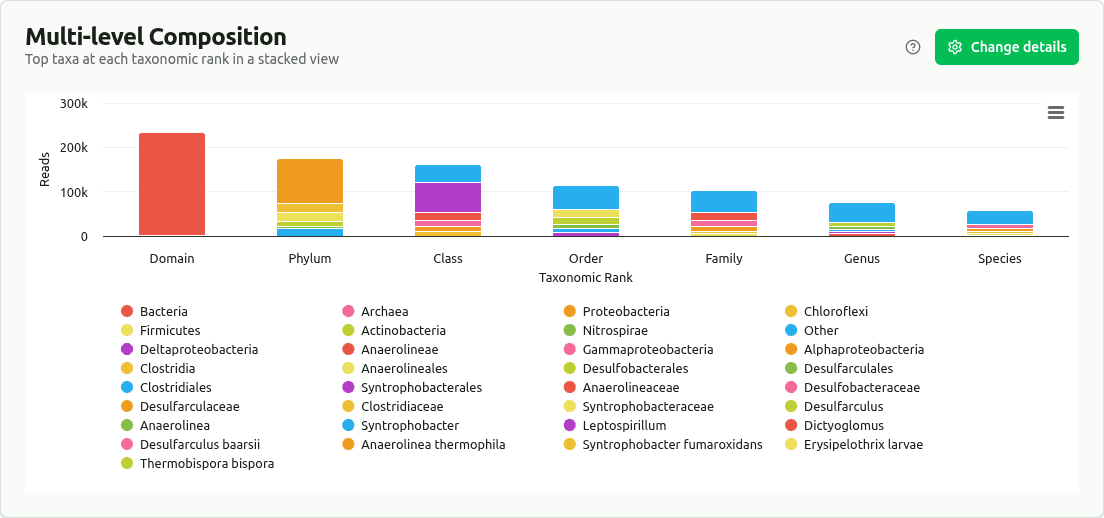
堆叠柱状图,展示在每个主要分类等级中按读段数排名靠前的分类单元;其余分类单元分组为 "其他"。显示主要生物体如何跨分类深度变化。
dependency-wheel
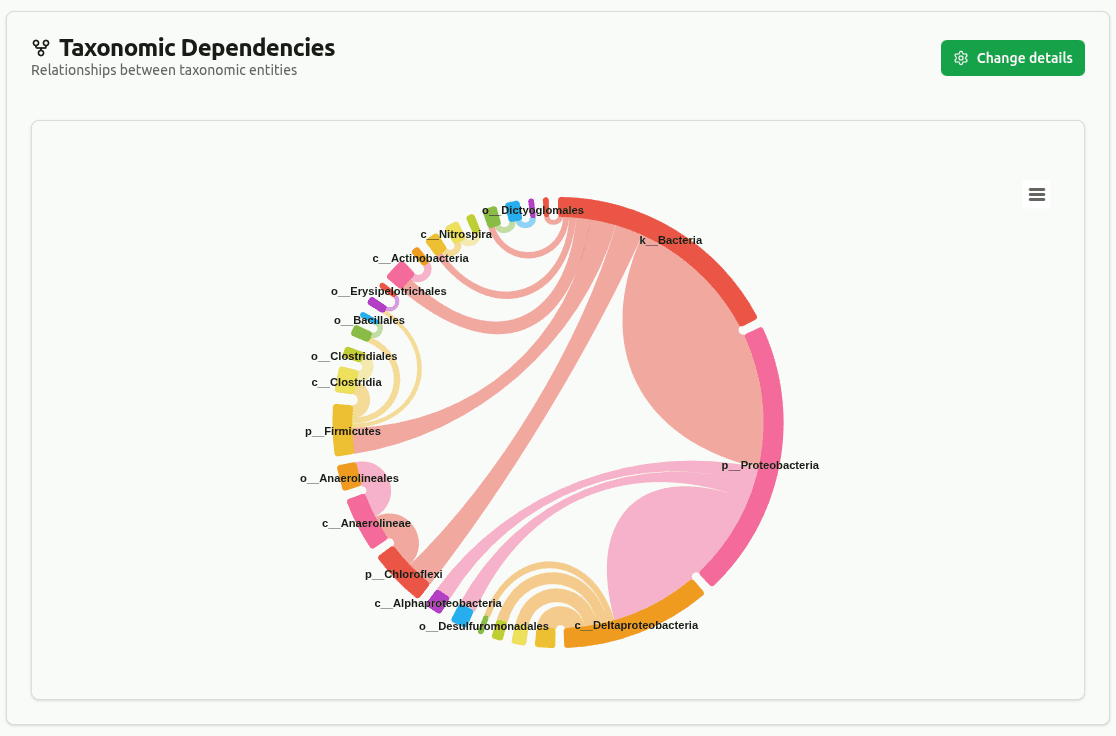
弦图,连接跨分类等级的亲本和子代分类单元,连接线厚度与共享读段数成正比。低于最小覆盖度阈值(默认 5%)的边被过滤。
sankey-flow
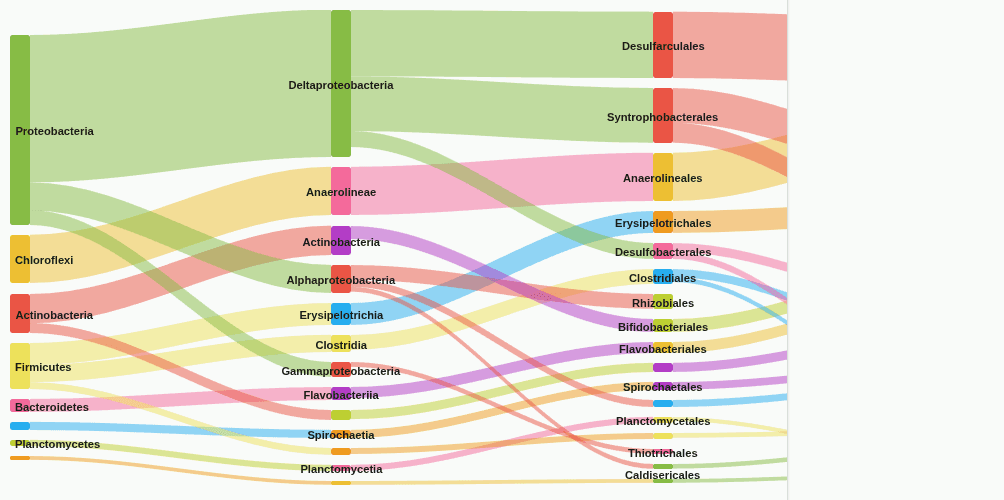
桑基流向图,追踪读段如何通过系统发生学层级从起始分类等级分配到末端分类等级。带状宽度等于连接分类单元间的读段数;低覆盖度边被移除。
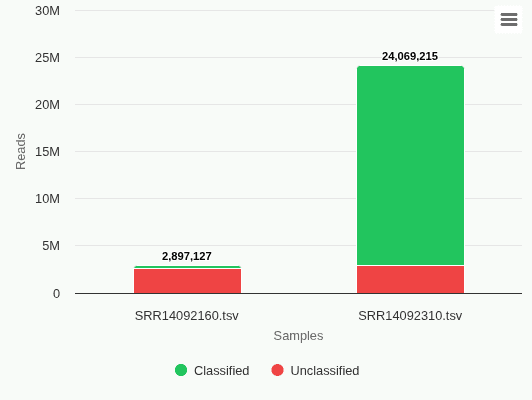
comp-classification
堆叠柱状图,展示每个样本的总分类与未分类读段。可快速比较样本间的分类率——未分类比例大可能表示新型生物体或数据库局限。
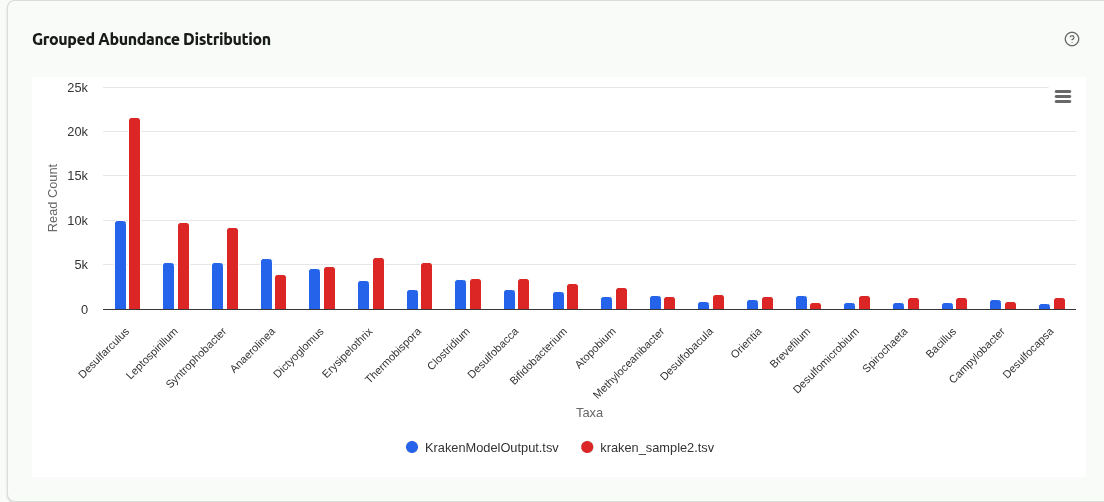
comp-grouped-abundance
分组柱状图,在所选分类等级将每个样本的排名靠前分类单元并排放置。每个分组包含每个样本一条柱子,按样本 ID 着色,可直接目视比较同一生物体在各样本间的绝对读段数。
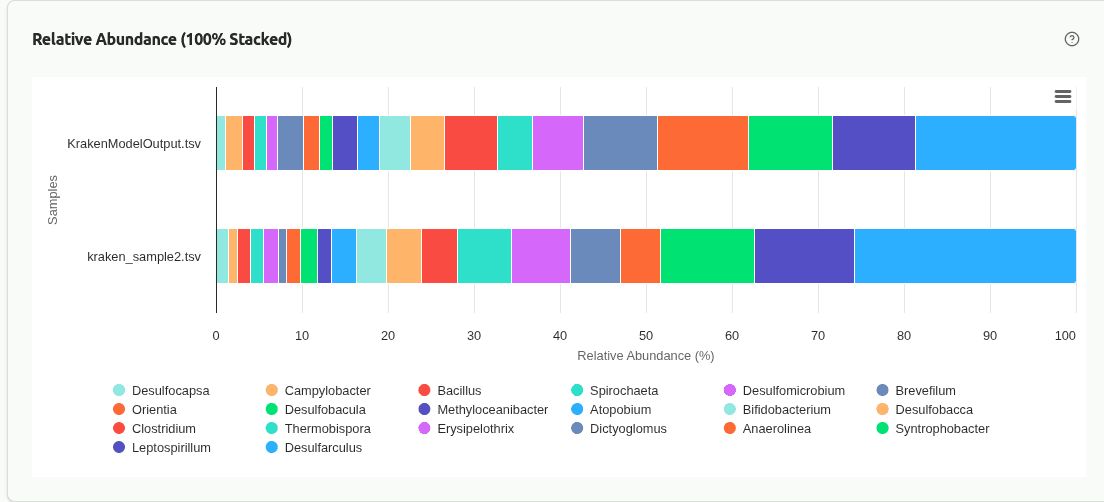
comp-relative-abundance
100% 堆叠柱状图,其中每条柱子代表一个样本,分段显示各分类单元的相对贡献。在样本测序深度差异很大时用于比较群落组成很有用,因为所有柱子都被标准化为相同高度。
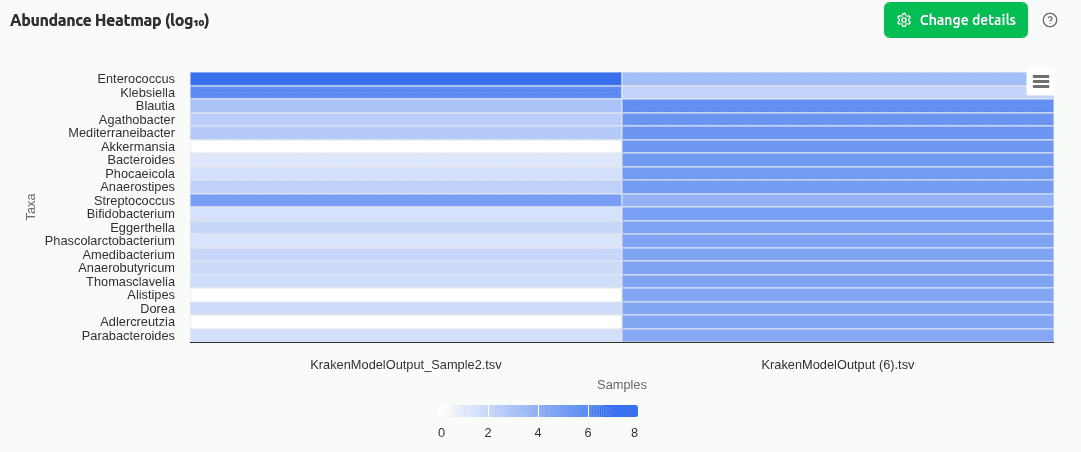
comp-abundance-heatmap
色块矩阵热图,一轴为分类单元,另一轴为样本。单元色深与所选分类等级的读段丰度成正比。两轴上的分层聚类将相似的样本和共现分类单元聚集在一起。
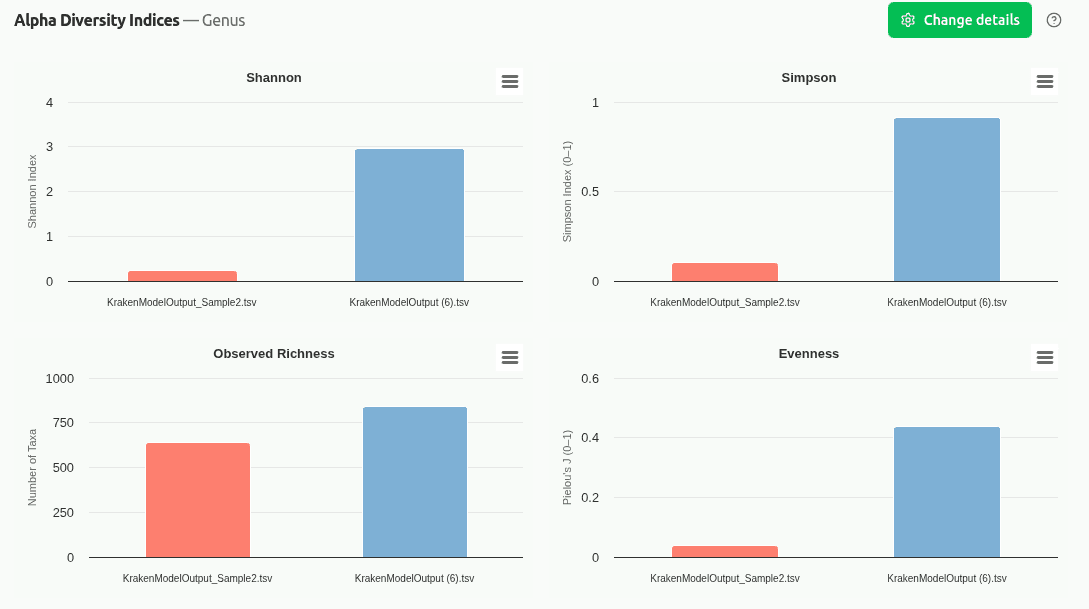
comp-diversity-indices
多面板图表,为每个样本单独在其 y 轴刻度上显示 Shannon 熵、Simpson 多样性、观测丰富度和 Pielou 均匀度。可快速实现样本间 α 多样性比较,无需缩放失真。
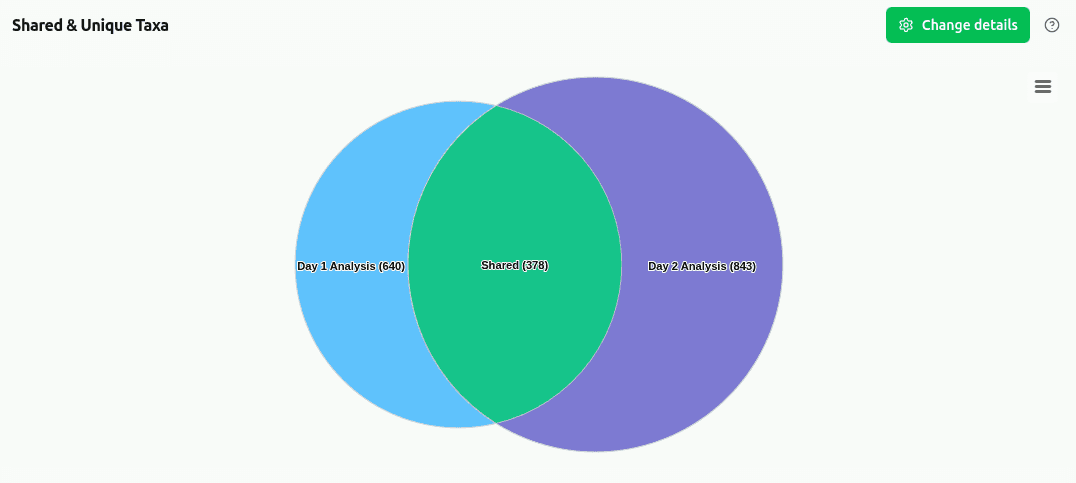
comp-shared-taxa
维恩图,展示样本间共享的分类单元数量与各个样本独有的分类单元。在所选分类等级使用读段 ≥ 1 的有/无计算。
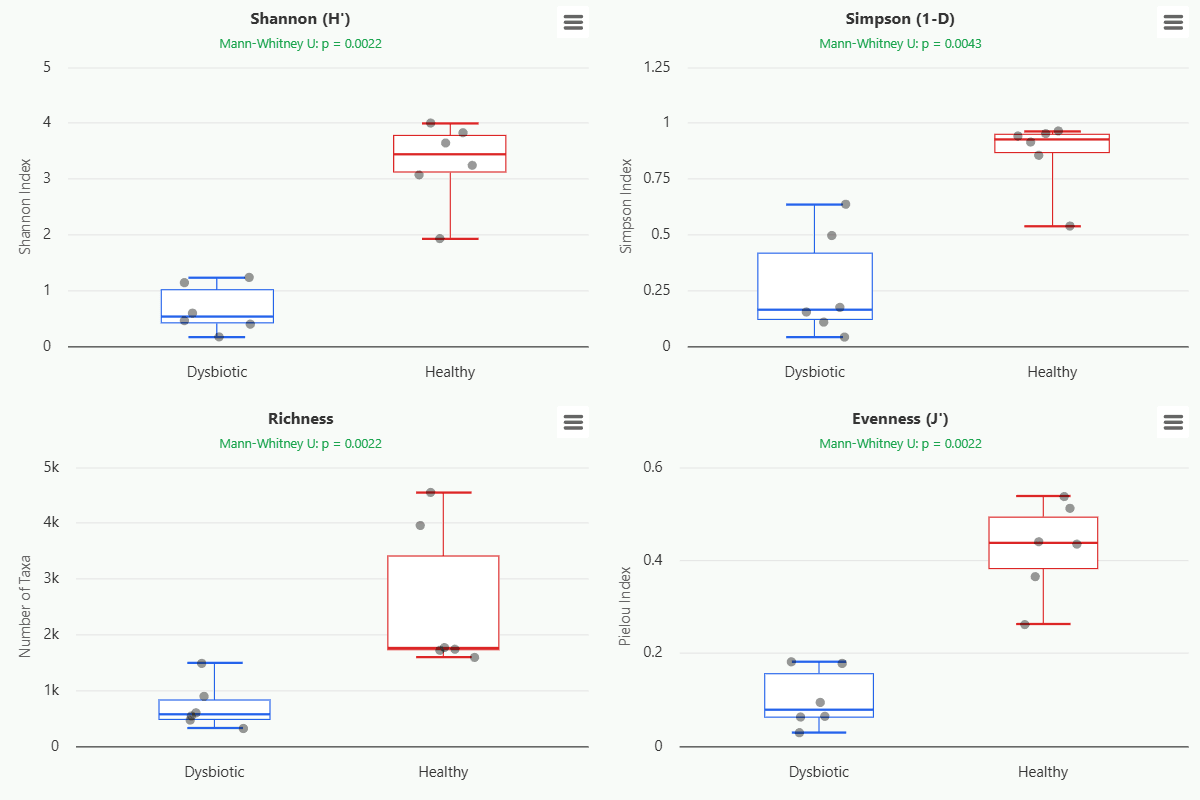
group-alpha-diversity
每组 Shannon 熵、Simpson 多样性、观测丰富度和 Pielou 均匀度的箱线图。每个盒子汇总组内变异。Kruskal-Wallis p 值检验组间的显著差异。
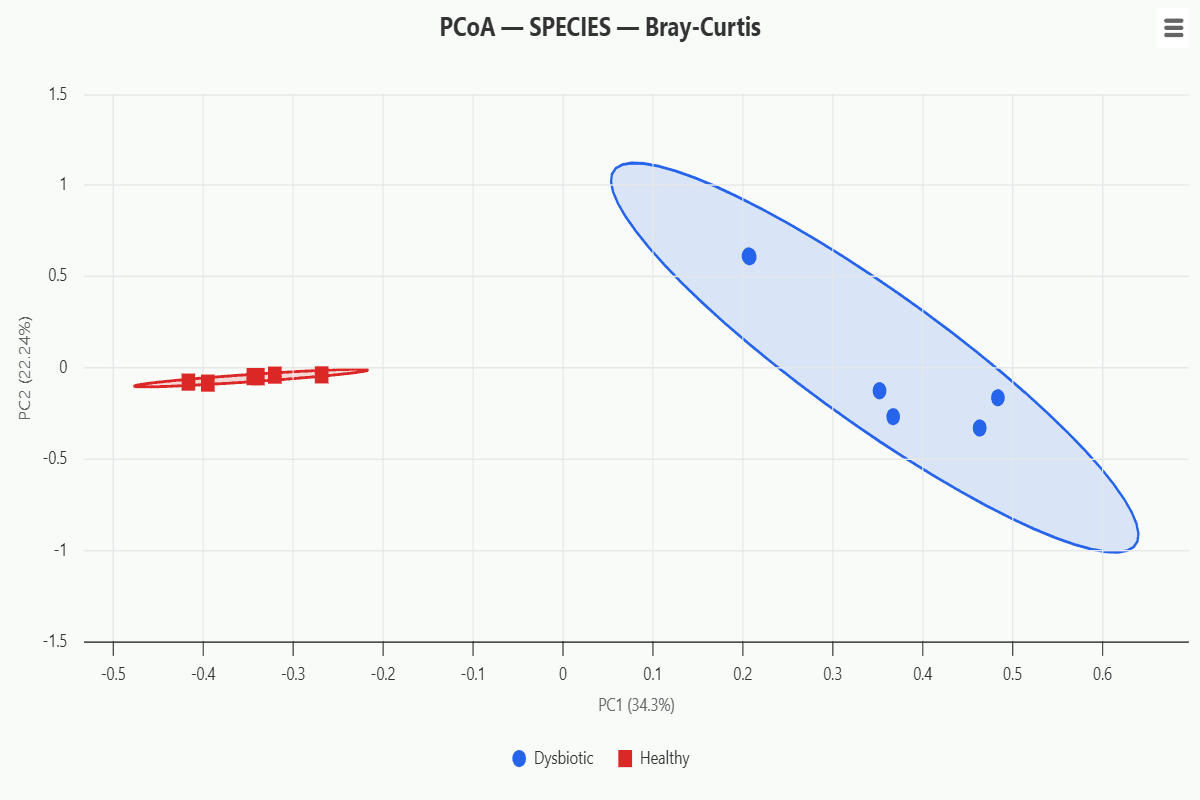
group-pcoa
基于 Bray-Curtis 异差矩阵的主坐标分析(PCoA)。点按组分配着色,带有 95% 置信椭圆。轴标签显示每个坐标解释的方差百分比。
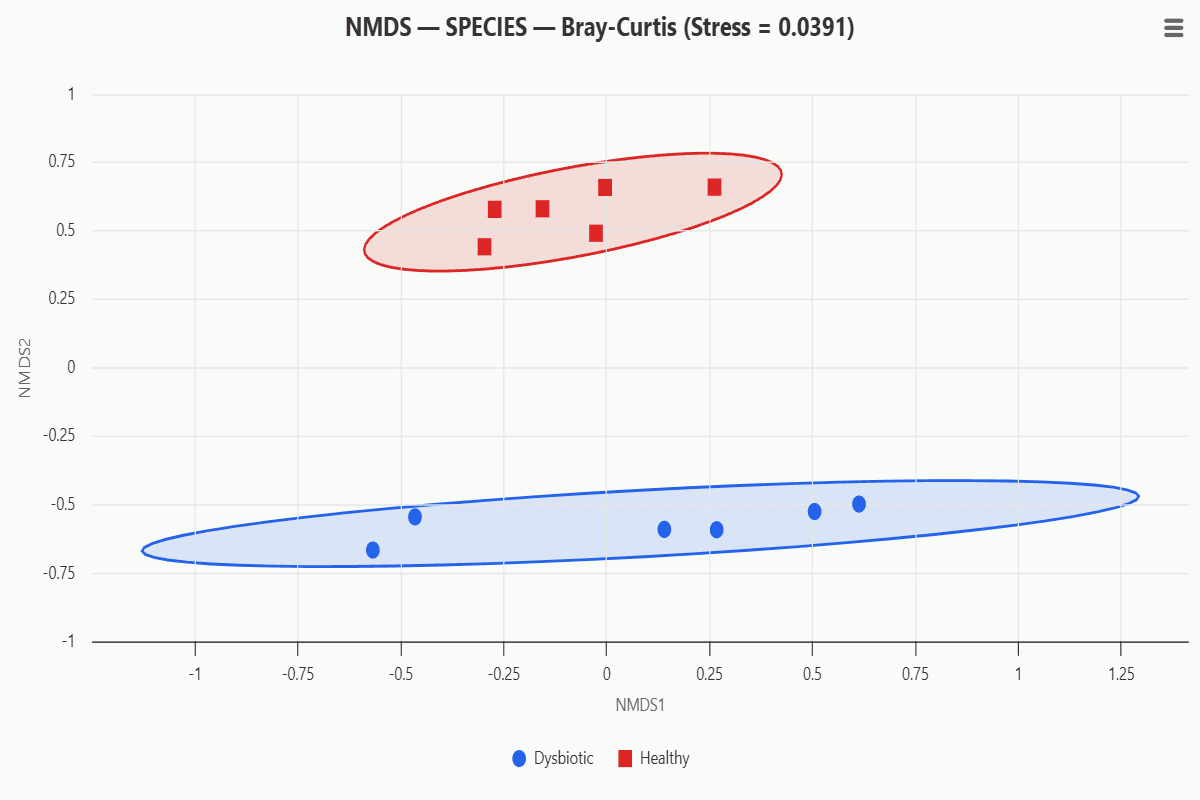
group-nmds
非度量多维缩放(NMDS)排序,显示应力值。点按组着色且带置信椭圆。较低的应力值(<0.2)表示原始距离在二维中的良好表示。
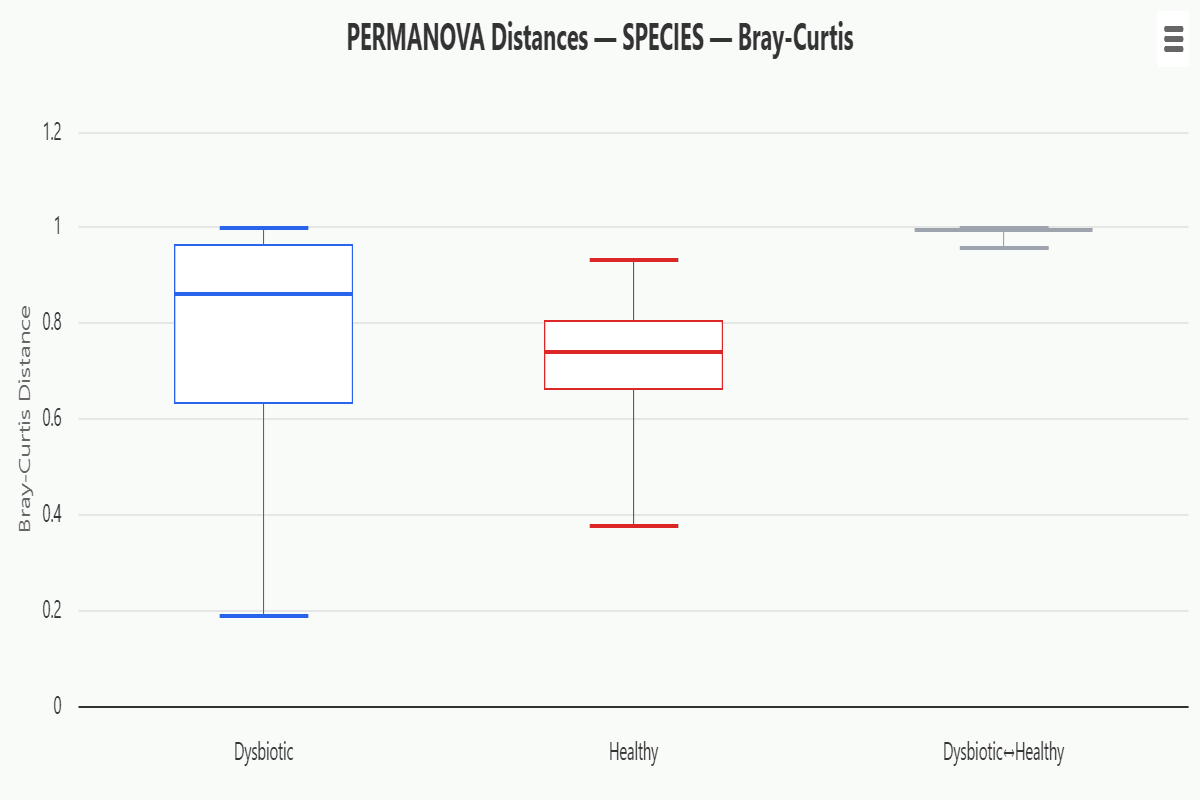
group-distance-boxplots
组内与组间 Bray-Curtis 距离的箱线图。PERMANOVA R² 和 p 值量化分组解释的方差比例。ANOSIM R 统计量衡量组间的分离程度。
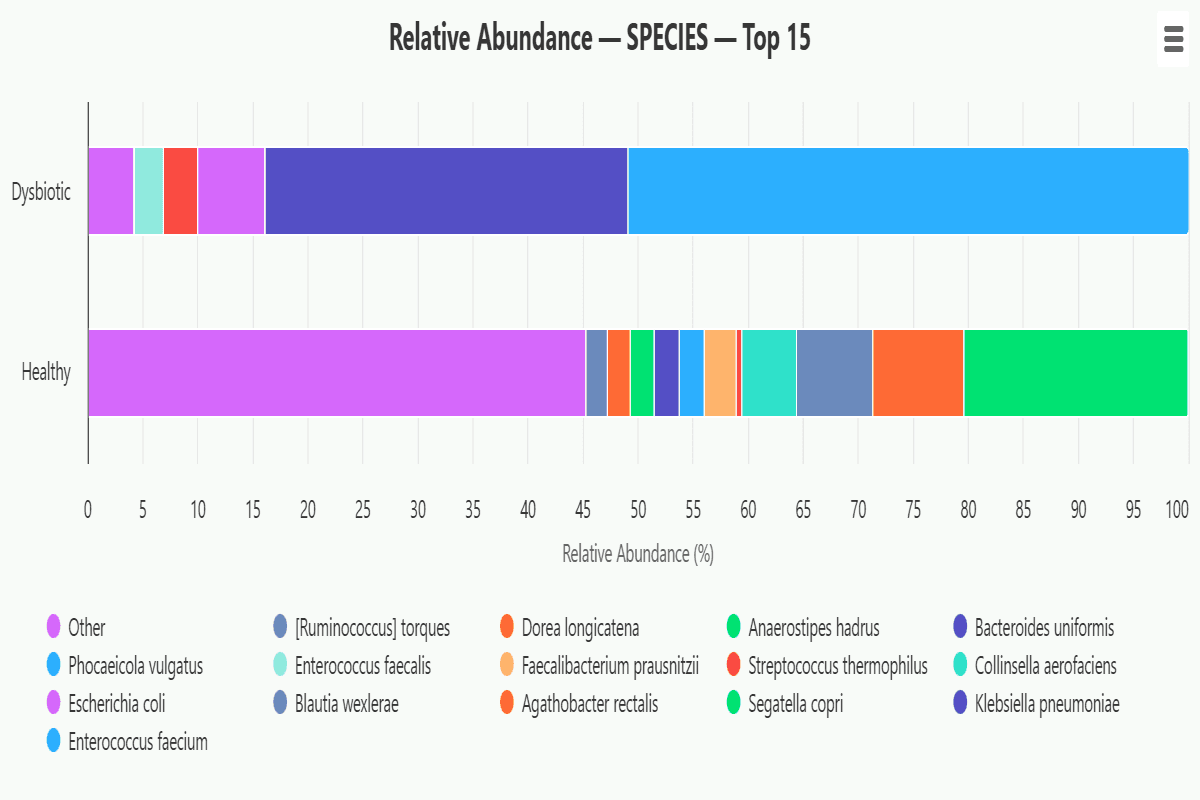
group-relative-abundance
组平均相对丰度,在所选分类等级显示为 100% 堆叠柱状图。每条柱子显示该组所有样本的平均相对组成,可直接进行组级比较。
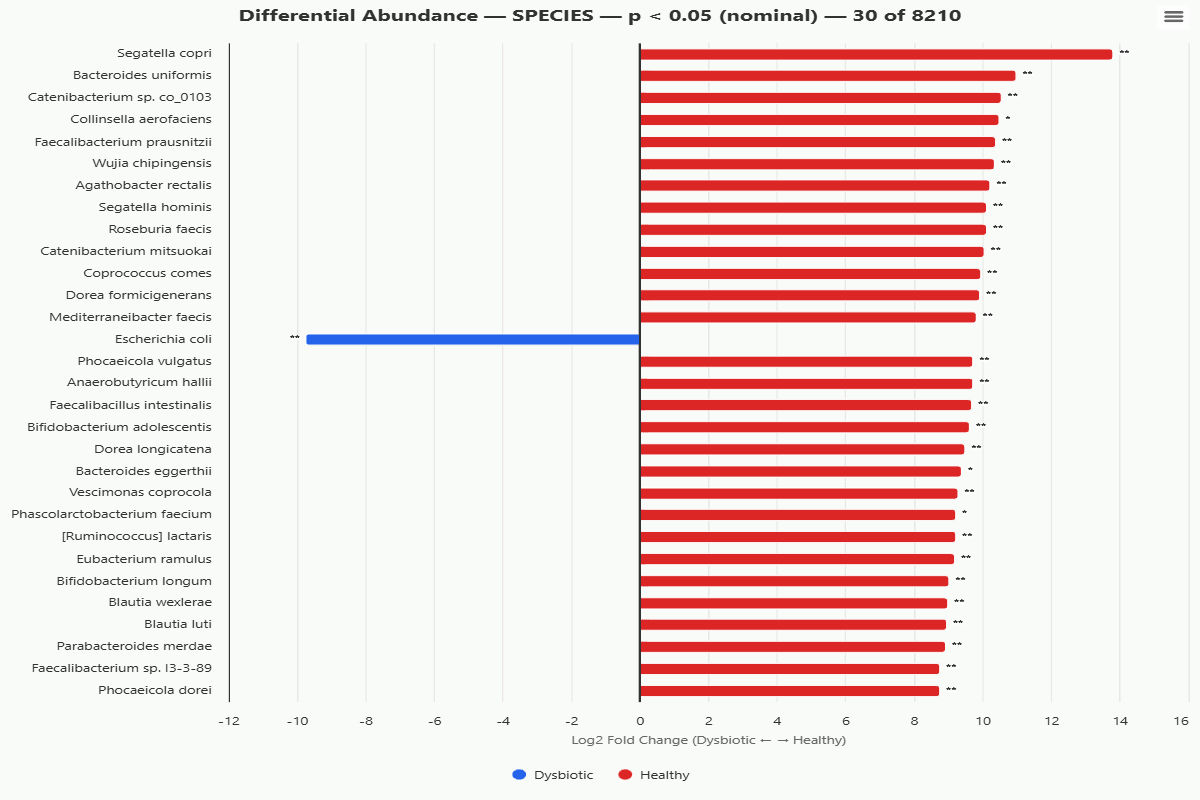
group-differential-abundance
分类单元的柱状图,显示组间具有显著丰度差异(Kruskal-Wallis 检验,Benjamini-Hochberg FDR 矫正)。颜色表示哪个组的丰度更高。仅显示通过显著性阈值的分类单元。
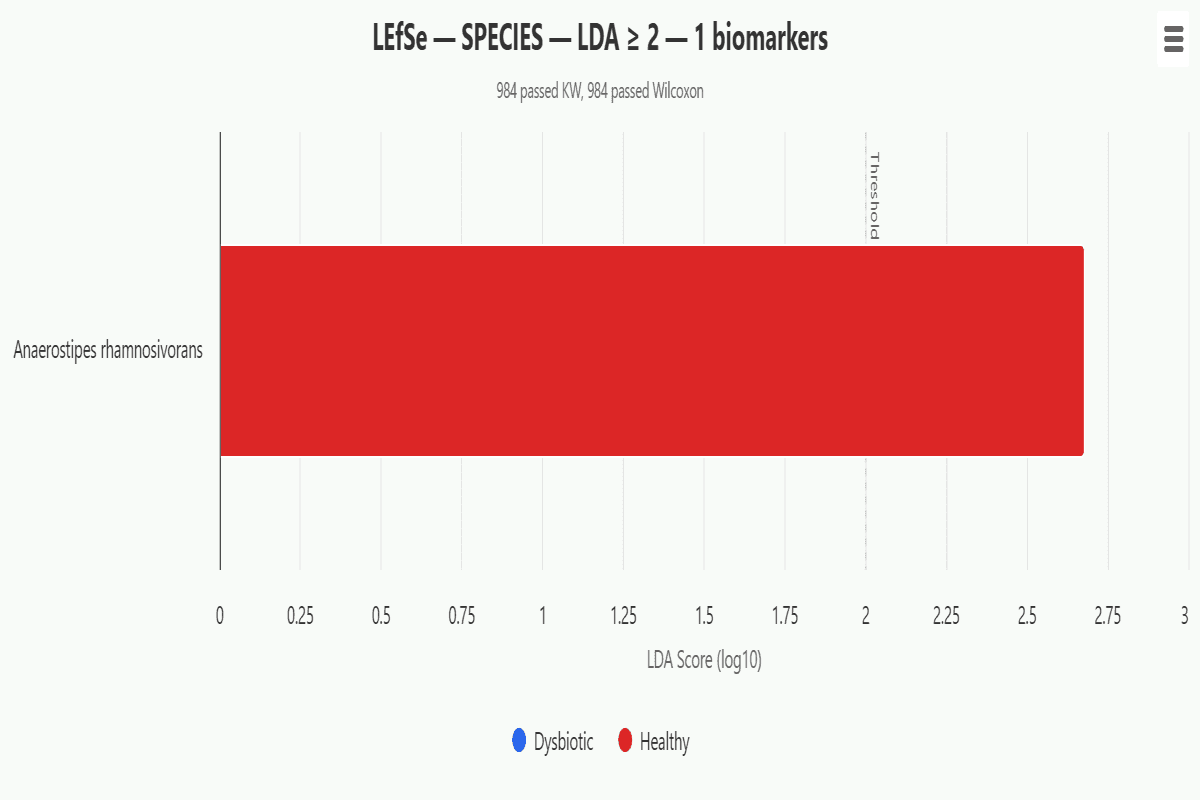
group-lefse
LEfSe(线性判别分析效应大小)生物标志物图表。水平柱显示在组间显著区分的分类单元的 LDA 分数。LDA 分数越高表示与相应组的关联越强。
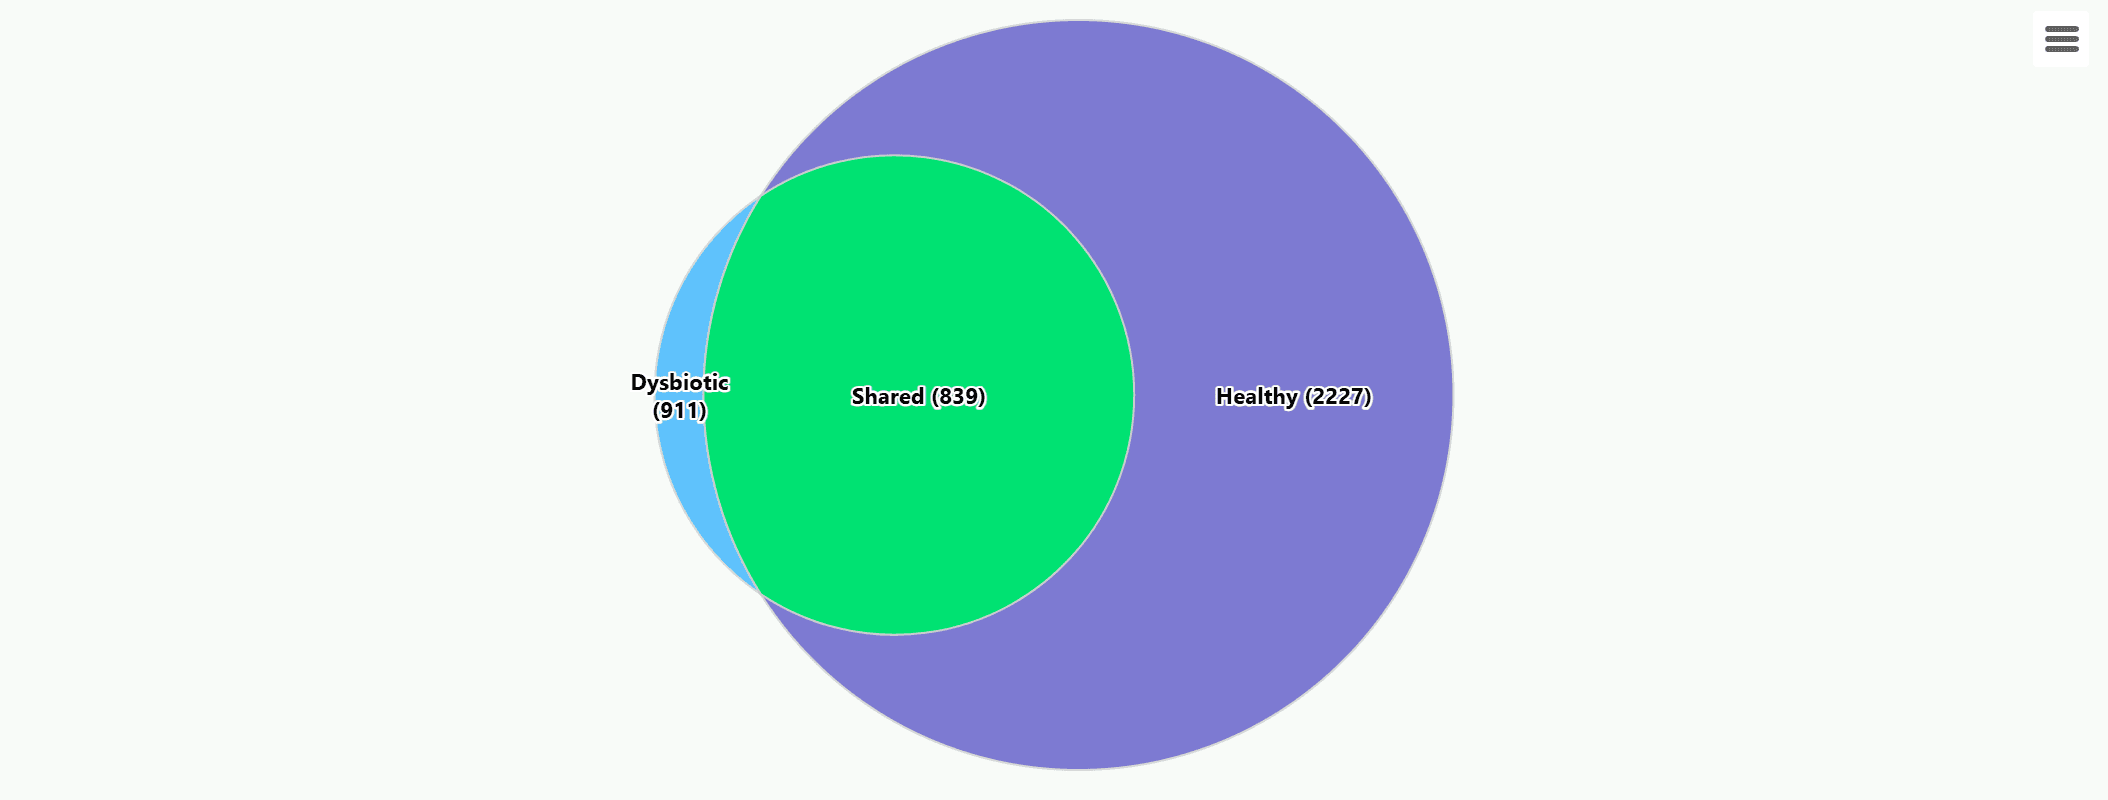
group-shared-taxa
维恩图,展示实验组间的共享和独有分类单元。每个组的分类单元集合是属于该组任何样本中检测到的所有分类单元的并集。点击区域查看具体分类单元列表及读段数。
group-classification
堆叠柱状图,显示每个实验组的平均分类与未分类读段。提示显示百分比分解和每个组的样本数。
group-distribution
分组柱状图,展示所选分类学水平排名前 N 位分类单元的平均读段数,按实验组分组。可比较组间的分类学丰度模式。
group-heatmap
热图,显示每个实验组(列)和分类单元(行)的平均 log₁₀ 转化读段数。色深反映丰度,可快速目视比较各组间的分类学图谱。
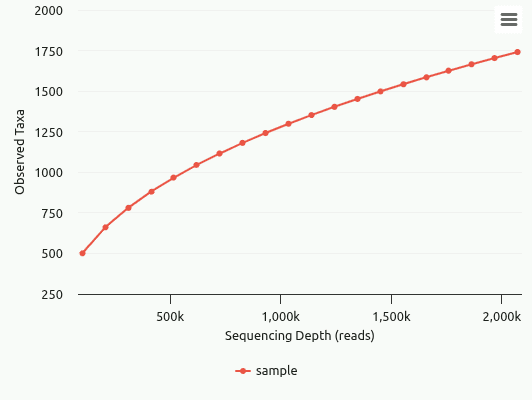
rarefaction
稀疏曲线,在所选排名绘制观测分类单元与子采样读段深度。使用超几何期望进行分析计算。曲线平台期表示测序深度充分;仍在上升的曲线表示欠采样。
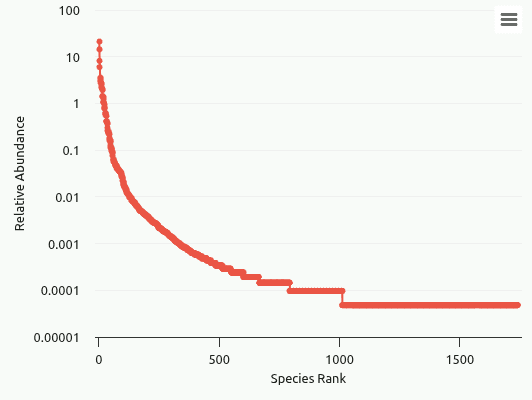
rank-abundance
排名丰度曲线(Whittaker 图),分类单元按相对丰度递减排名,y 轴为对数刻度。曲线沿 x 轴的长度反映丰富度,而斜率表示均匀度——陡峭下降意味着少数分类单元占优。
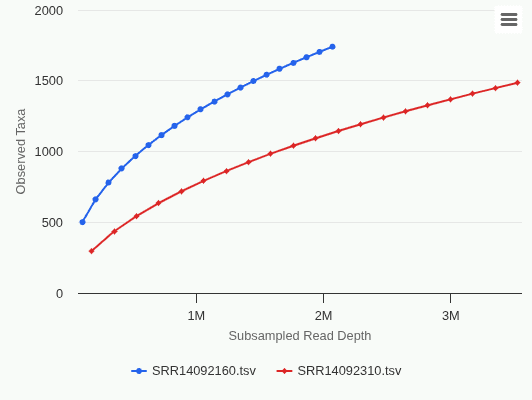
comp-rarefaction
所有上传样本的叠加稀疏曲线。可目视比较样本间的测序工作量和分类学饱和度。
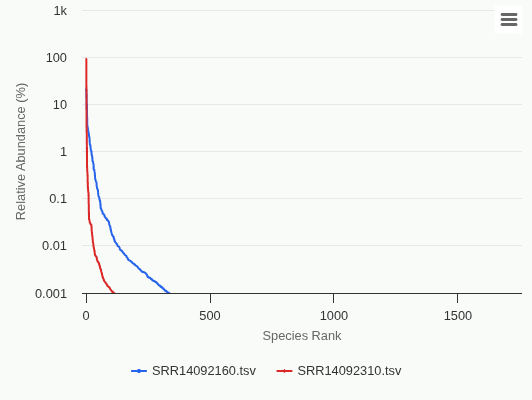
comp-rank-abundance
所有上传样本的叠加排名丰度曲线。陡峭的曲线表示更不均匀的群落,由少数分类单元占优。
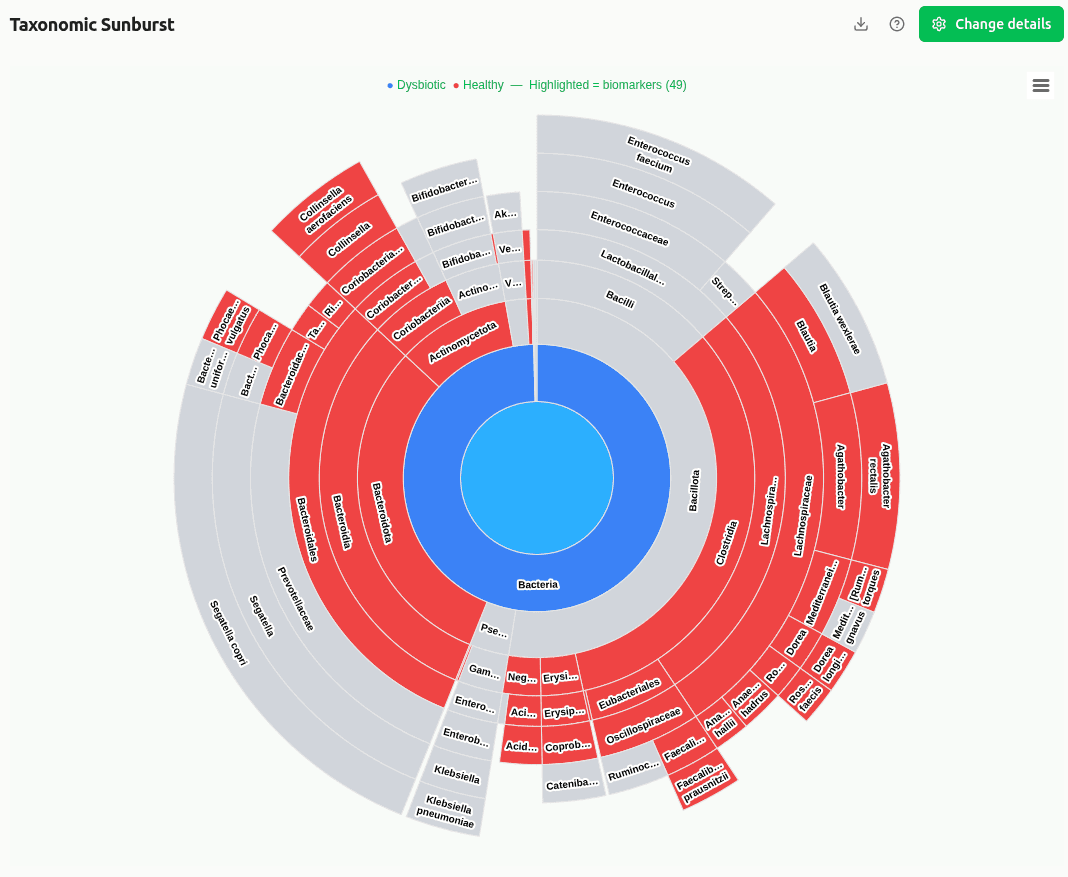
group-taxonomic-sunburst
交互式旭日图,将完整分类学层级显示为同心环。LEfSe 生物标志物节点按其富集组着色;无显著意义节点显示为灰色。点击任何环节可向下钻取。
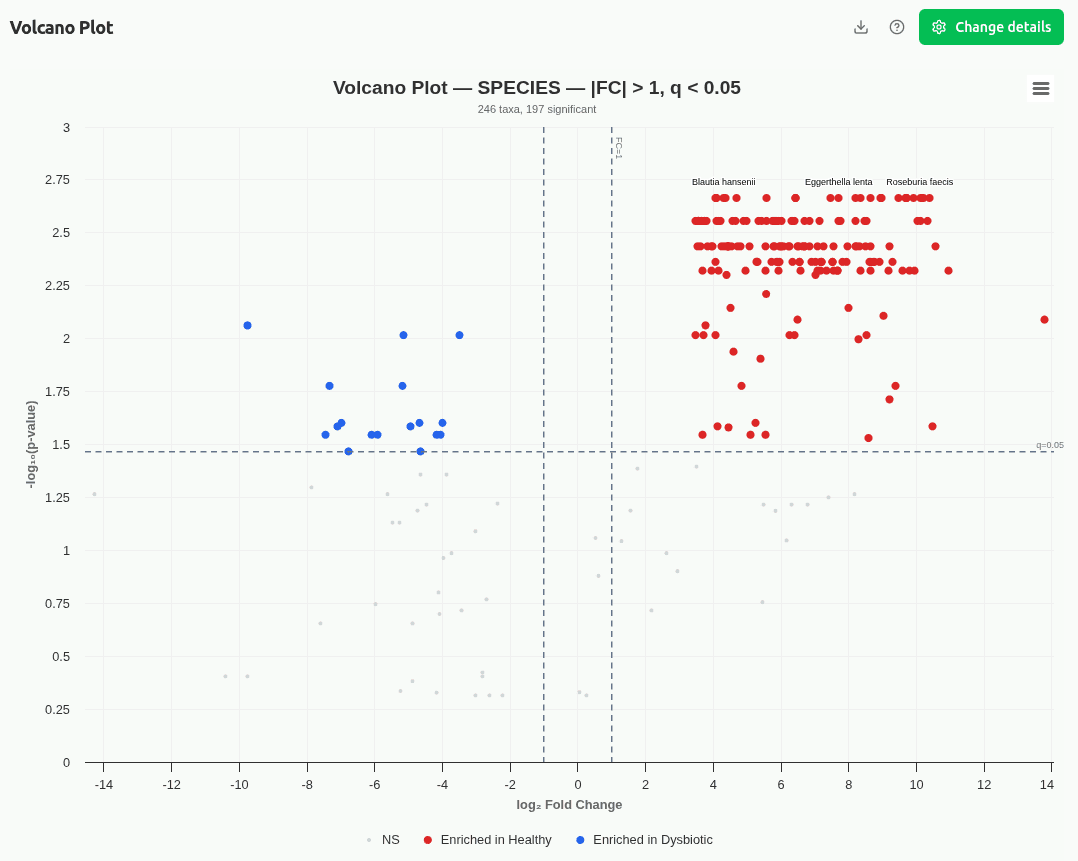
group-volcano
火山图:log₂ 倍变(x)vs −log₁₀ 调整 p 值(y)。水平线上方的点通过显著性检验(BH FDR)。彩色点在相应组中显著富集。