Kraken2
Classificação TaxonômicaKraken2 é um classificador taxonômico ultrarrápido baseado em k-mers que atribui rótulos taxonômicos a leituras curtas de DNA examinando os k-mers dentro de uma leitura e consultando um banco de dados com esses k-mers. [1]
Como Obter o Arquivo de Saída do Modelo
Abaixo está um breve fluxo de trabalho que a equipe executou para obter os exemplos de arquivo de saída que apresentamos na página de ferramentas.
Entrada
Arquivos FASTQ/FASTA (leituras single-end ou paired-end)
Saída
Relatório separado por tabulação com contagens taxonômicas em cada rank, além do arquivo de classificação por leitura
conda install -c bioconda kraken2
Imagem Docker: staphb/kraken2:latest
Amostra 1 microbioma de intestino humano (SRR14092160, 5,5M pares de leituras) classificado com Kraken2 contra o Banco de dados.
- 1
Baixar leituras do NCBI SRA
prefetch SRR14092160 && fasterq-dump SRR14092160 -O /data --split-files && gzip /data/SRR14092160_*.fastq
Microbioma de intestino humano, ponto temporal pré-colonização por VRE (Dia -9). Paired-end Illumina, 5,5M pares de leituras.
- 2
Baixar banco de dados PlusPF-8
wget https://genome-idx.s3.amazonaws.com/kraken/k2_pluspf_08_GB_20251015.tar.gz && mkdir -p kraken2_db && tar xzf k2_pluspf_08_GB_20251015.tar.gz -C kraken2_db/
~5,6 GB de download, 7 GB extraído. Índices pré-construídos disponíveis em https://benlangmead.github.io/aws-indexes/k2.
- 3
Executar classificação Kraken2
kraken2 --db kraken2_db --paired --gzip-compressed --threads 12 --report kraken2_output.tsv --output /dev/null SRR14092160_1.fastq.gz SRR14092160_2.fastq.gz
52,29% classificado. Comunidade diversa dominada por Bacillota.
Materiais Utilizados
Arquivos de Saída de Exemplo
Baixe os arquivos de saída usados nas demonstrações da página de ferramentas. Você pode enviá-los diretamente para IntMeta para explorar as visualizações.
Única & Comparação
Análise de Grupo
Referência de Gráficos
Descrições detalhadas para todas as 31 visualizações geradas por Kraken2 em IntMeta.
distribution
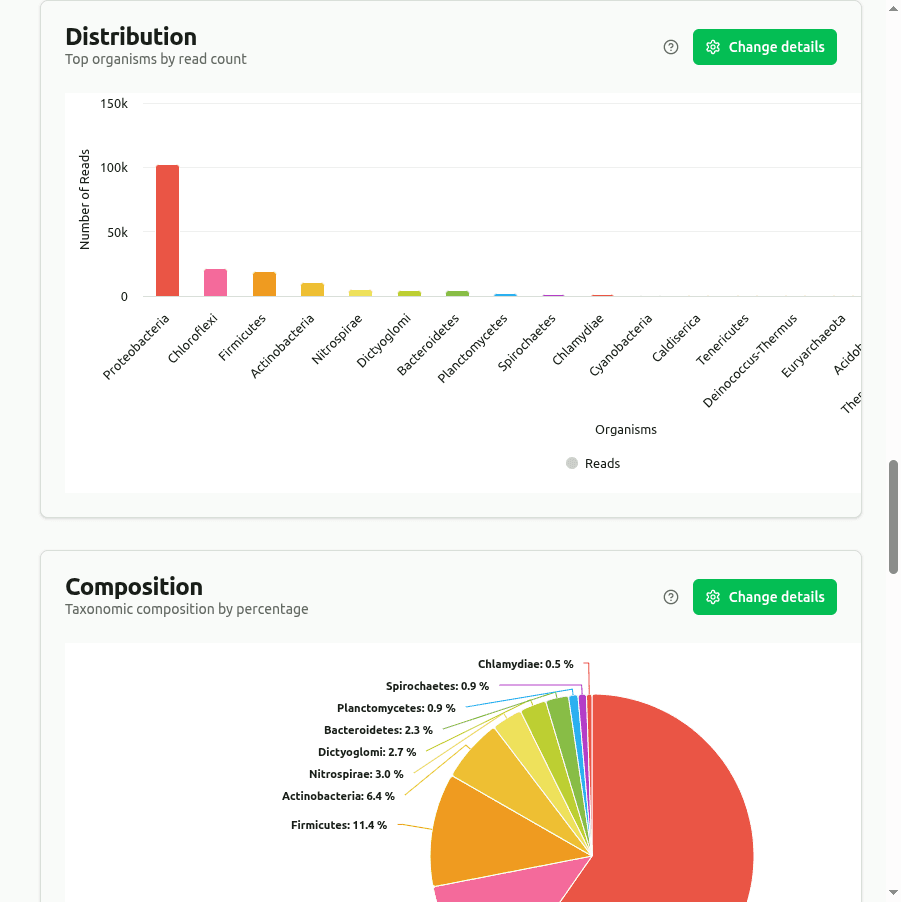
Gráfico de barras classificando os principais organismos por contagem de leituras de clado (leituras atribuídas ao táxon mais todos os seus descendentes) do relatório Kraken2. Fornece uma visão geral rápida dos táxons mais abundantes no rank selecionado.
composition
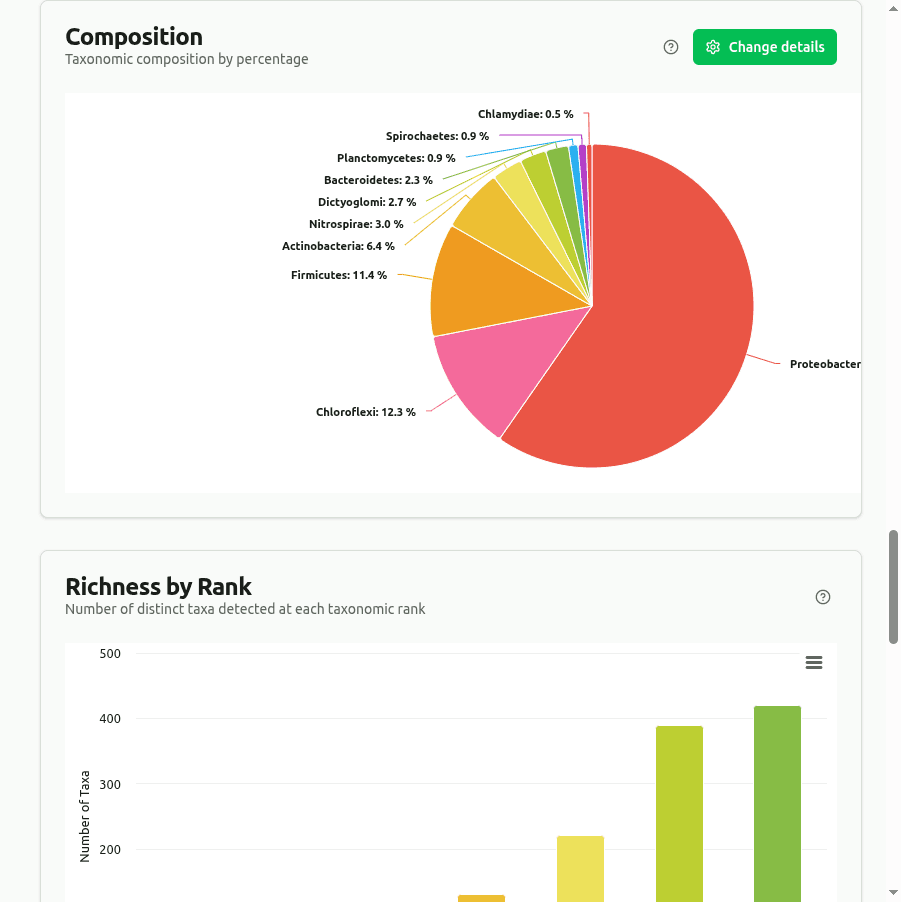
Gráfico de pizza/rosca mostrando os táxons principais como percentual da sua contagem combinada de leituras de clado no rank selecionado. Cada fatia é calculada como (leituras de clado do táxon / soma das leituras de clado exibidas) × 100.
richness
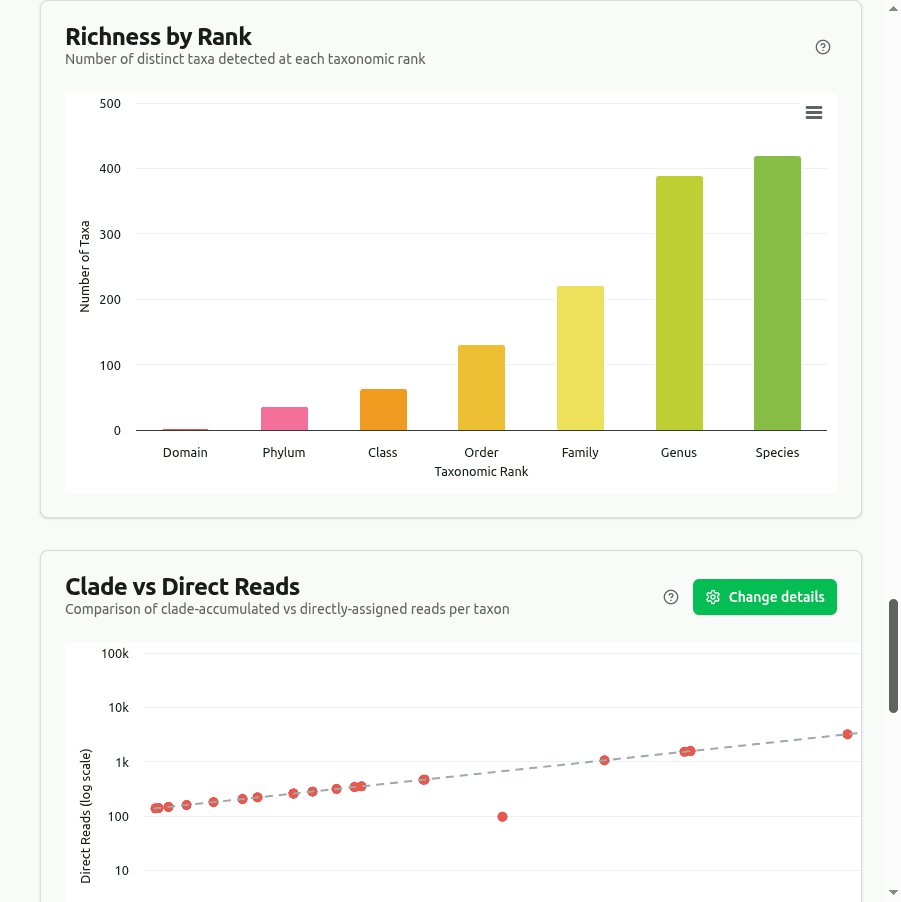
Conta cada organismo único com pelo menos uma leitura de clado em cada rank principal (Domain até Species). A altura da barra é a contagem bruta de táxons distintos — não ponderada por abundância — portanto, um táxon com 1 leitura é contado igual a um com 1 milhão.
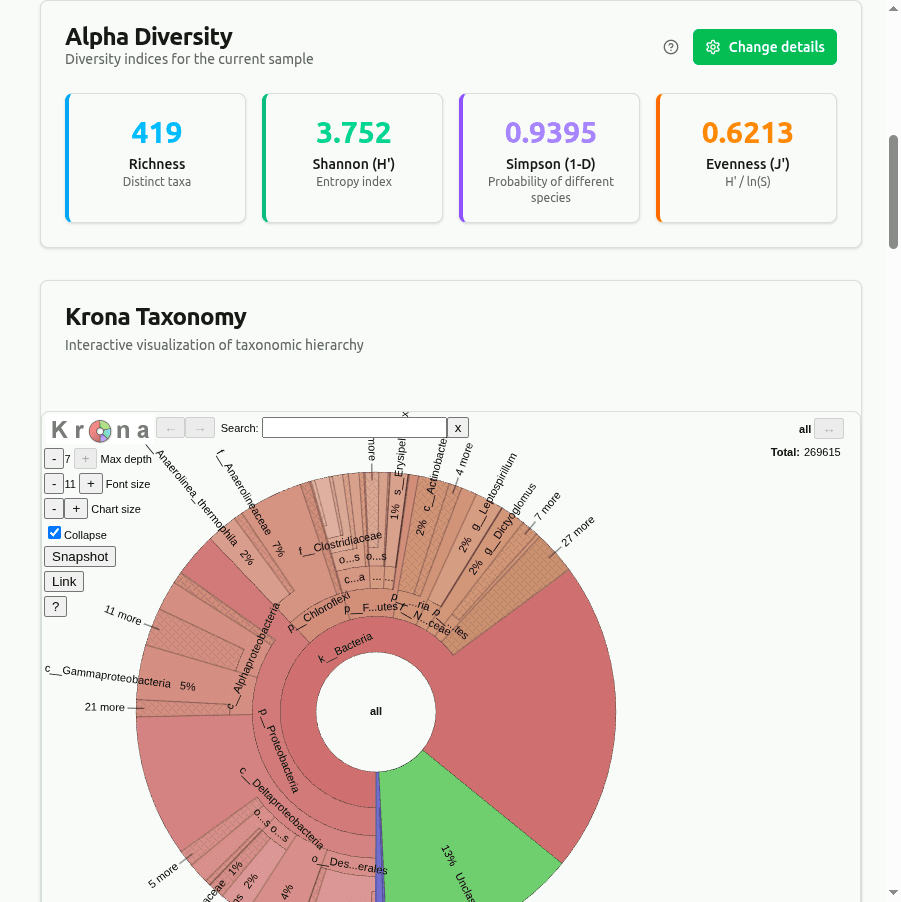
diversity
Índices de diversidade alfa calculados a partir de proporções de leituras de clado por táxon no rank selecionado. Shannon H = −Σ(pᵢ · ln pᵢ), Simpson D = 1 − Σ(nᵢ(nᵢ−1))/(N(N−1)), e uniformidade de Pielou J = H / ln(riqueza). Entropias Shannon mais altas indicam uma comunidade mais uniforme.
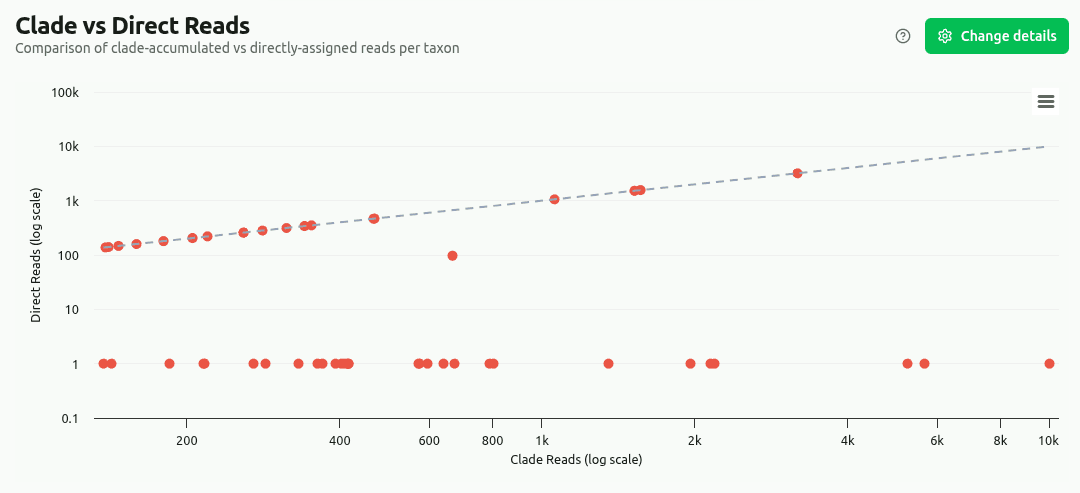
clade-vs-direct
Comparação lado a lado de leituras de clado (táxon + todos os descendentes) versus leituras atribuídas diretamente para os táxons principais. Inclui uma razão de especificidade (direto / clado): valores próximos a 1,0 significam que a maioria das leituras mapeia diretamente para esse táxon, enquanto valores próximos a 0 significam que a abundância é dirigida por sub-táxons.
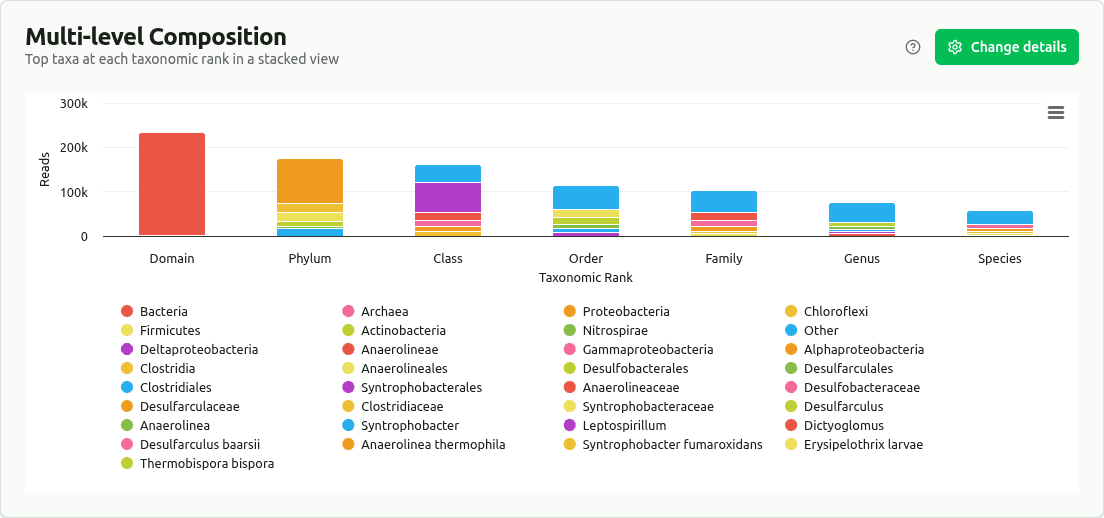
multilevel-composition
Gráfico de barras empilhadas mostrando os táxons principais (por leituras de clado) em cada rank principal, com táxons restantes agrupados como 'Outro'. Revela como a composição da comunidade muda conforme a resolução da classificação aumenta de Domain para Species.
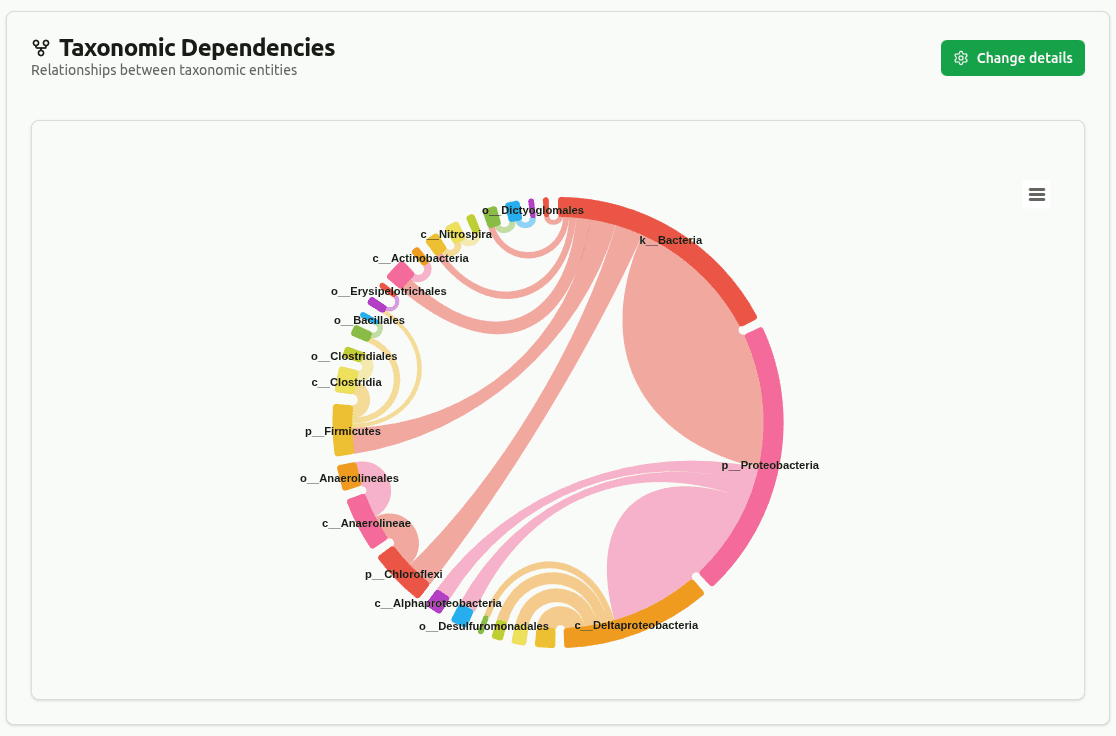
dependency-wheel
Diagrama de cordas conectando táxons pais a táxons filhos através dos ranks (até o rank máximo selecionado). A espessura da conexão é proporcional ao número compartilhado de leituras de clado. Arestas abaixo de um limite mínimo de cobertura (padrão 5% do total de leituras) são filtradas.
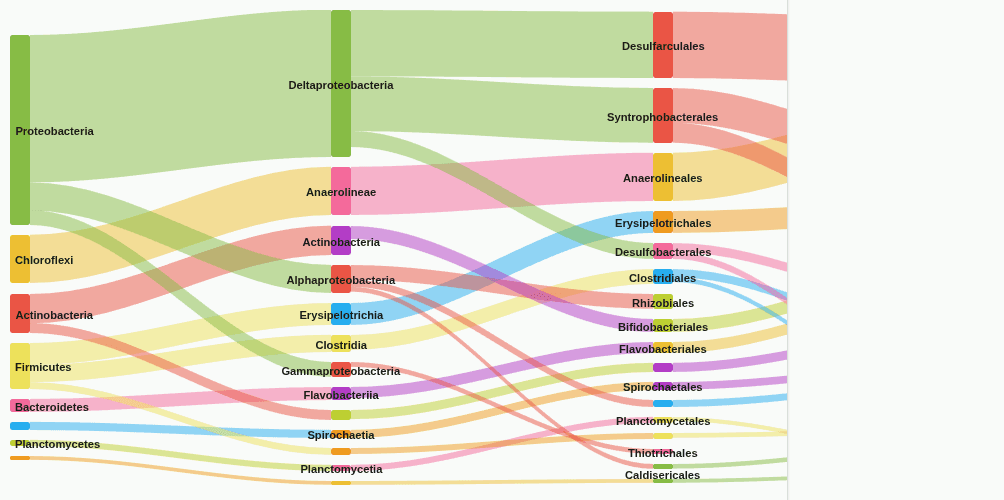
sankey-flow
Diagrama de fluxo Sankey rastreando como as leituras se distribuem do rank inicial (padrão: Domain) ao rank final (padrão: Genus). A largura de cada banda é igual ao número de leituras fluindo de um táxon pai para um táxon filho. Arestas abaixo de um limite mínimo de cobertura (padrão 5%) são removidas para reduzir a desordem.
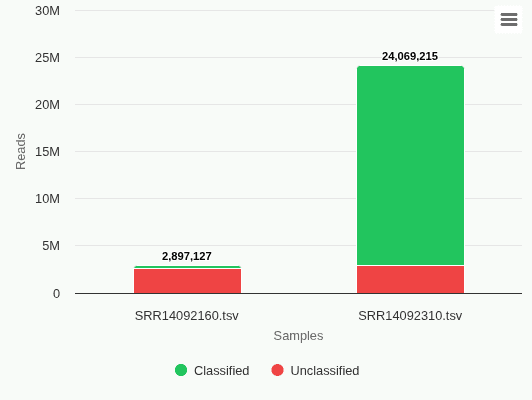
comp-classification
Gráfico de barras empilhadas mostrando leituras totais classificadas versus não classificadas por amostra. Permite comparação rápida das taxas de classificação entre amostras — frações não classificadas grandes podem indicar organismos novos ou limitações do banco de dados.
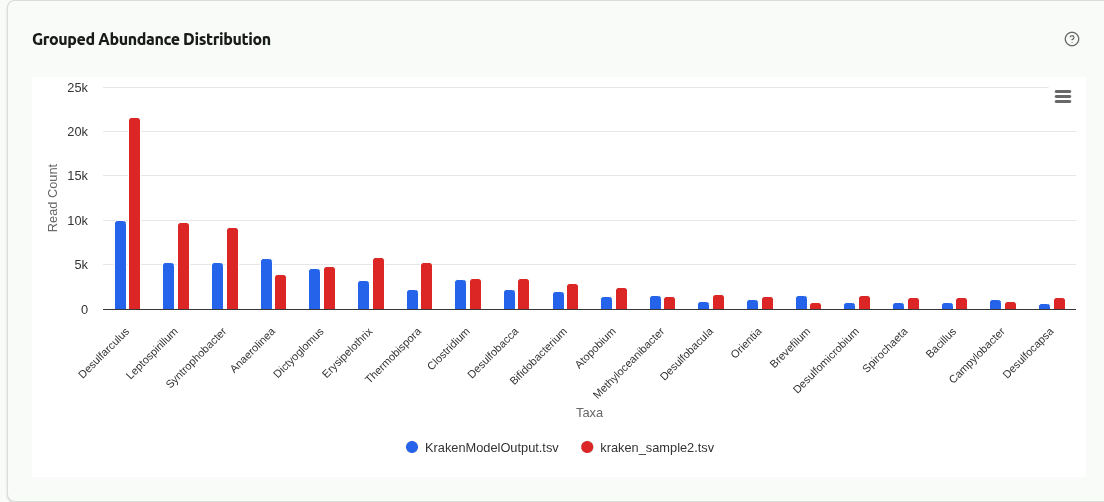
comp-grouped-abundance
Gráfico de barras agrupadas colocando os táxons principais de cada amostra lado a lado no rank selecionado. Cada grupo contém uma barra por amostra, colorida pela identidade da amostra, permitindo comparação visual direta das contagens absolutas de leituras de clado para o mesmo organismo através das amostras.
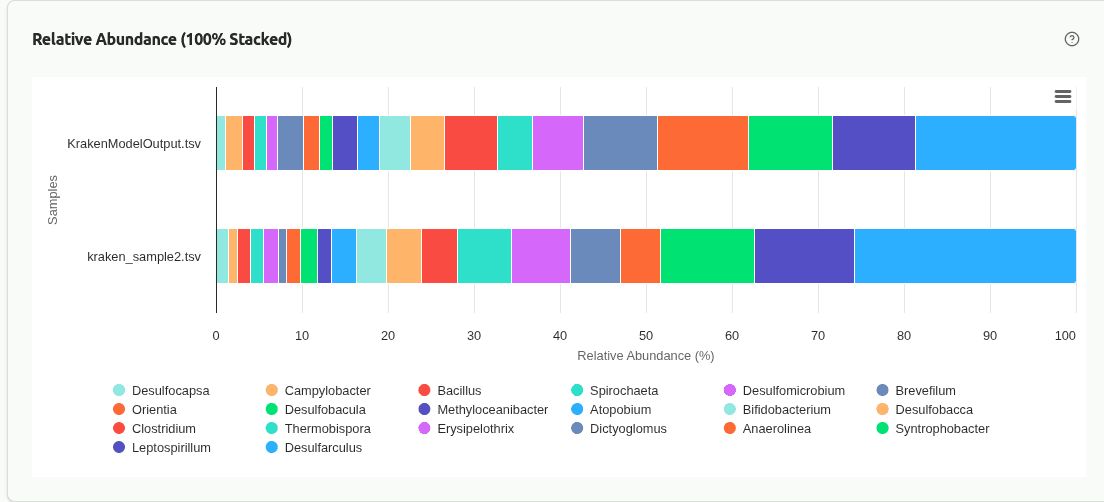
comp-relative-abundance
Gráfico de barras empilhadas 100% onde cada barra representa uma amostra e os segmentos mostram a contribuição proporcional de cada táxon. Útil para comparar composição da comunidade quando as amostras têm profundidades de sequenciamento muito diferentes, pois todas as barras são normalizadas para a mesma altura.
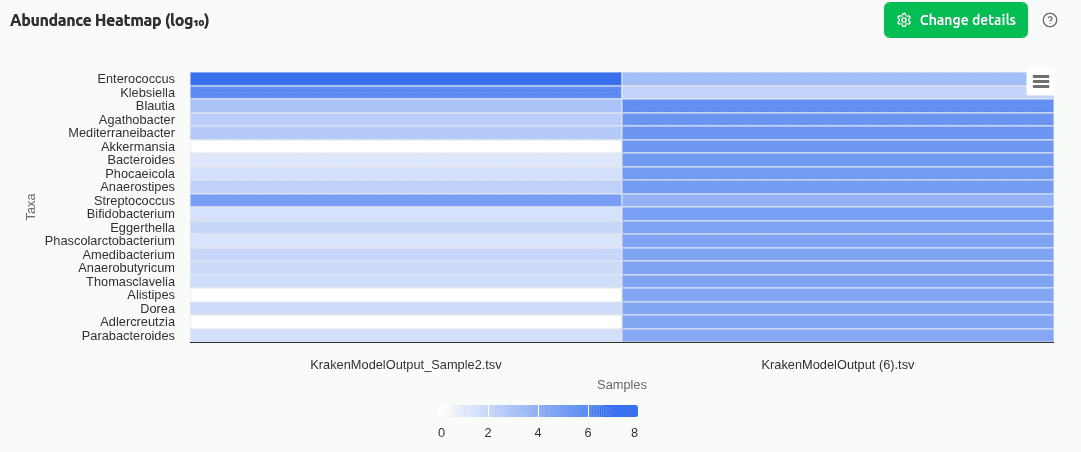
comp-abundance-heatmap
Mapa de calor de matriz de cores com táxons em um eixo e amostras no outro. A intensidade da cor da célula é proporcional à abundância de leituras de clado no rank selecionado. O agrupamento hierárquico em ambos os eixos agrupa amostras similares e táxons co-ocorrentes.
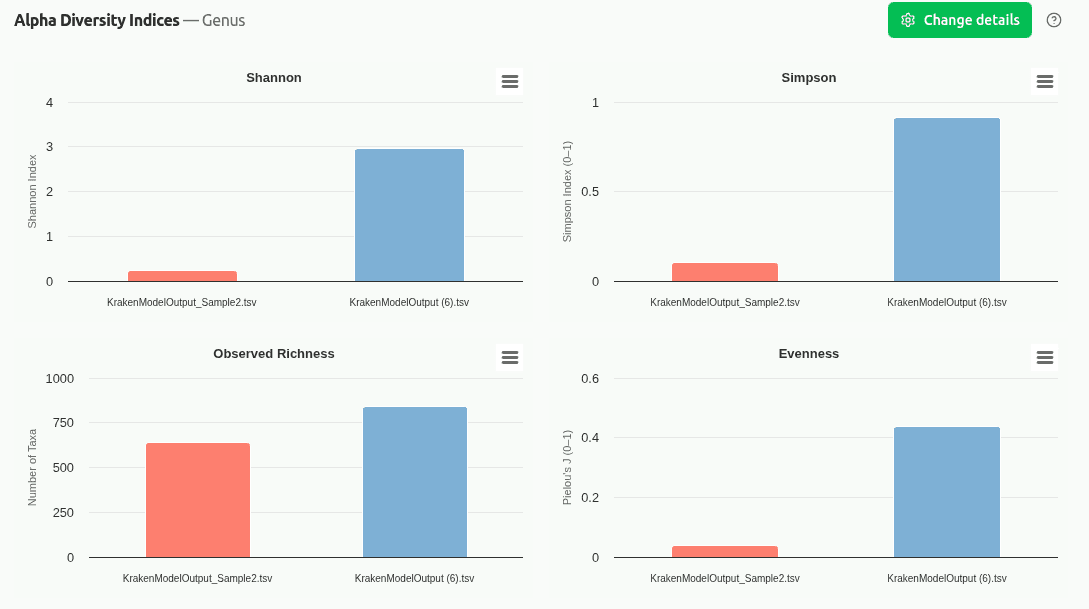
comp-diversity-indices
Gráfico multi-painel exibindo entropiaShannon, diversidade Simpson, Riqueza Observada e Uniformidade de Pielou para cada amostra em sua própria escala de eixo y. Permite comparação rápida entre amostras de diversidade alfa sem distorção de escala.
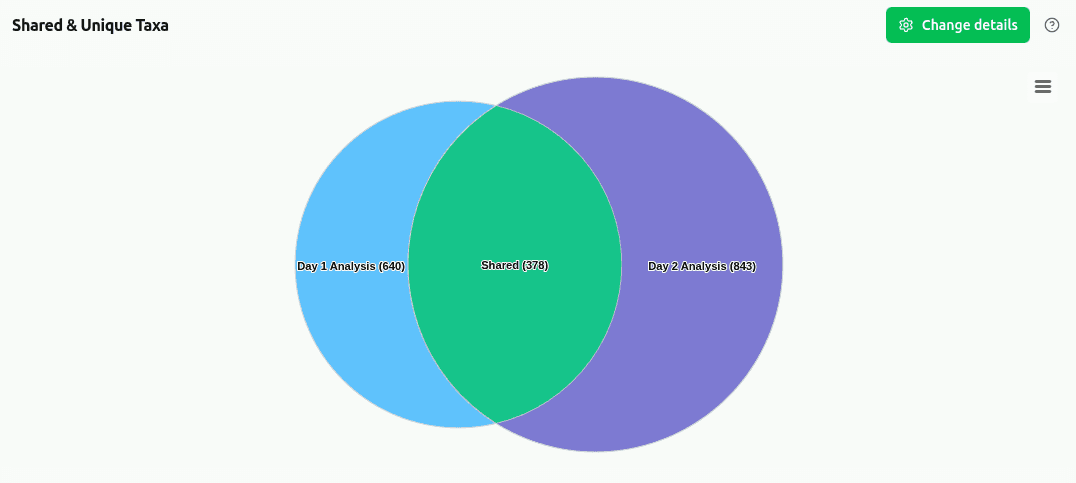
comp-shared-taxa
Diagrama de Venn mostrando a contagem de táxons compartilhados entre amostras versus táxons exclusivos para cada amostra individual. Calculado no rank taxonômico selecionado usando presença/ausência de leituras de clado ≥ 1.
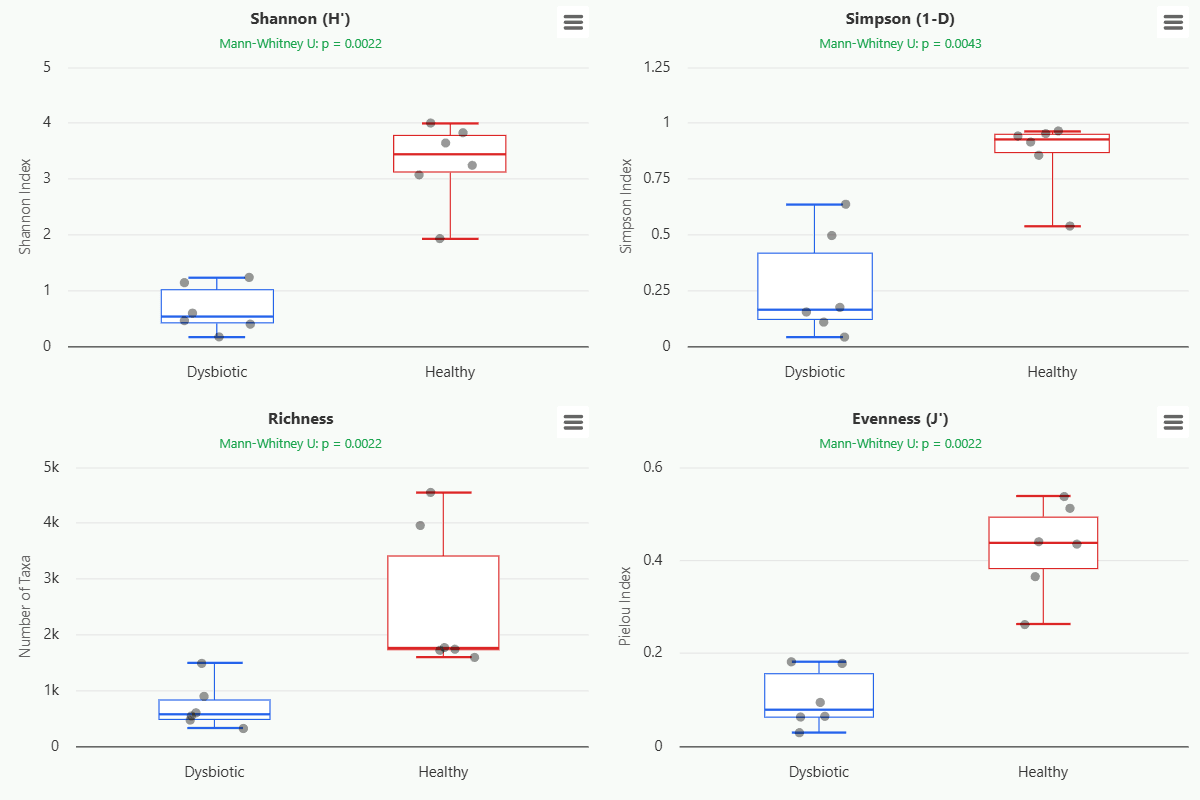
group-alpha-diversity
Boxplots de entropiaShannon, diversidade Simpson, Riqueza Observada e Uniformidade de Pielou por grupo. Cada caixa resume a variação intra-grupo. Valores p de Kruskal-Wallis testam diferenças significativas entre grupos.
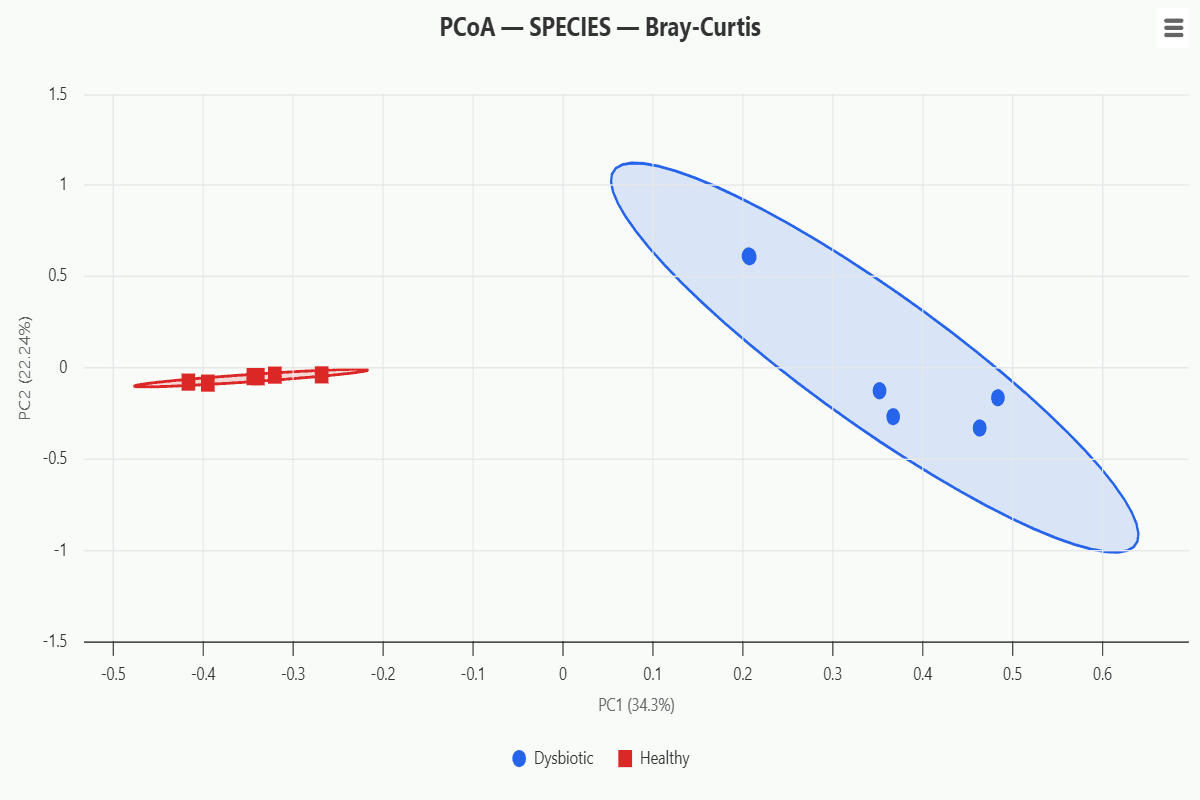
group-pcoa
Análise de Coordenadas Principais (PCoA) na matriz de dissimilaridade Bray-Curtis. Pontos são coloridos por atribuição de grupo com elipses de confiança de 95%. Rótulos de eixo mostram o percentual de variância explicada por cada coordenada.
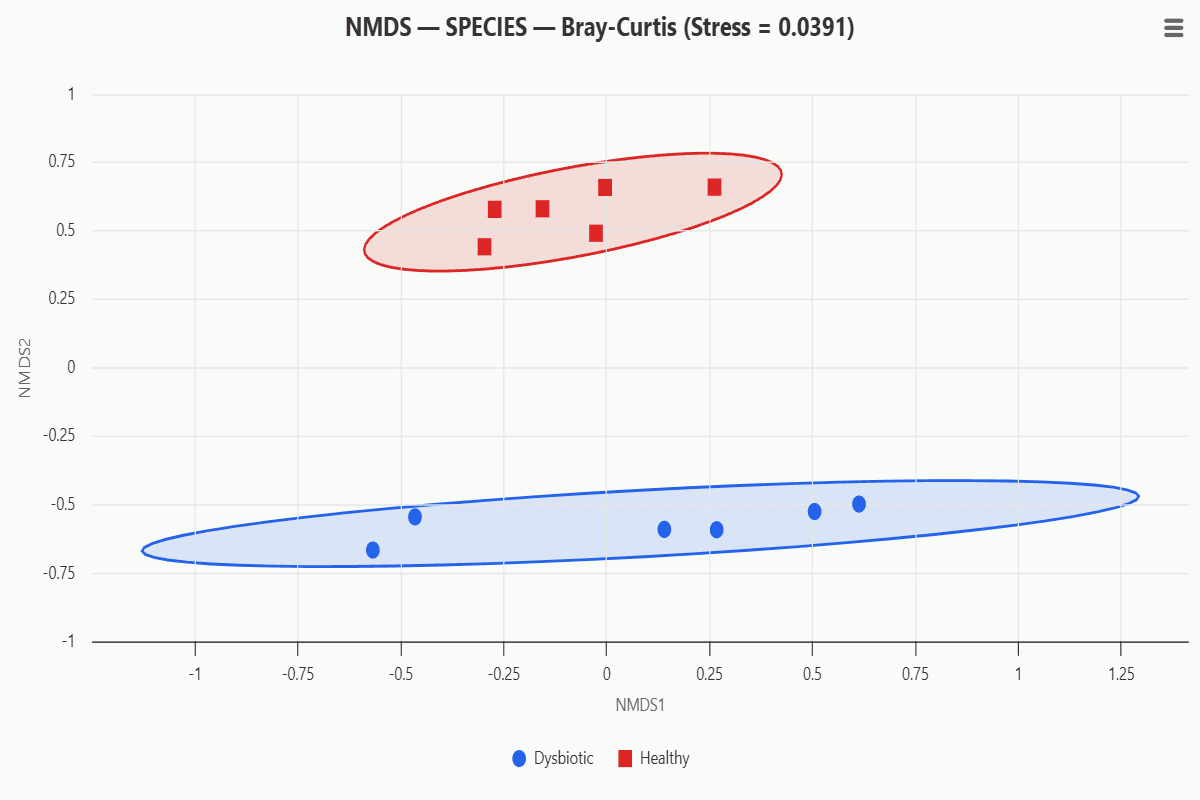
group-nmds
Escala Multidimensional Não-Métrica (NMDS) com valor de stress exibido. Pontos coloridos por grupo com elipses de confiança. Stress menor (<0,2) indica uma boa representação das distâncias originais em 2D.
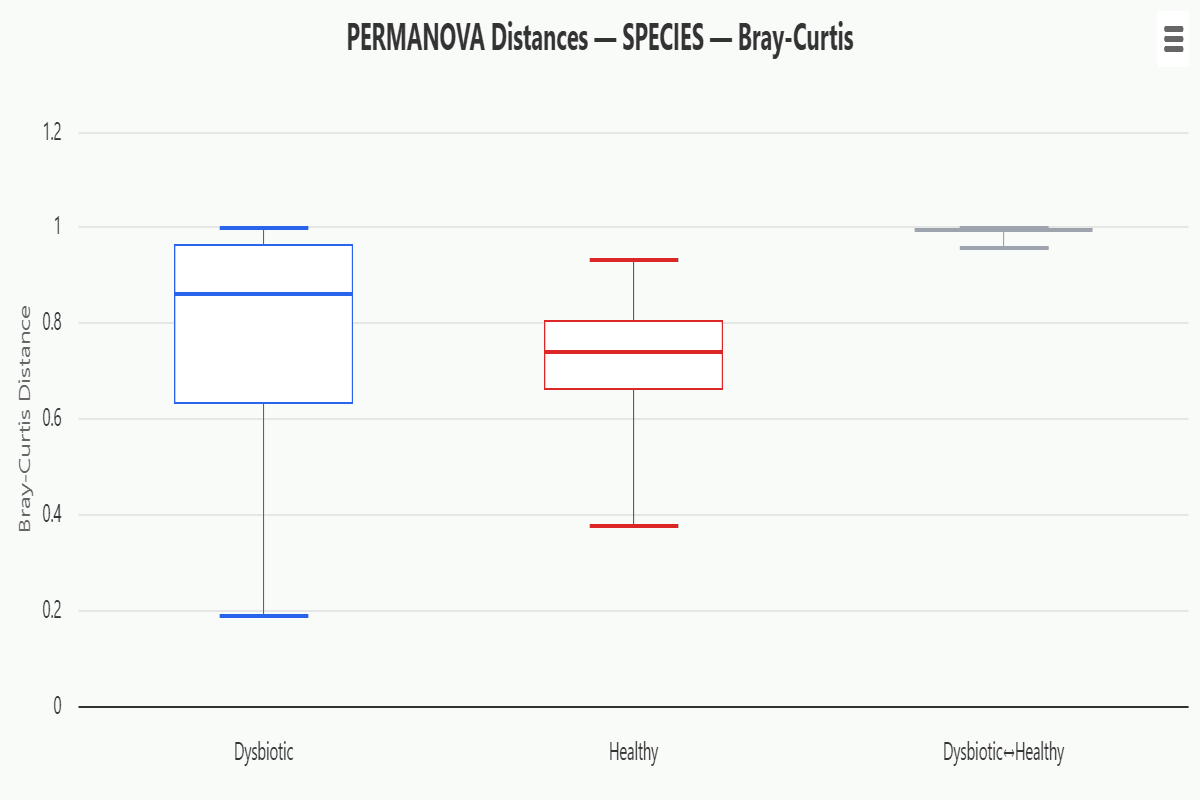
group-distance-boxplots
Boxplots de distâncias Bray-Curtis intra-grupo versus inter-grupo. PERMANOVA R² e p-valor quantificam a fração da variância explicada pelo agrupamento. Estatística R de ANOSIM mede o grau de separação dos grupos.
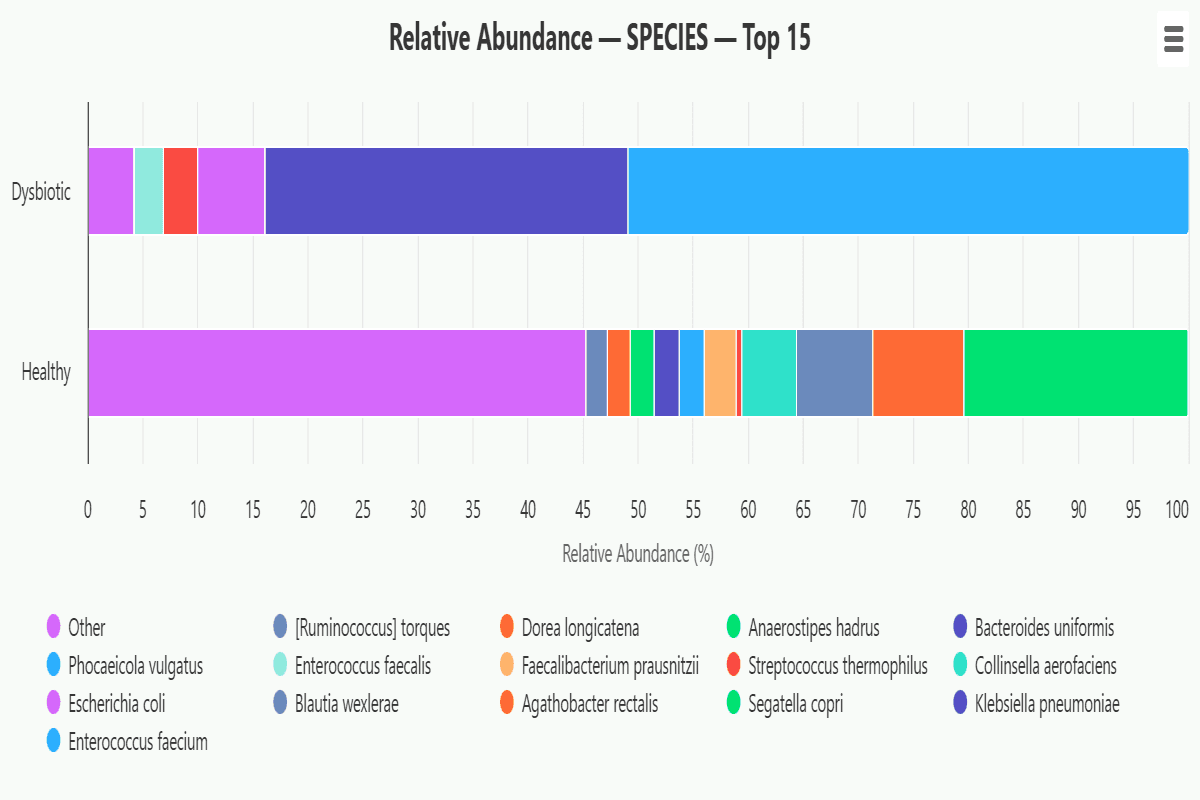
group-relative-abundance
Abundância relativa média do grupo como barras empilhadas 100% no rank taxonômico selecionado. Cada barra mostra a composição proporcional média em todas as amostras do grupo, permitindo comparação direta em nível de grupo.
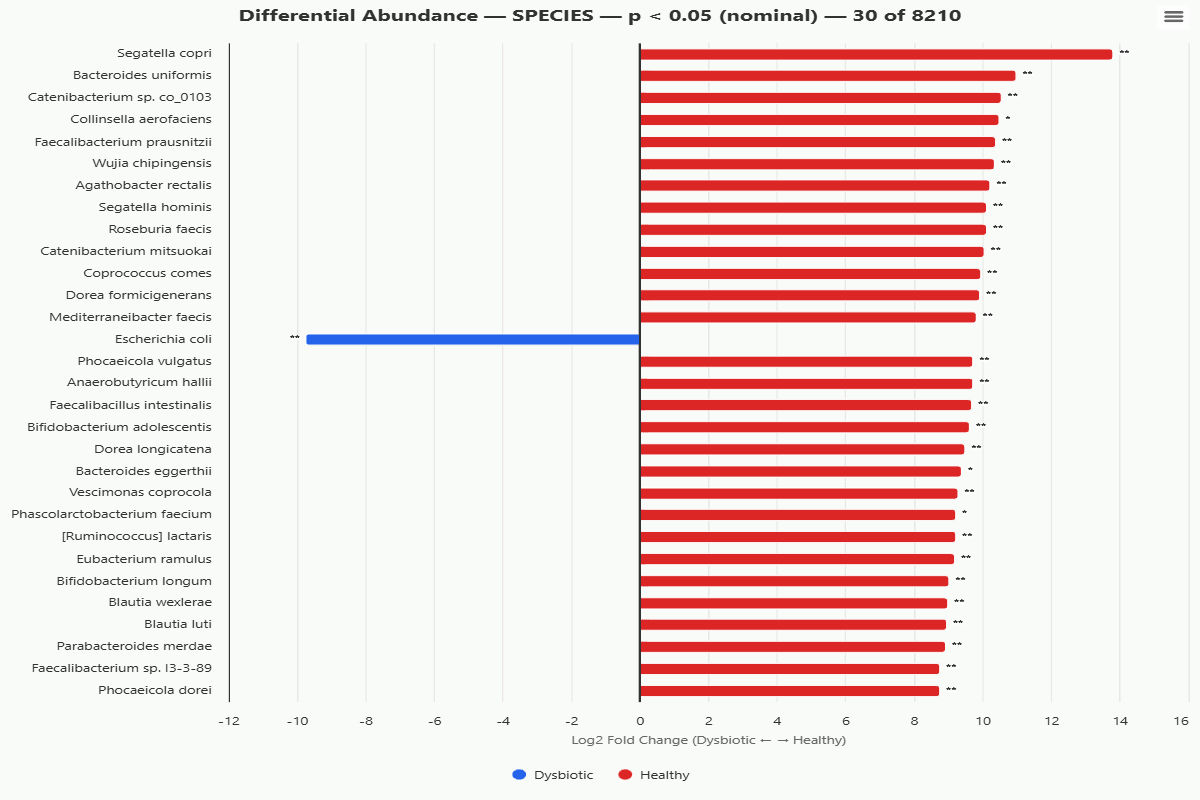
group-differential-abundance
Gráfico de barras de táxons com diferenças significativas de abundância entre grupos (teste de Kruskal-Wallis, correção BH FDR). Cor indica qual grupo tem maior abundância. Apenas táxons que passam o limite de significância são mostrados.
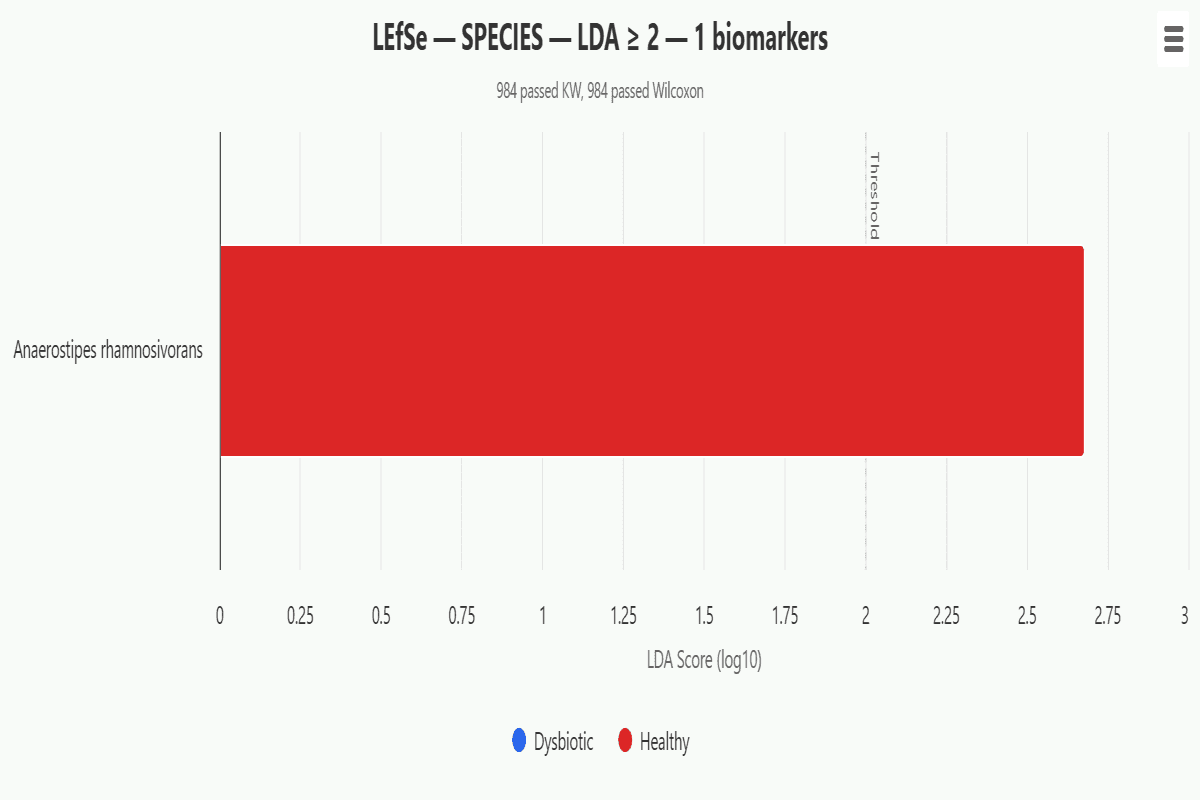
group-lefse
LEfSe (Análise de Discriminante Linear Tamanho de Efeito) gráfico de biomarcador. Barras horizontais mostram escores LDA para táxons que discriminam significativamente entre grupos. Escores LDA mais altos indicam associação mais forte com o respectivo grupo.
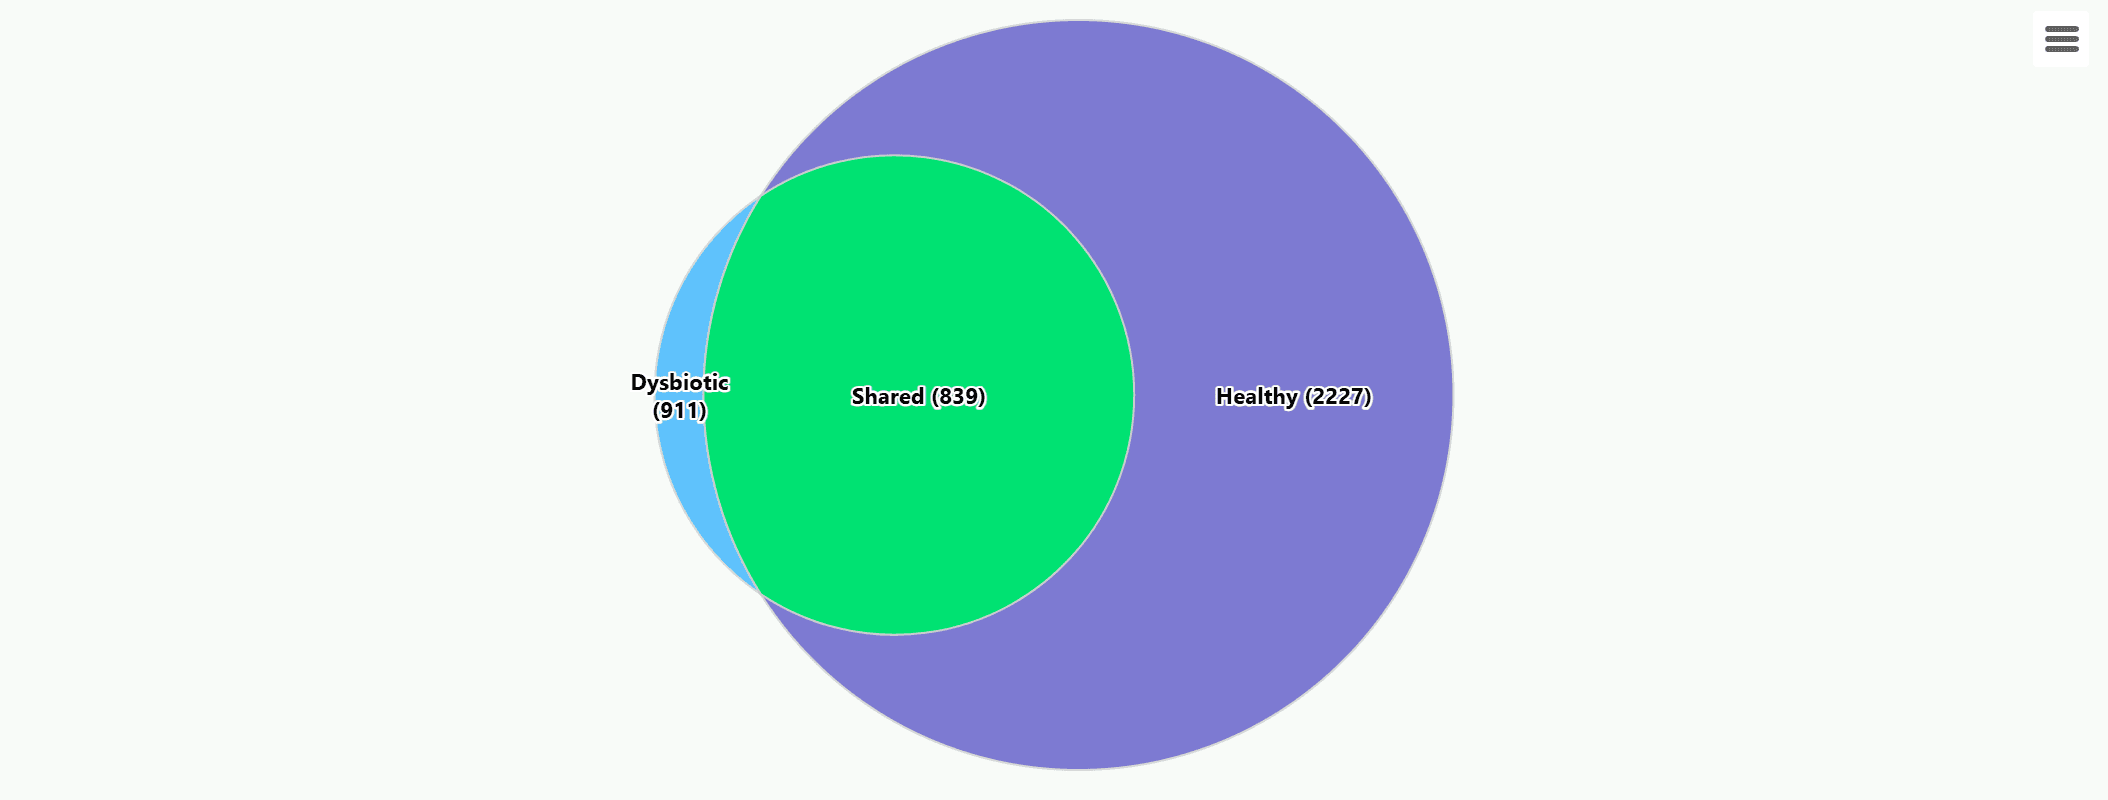
group-shared-taxa
Diagrama de Venn mostrando táxons compartilhados e únicos através de grupos experimentais. O conjunto de táxons de cada grupo é a união de todos os táxons detectados em qualquer amostra pertencente a esse grupo. Clique nas regiões para visualizar a lista específica de táxons com contagens de leituras.
group-classification
Gráfico de colunas empilhadas mostrando leituras médias classificadas versus não classificadas por grupo experimental. Barras de erro representam desvio padrão entre amostras dentro de cada grupo. O tooltip mostra porcentagem e contagem de amostras por grupo.
group-distribution
Gráfico de colunas agrupadas mostrando contagens médias de leituras para os N principais táxons no nível taxonômico selecionado, agrupados por grupo experimental. Barras de erro mostram desvio padrão. Permite comparação de padrões de abundância taxonômica entre grupos.
group-heatmap
Mapa de calor de contagens médias de leituras transformadas em log₁₀ por grupo experimental (colunas) e táxons (linhas). A intensidade da cor reflete abundância, permitindo comparação visual rápida de perfis taxonômicos entre grupos.
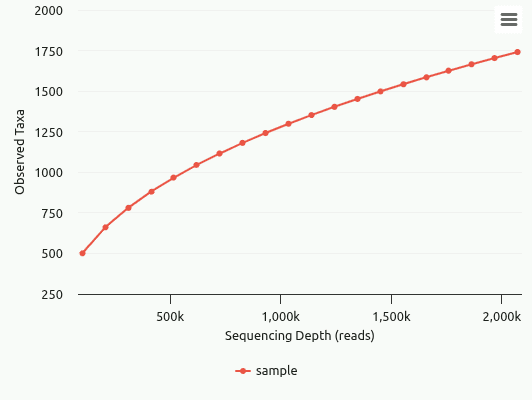
rarefaction
Curva de rarefação plotando táxons observados versus profundidade de leitura subamostrada no rank selecionado. Calculada analiticamente usando expectativa hipergeométrica. Uma curva que se estabiliza indica profundidade de sequenciamento suficiente; uma curva ainda em ascensão sugere subamostragem.
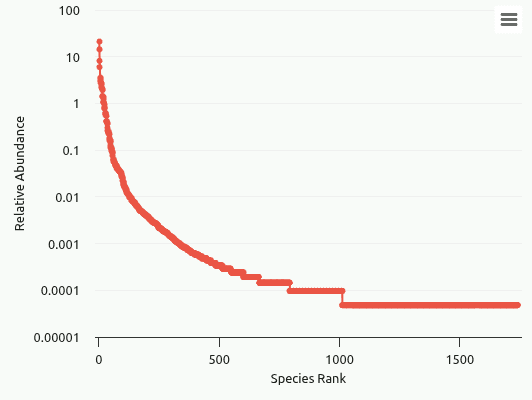
rank-abundance
Curva de classificação-abundância (Gráfico de Whittaker) com táxons classificados por abundância relativa decrescente em eixo y logarítmico. O comprimento da curva ao longo do eixo x reflete riqueza, enquanto a inclinação indica uniformidade — uma queda abrupta significa que alguns poucos táxons dominam.
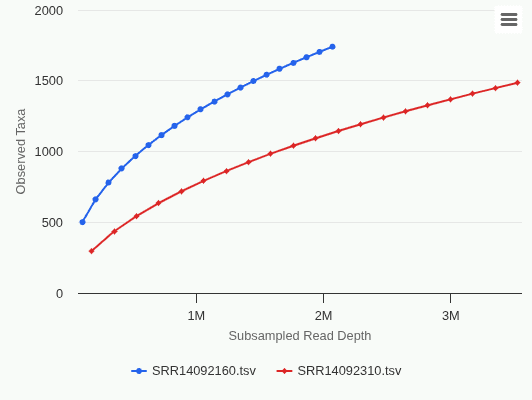
comp-rarefaction
Curvas de rarefação sobrepostas para todas as amostras carregadas. Permite comparação visual do esforço de sequenciamento e saturação taxonômica entre amostras.
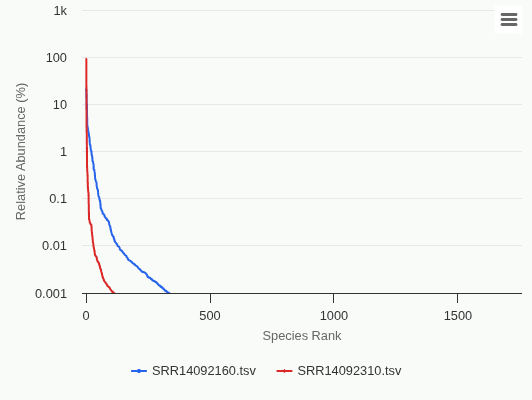
comp-rank-abundance
Curvas de classificação-abundância sobrepostas para todas as amostras carregadas. Curvas mais íngremes indicam comunidades mais desiguais dominadas por menos táxons.
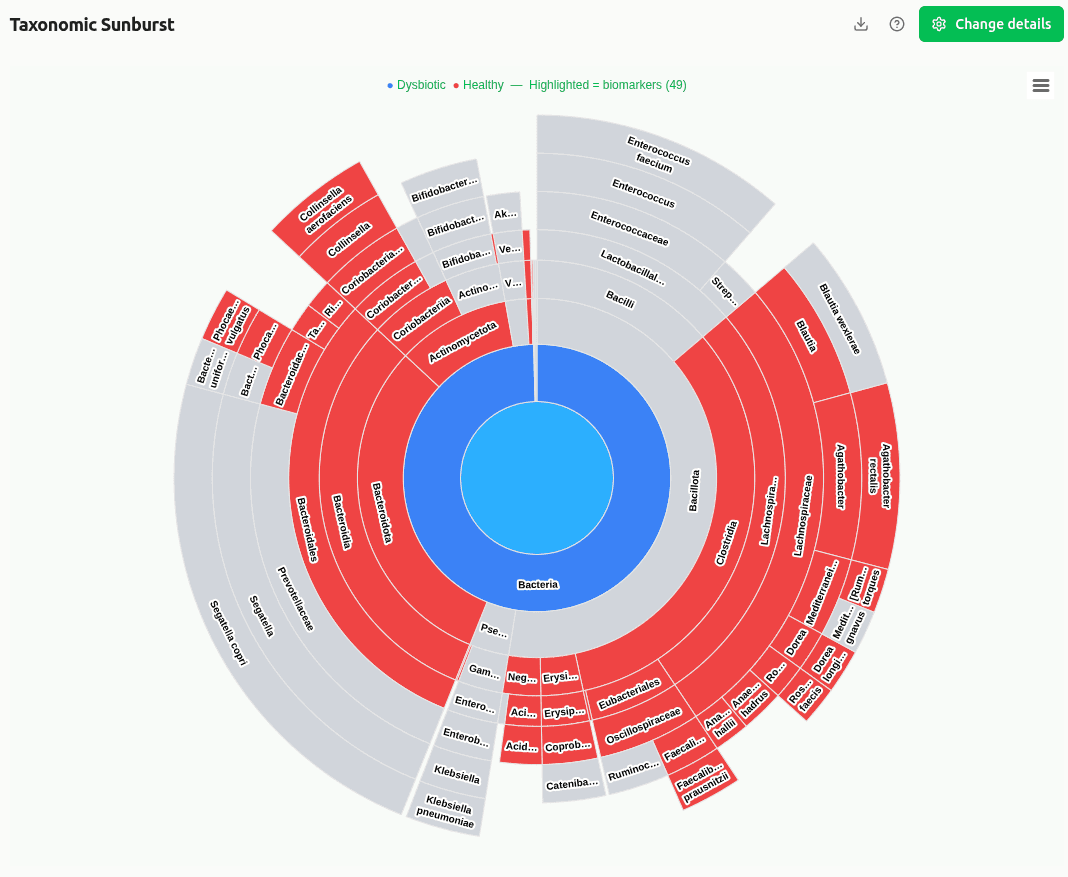
group-taxonomic-sunburst
Sunburst interativo exibindo a hierarquia taxonômica completa como anéis concêntricos. Nós de biomarcador LEfSe são coloridos pelo seu grupo enriquecido; nós não significativos são cinzentos. Clique em qualquer segmento de anel para fazer zoom.
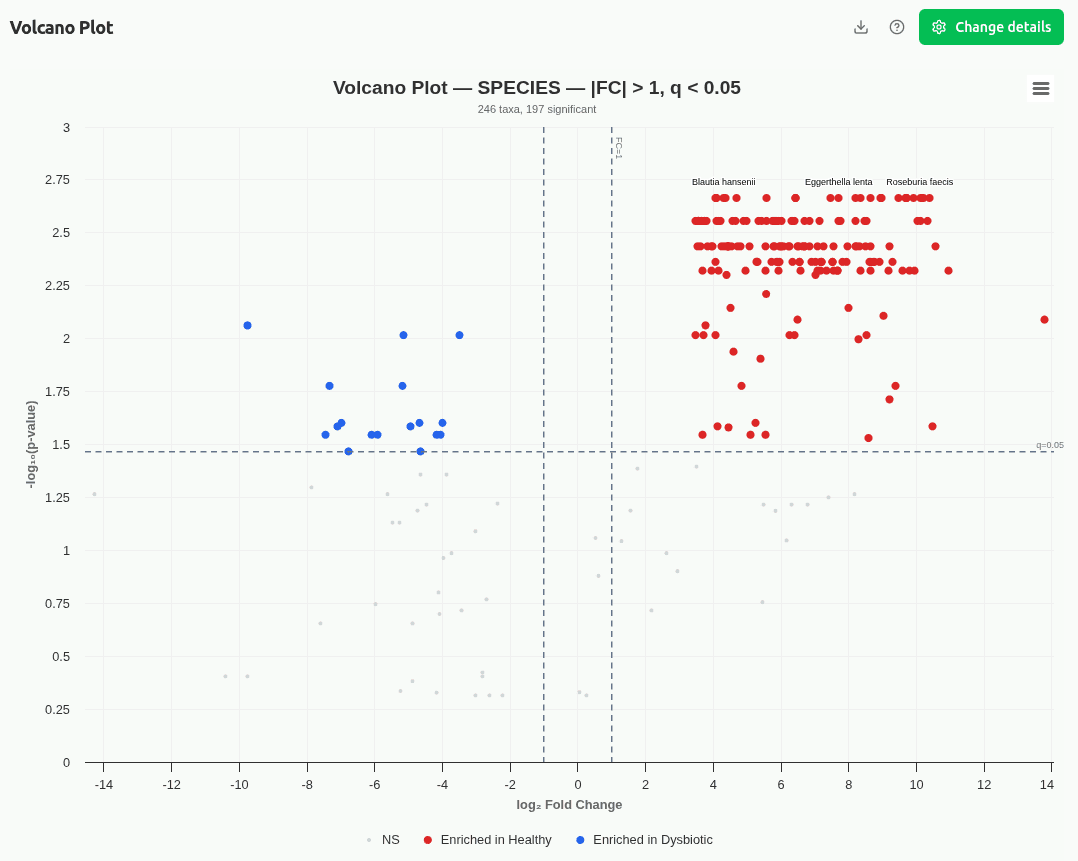
group-volcano
Gráfico vulcão: log₂ alteração de dobro (x) versus −log₁₀ p-valor ajustado (y). Pontos acima da linha horizontal passam significância (BH FDR). Pontos coloridos estão significativamente enriquecidos no respectivo grupo.