Kraken2
Clasificación TaxonómicaKraken2 es un clasificador taxonómico ultrarrápido basado en k-mers que asigna etiquetas taxonómicas a lecturas cortas de ADN examinando los k-mers dentro de una lectura y consultando una base de datos con esos k-mers. [1]
Cómo Obtener el Archivo de Modelo de Salida
A continuación se muestra un breve flujo de trabajo que ejecutó el equipo para obtener los ejemplos de modelo de salida que presentamos en la página de herramientas.
Entrada
Archivos FASTQ/FASTA (lecturas de un solo extremo o pareadas)
Salida
Informe separado por tabulaciones con conteos taxonómicos en cada rango, más archivo de clasificación por lectura
conda install -c bioconda kraken2
Imagen Docker: staphb/kraken2:latest
Muestra 1 metagenoma de intestino humano (SRR14092160, 5.5M pares de lecturas) clasificado con Kraken2 contra la Base de datos.
- 1
Descargar lecturas de NCBI SRA
prefetch SRR14092160 && fasterq-dump SRR14092160 -O /data --split-files && gzip /data/SRR14092160_*.fastq
Metagenoma de intestino humano, punto de tiempo pre-colonización de VRE (Día -9). Illumina pareado, 5.5M pares de lecturas.
- 2
Descargar base de datos PlusPF-8
wget https://genome-idx.s3.amazonaws.com/kraken/k2_pluspf_08_GB_20251015.tar.gz && mkdir -p kraken2_db && tar xzf k2_pluspf_08_GB_20251015.tar.gz -C kraken2_db/
~5.6 GB de descarga, 7 GB extraído. Índices precompilados disponibles en https://benlangmead.github.io/aws-indexes/k2.
- 3
Ejecutar clasificación de Kraken2
kraken2 --db kraken2_db --paired --gzip-compressed --threads 12 --report kraken2_output.tsv --output /dev/null SRR14092160_1.fastq.gz SRR14092160_2.fastq.gz
52.29% clasificado. Comunidad diversa dominada por Bacillota.
Materiales Utilizados
Archivos de Salida de Ejemplo
Descarga los archivos de salida utilizados en las demostraciones de la página de herramientas. Puedes cargarlos directamente a IntMeta para explorar las visualizaciones.
Único y Comparación
Análisis de Grupo
Referencia de Gráficos
Descripciones detalladas de todas las 31 visualizaciones generadas por Kraken2 en IntMeta.
distribution
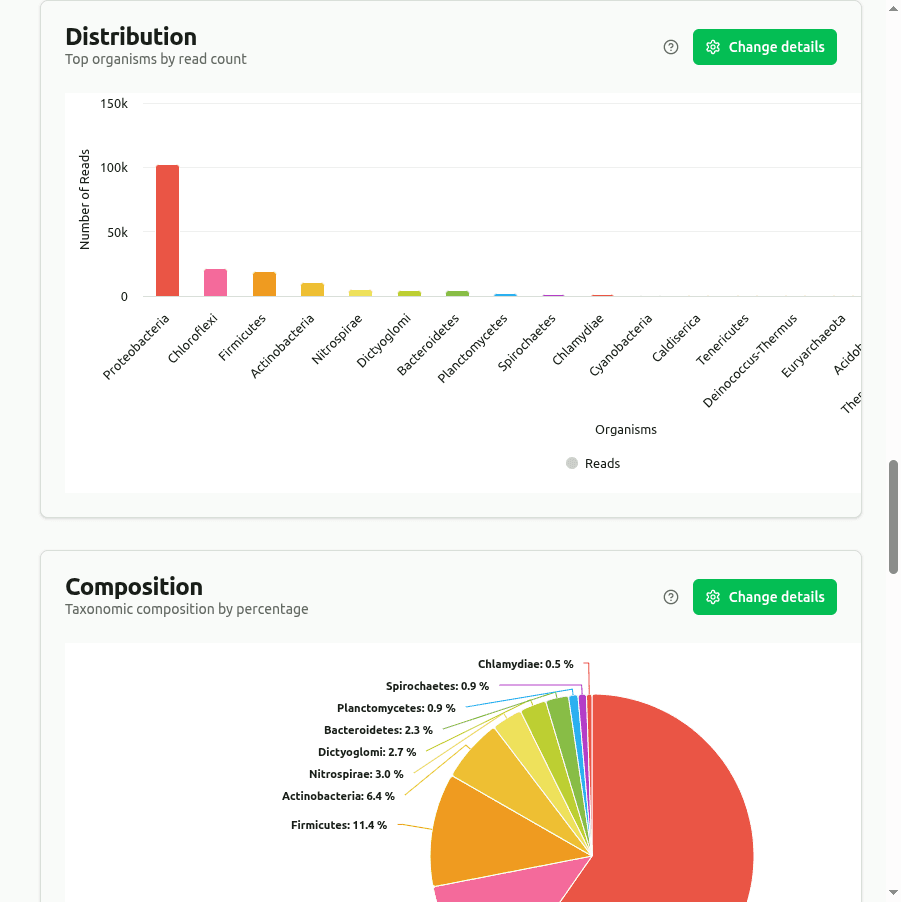
Gráfico de barras clasificando los organismos principales por conteo de lecturas de clado (lecturas asignadas al taxón más todos sus descendientes) del informe de Kraken2. Proporciona una descripción general rápida de los taxones más abundantes en el rango seleccionado.
composition
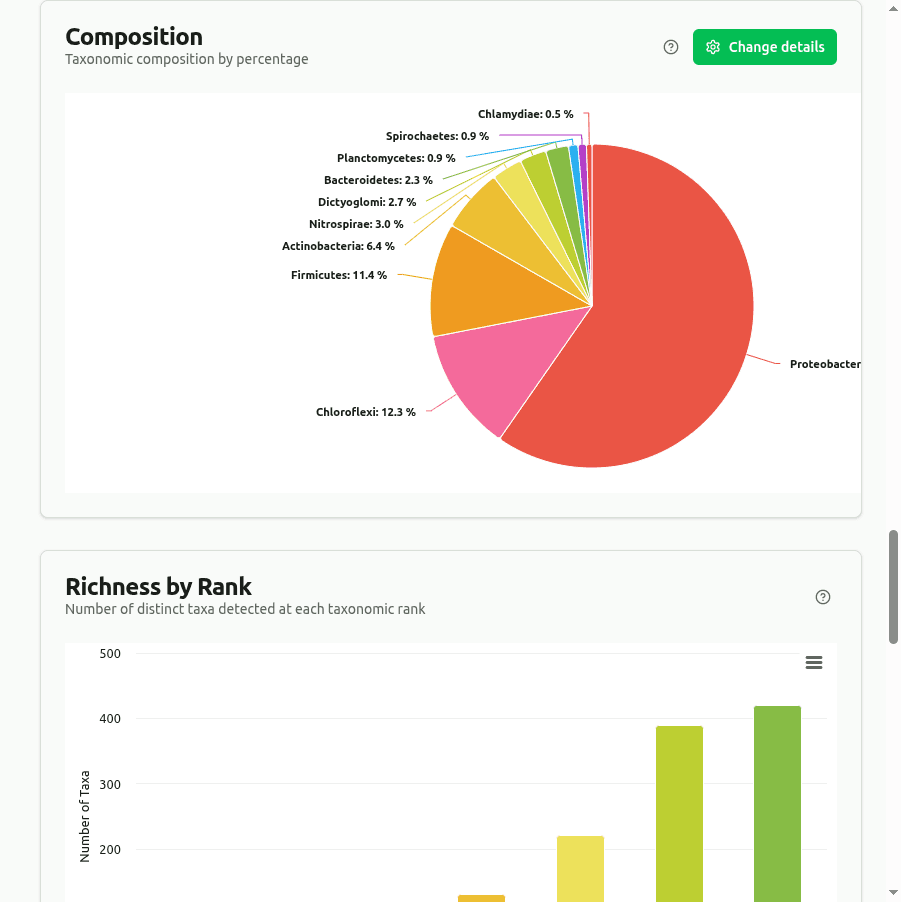
Gráfico circular/de anillo mostrando los principales taxones como porcentaje de su conteo de lecturas de clado combinado en el rango seleccionado. Cada segmento se calcula como (lecturas de clado del taxón / suma de lecturas de clado mostradas) × 100.
richness
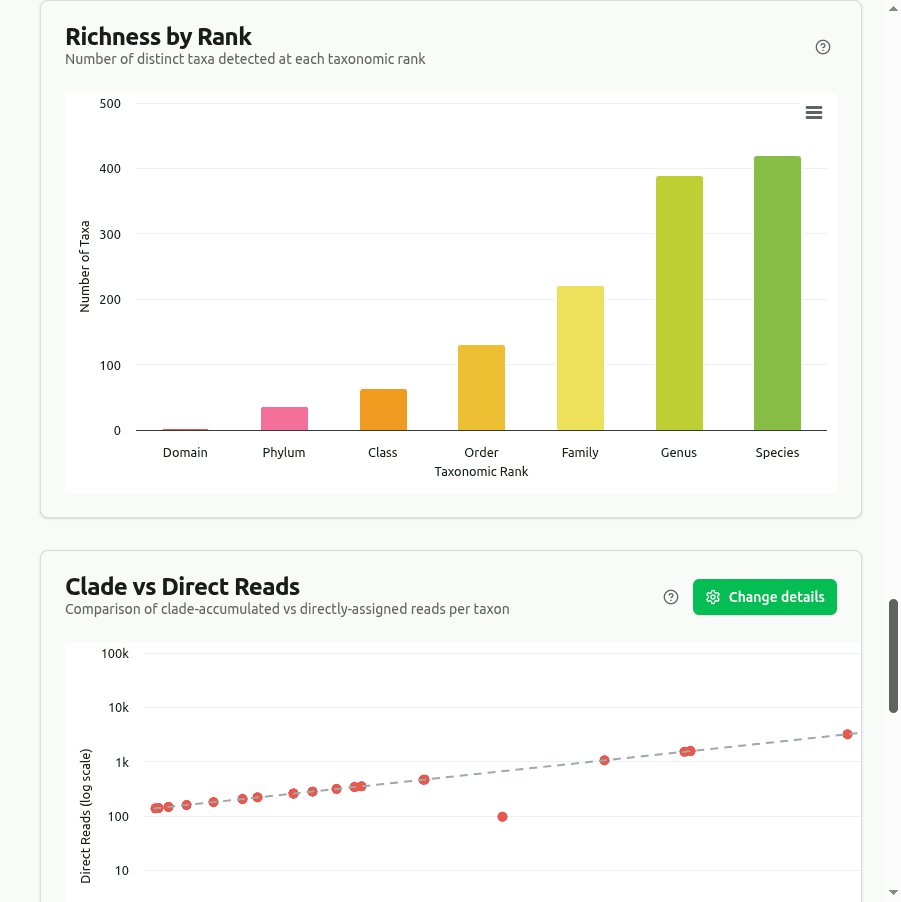
Cuenta cada organismo único con al menos una lectura de clado en cada rango principal (Dominio a Especie). La altura de la barra es el conteo bruto de taxones distintos, no ponderado por abundancia, por lo que un taxón con 1 lectura se cuenta igual que uno con 1 millón.
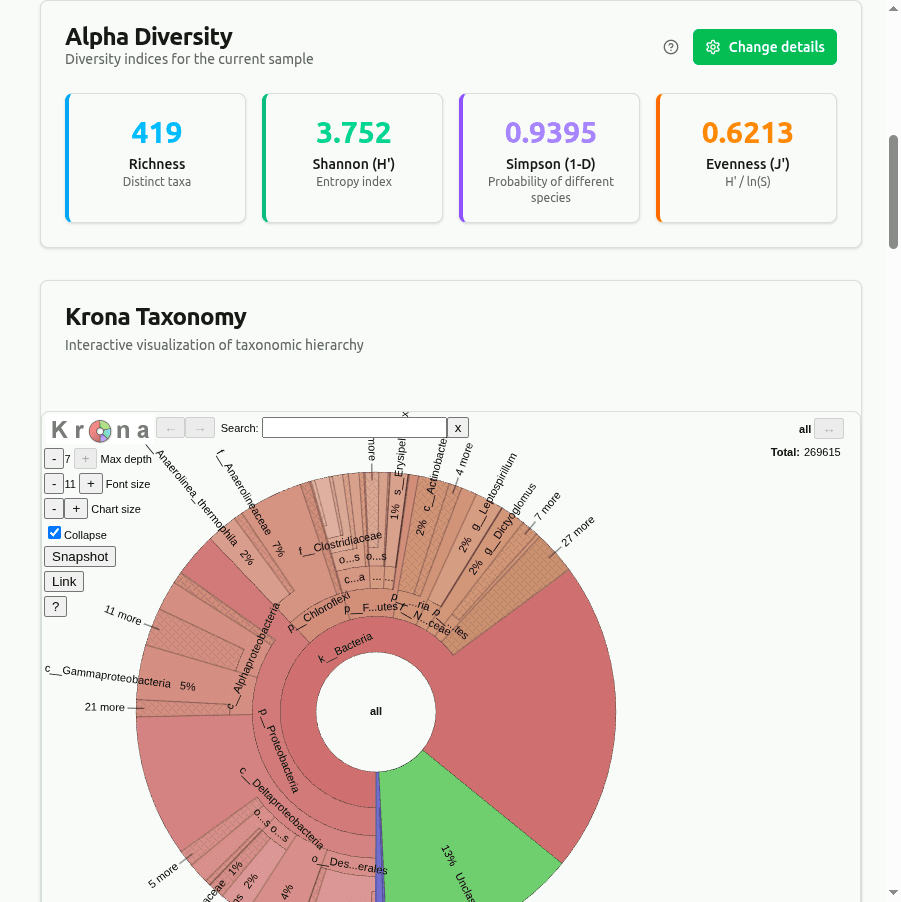
diversity
Índices de diversidad alfa calculados a partir de proporciones de lecturas de clado por taxón en el rango seleccionado. Shannon H = −Σ(pᵢ · ln pᵢ), Simpson D = 1 − Σ(nᵢ(nᵢ−1))/(N(N−1)), y equitatividad de Pielou J = H / ln(riqueza). Una entropía de Shannon más alta indica una comunidad más equilibrada.
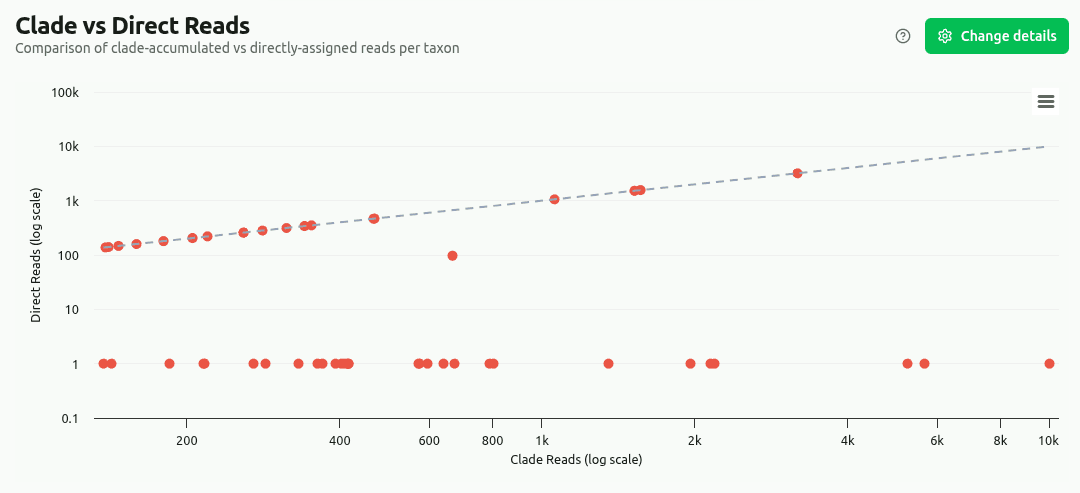
clade-vs-direct
Comparación lado a lado de lecturas de clado (taxón + todos los descendientes) versus lecturas asignadas directamente para los principales taxones. Incluye una razón de especificidad (directo / clado): valores cercanos a 1,0 significan que la mayoría de las lecturas se asignan directamente a ese taxón, mientras que valores cercanos a 0 significan que la abundancia es impulsada por sub-taxones.
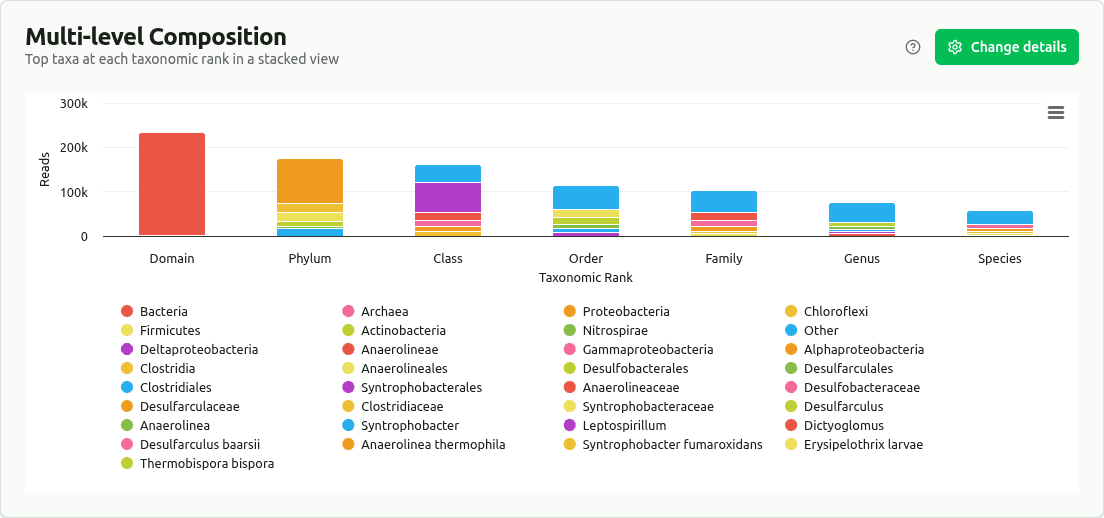
multilevel-composition
Gráfico de barras apiladas mostrando los principales taxones (por lecturas de clado) en cada rango principal, con taxones restantes agrupados como 'Otros'. Revela cómo la composición comunitaria cambia a medida que aumenta la resolución de clasificación de Dominio a Especie.
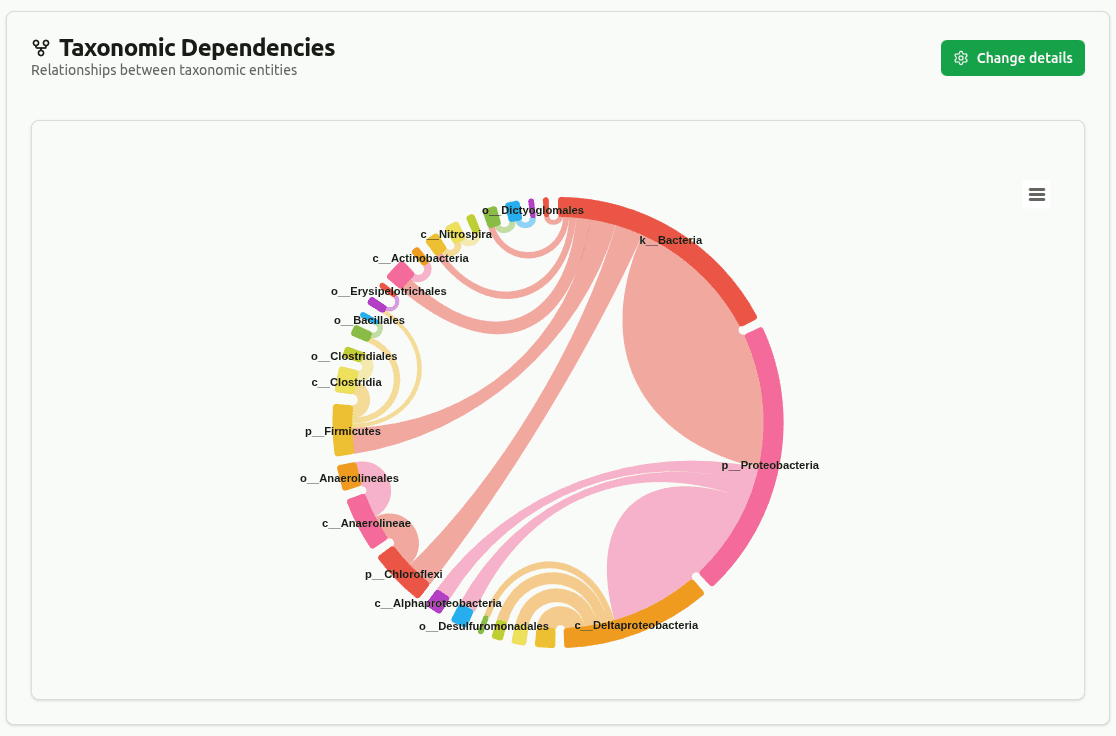
dependency-wheel
Diagrama de cuerdas conectando taxones padre a taxones hijo a través de rangos (hasta el rango máximo seleccionado). El grosor de la conexión es proporcional al conteo de lecturas de clado compartidas. Las aristas por debajo de un umbral mínimo de cobertura (5% por defecto del total de lecturas) se filtran.
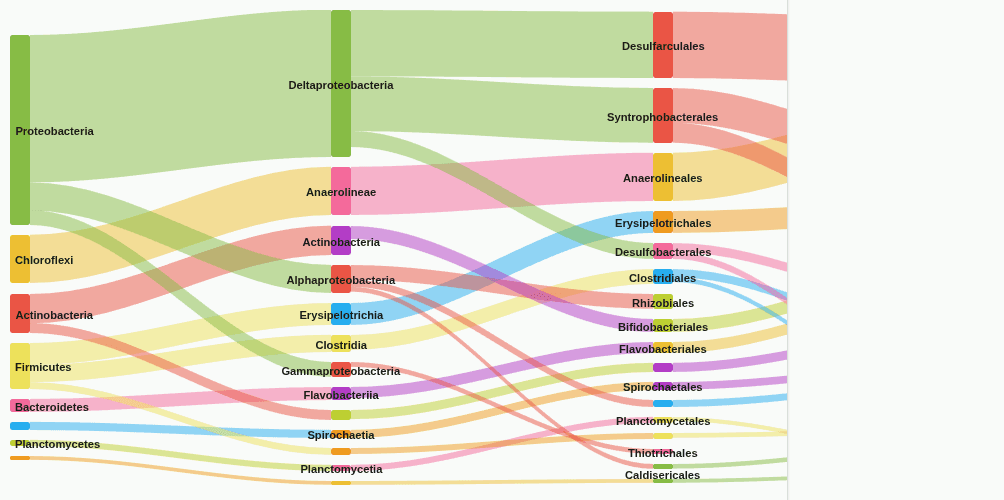
sankey-flow
Diagrama de flujo Sankey trazando cómo se distribuyen las lecturas desde el rango inicial (Dominio por defecto) al rango final (Género por defecto). El ancho de cada banda equals el conteo de lecturas que fluyen de un taxón padre a un taxón hijo. Las aristas por debajo de un umbral mínimo de cobertura (5% por defecto) se eliminan para reducir el desorden.
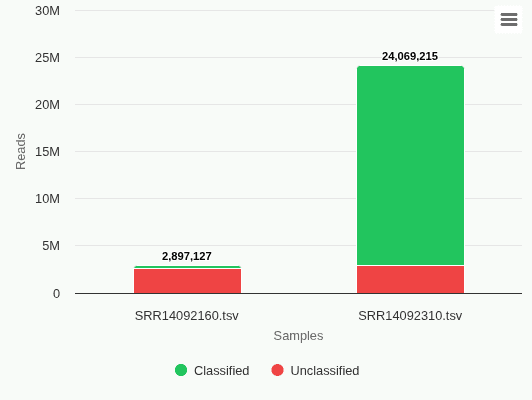
comp-classification
Gráfico de barras apiladas mostrando lecturas clasificadas versus no clasificadas totales por muestra. Permite comparar rápidamente las tasas de clasificación entre muestras — fracciones no clasificadas grandes pueden indicar organismos novedosos o limitaciones de la base de datos.
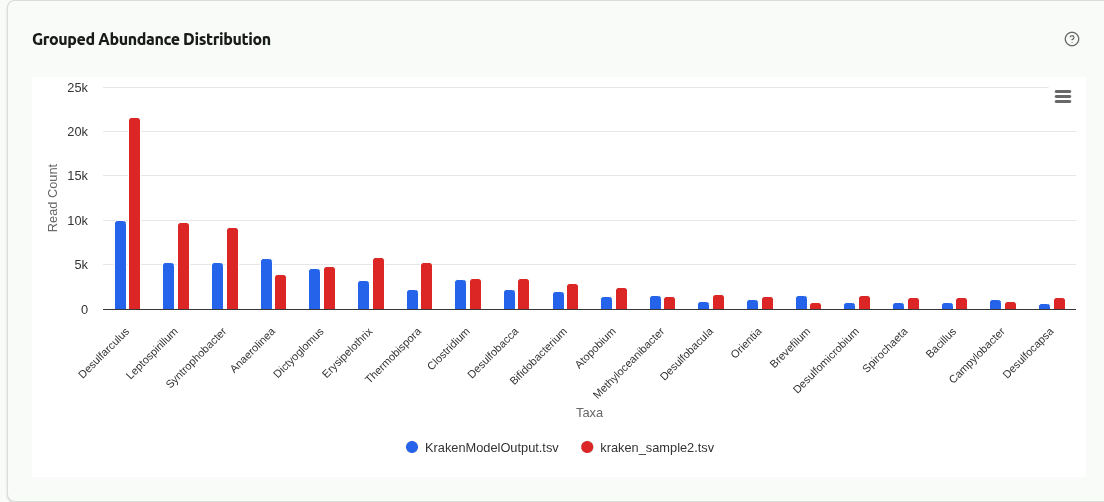
comp-grouped-abundance
Gráfico de barras agrupadas colocando los principales taxones de cada muestra lado a lado en el rango seleccionado. Cada grupo contiene una barra por muestra, coloreada por identidad de muestra, permitiendo comparación visual directa de conteos de lecturas de clado absolutos para el mismo organismo a través de muestras.
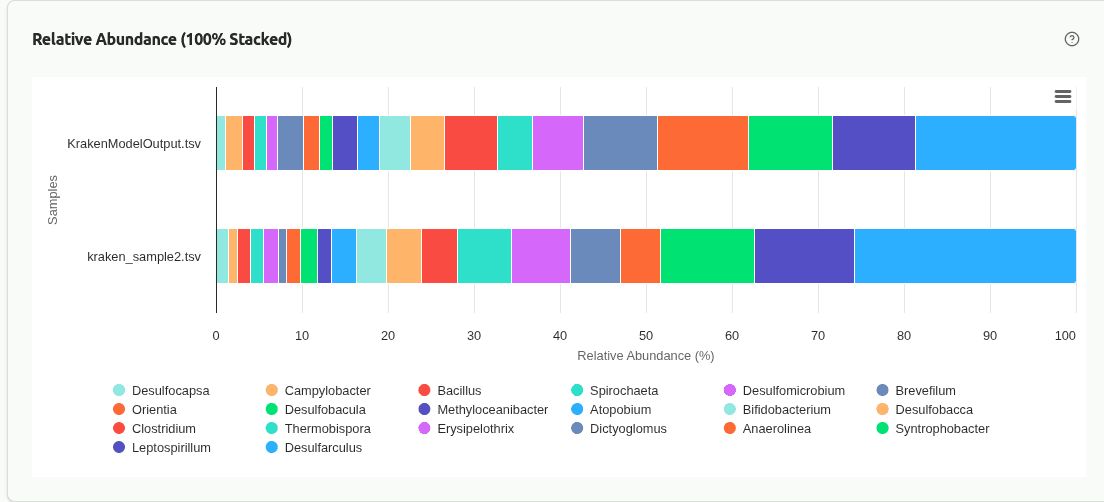
comp-relative-abundance
Gráfico de barras apiladas al 100% donde cada barra representa una muestra y los segmentos muestran la contribución proporcional de cada taxón. Útil para comparar composición comunitaria cuando las muestras tienen profundidades de secuenciación muy diferentes, ya que todas las barras se normalizan a la misma altura.
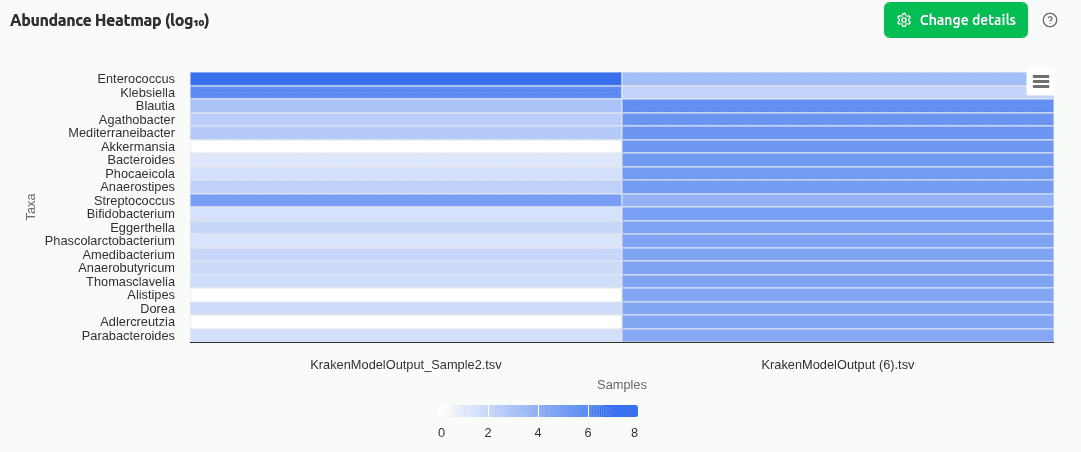
comp-abundance-heatmap
Mapa de calor de matriz de colores con taxones en un eje y muestras en el otro. La intensidad del color de la celda es proporcional a la abundancia de lecturas de clado en el rango seleccionado. El agrupamiento jerárquico en ambos ejes agrupa muestras similares y taxones coocurrentes.
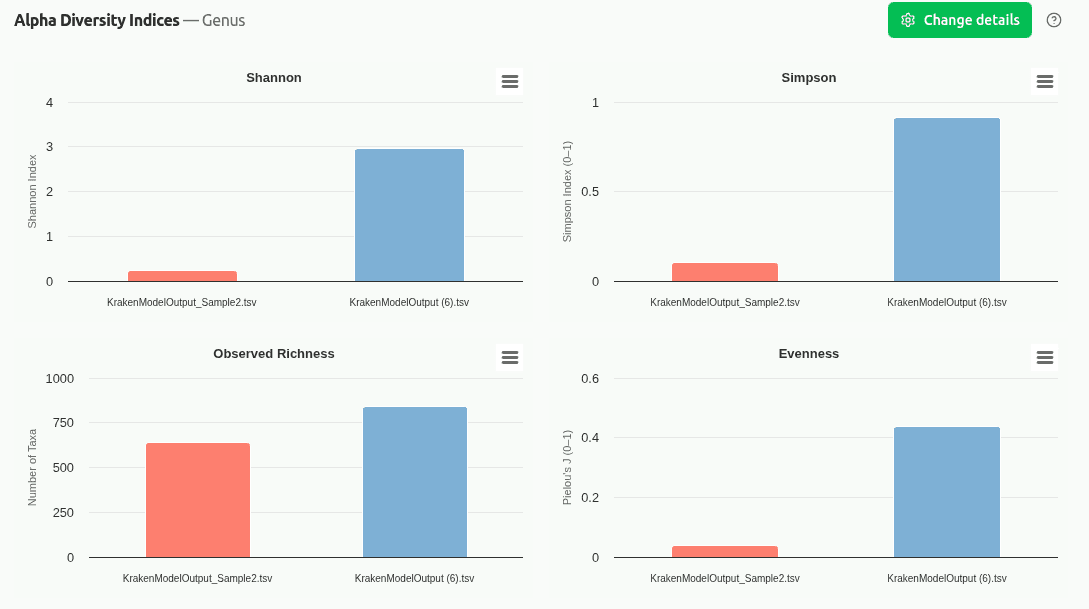
comp-diversity-indices
Gráfico de múltiples paneles mostrando entropía de Shannon, diversidad de Simpson, Riqueza Observada, y Equitatividad de Pielou para cada muestra en su propia escala del eje y. Permite comparación rápida entre muestras de diversidad alfa sin distorsión de escala.
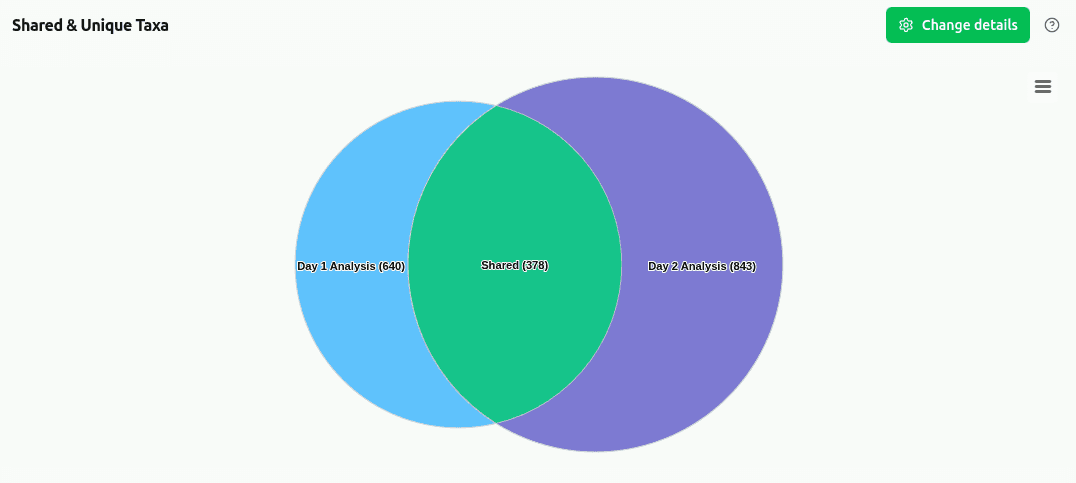
comp-shared-taxa
Diagrama de Venn mostrando el conteo de taxones compartidos entre muestras versus taxones exclusivos de cada muestra individual. Calculado en el rango taxonómico seleccionado usando presencia/ausencia de lecturas de clado ≥ 1.
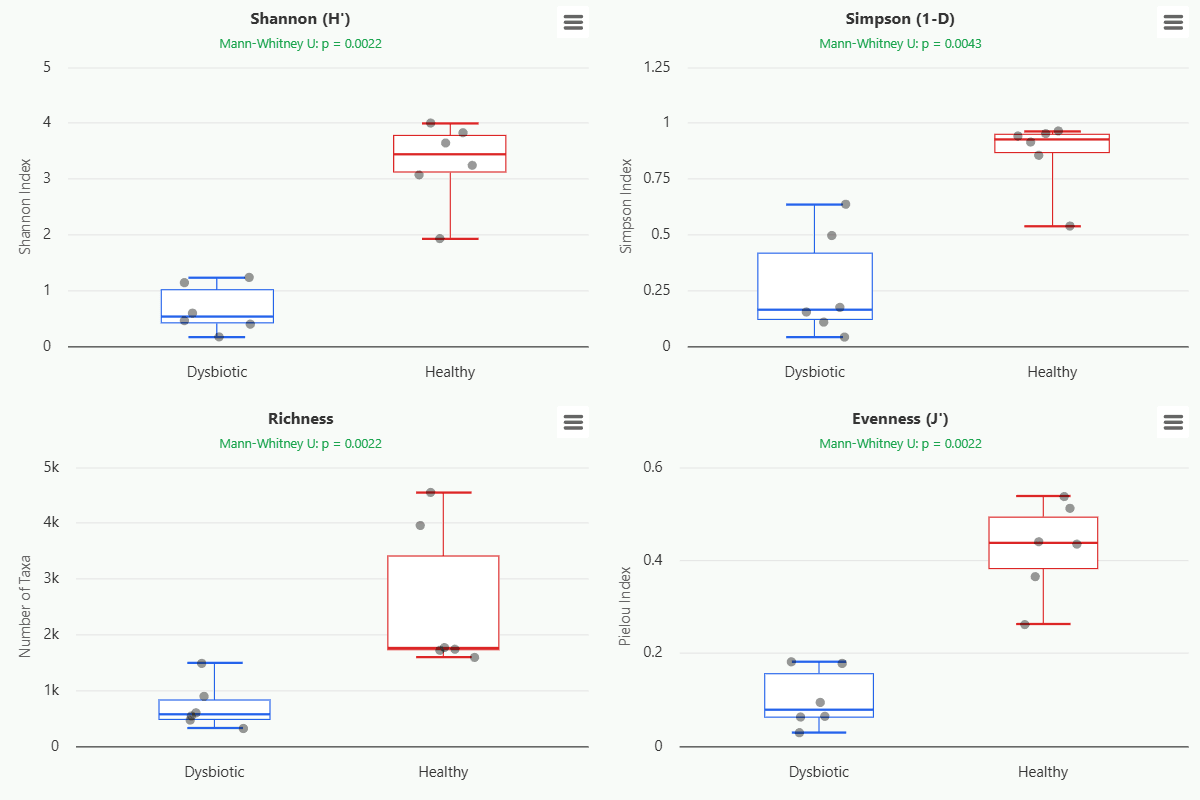
group-alpha-diversity
Diagramas de caja de entropía de Shannon, diversidad de Simpson, Riqueza Observada, y Equitatividad de Pielou por grupo. Cada caja resume la variación dentro del grupo. Los valores p de Kruskal-Wallis prueban diferencias significativas entre grupos.
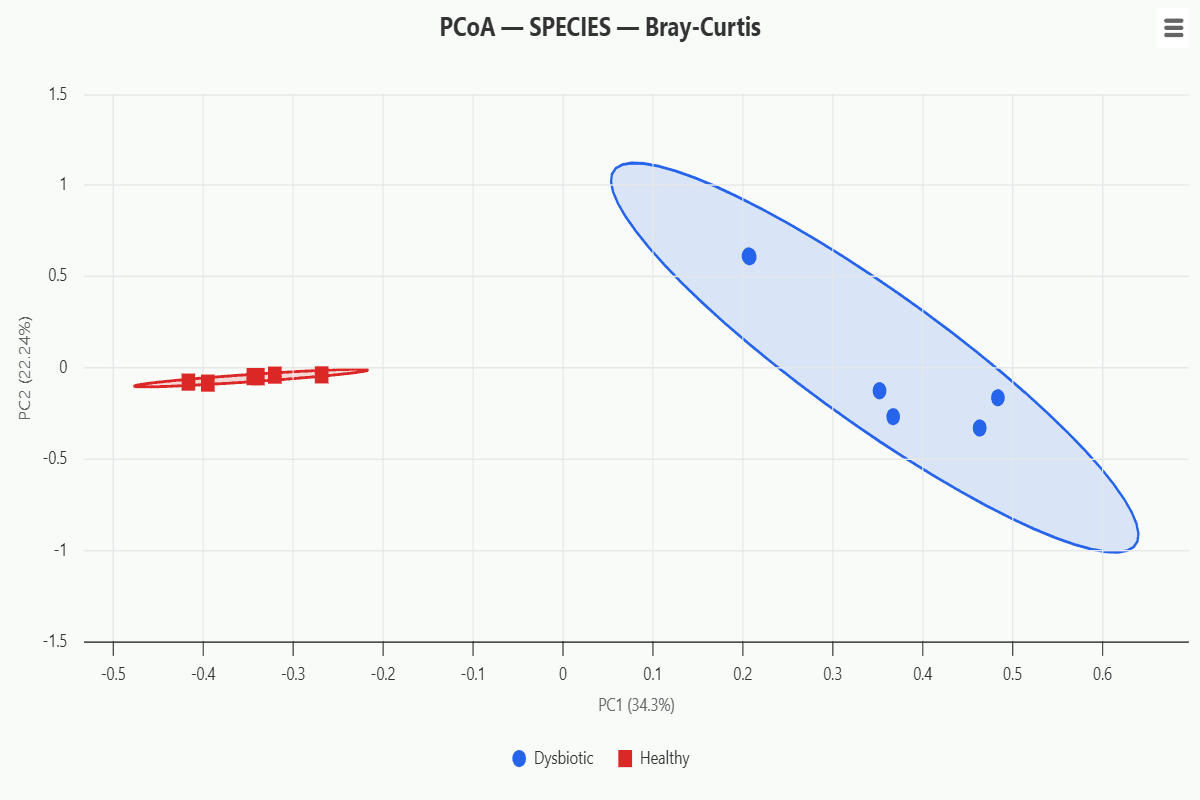
group-pcoa
Análisis de Coordenadas Principales (PCoA) en matriz de disimilitud de Bray-Curtis. Los puntos están coloreados por asignación de grupo con elipses de confianza del 95%. Las etiquetas de los ejes muestran el porcentaje de varianza explicada por cada coordenada.
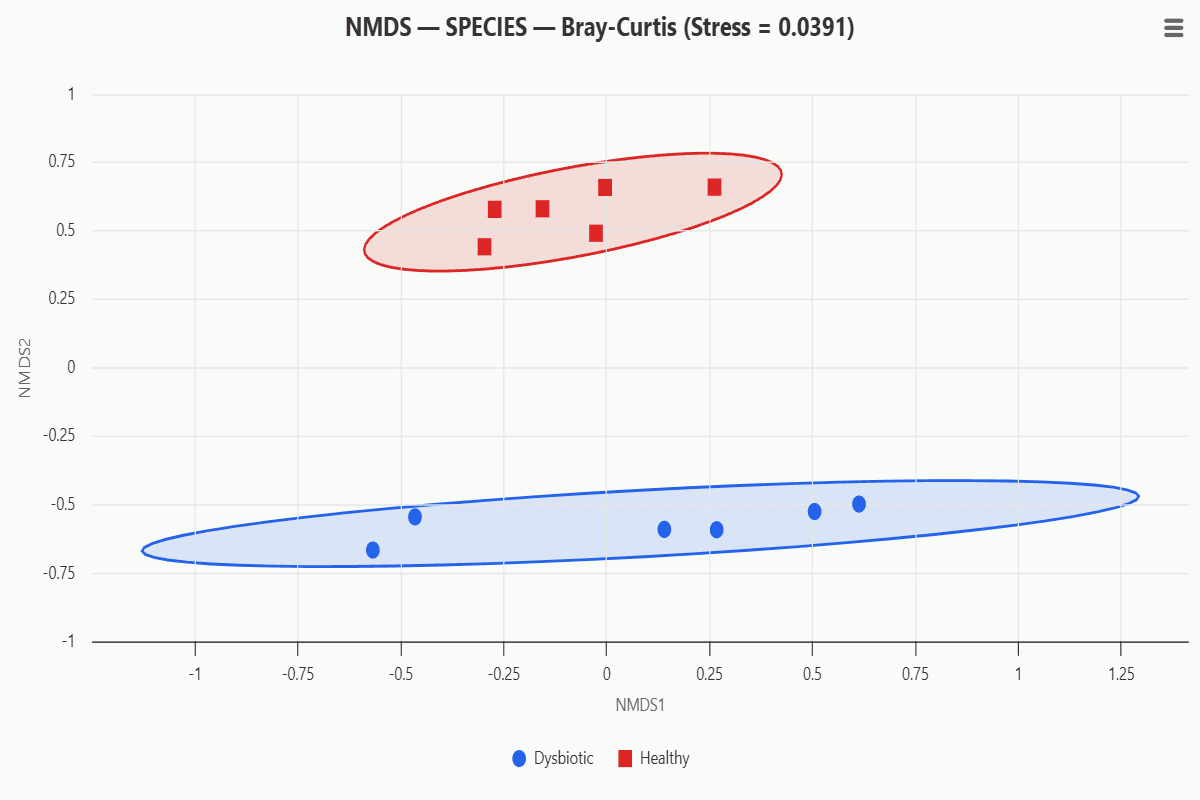
group-nmds
Escalonamiento Multidimensional No Métrico (NMDS) ordenación con valor de stress mostrado. Puntos coloreados por grupo con elipses de confianza. Un stress más bajo (<0,2) indica una buena representación de las distancias originales en 2D.
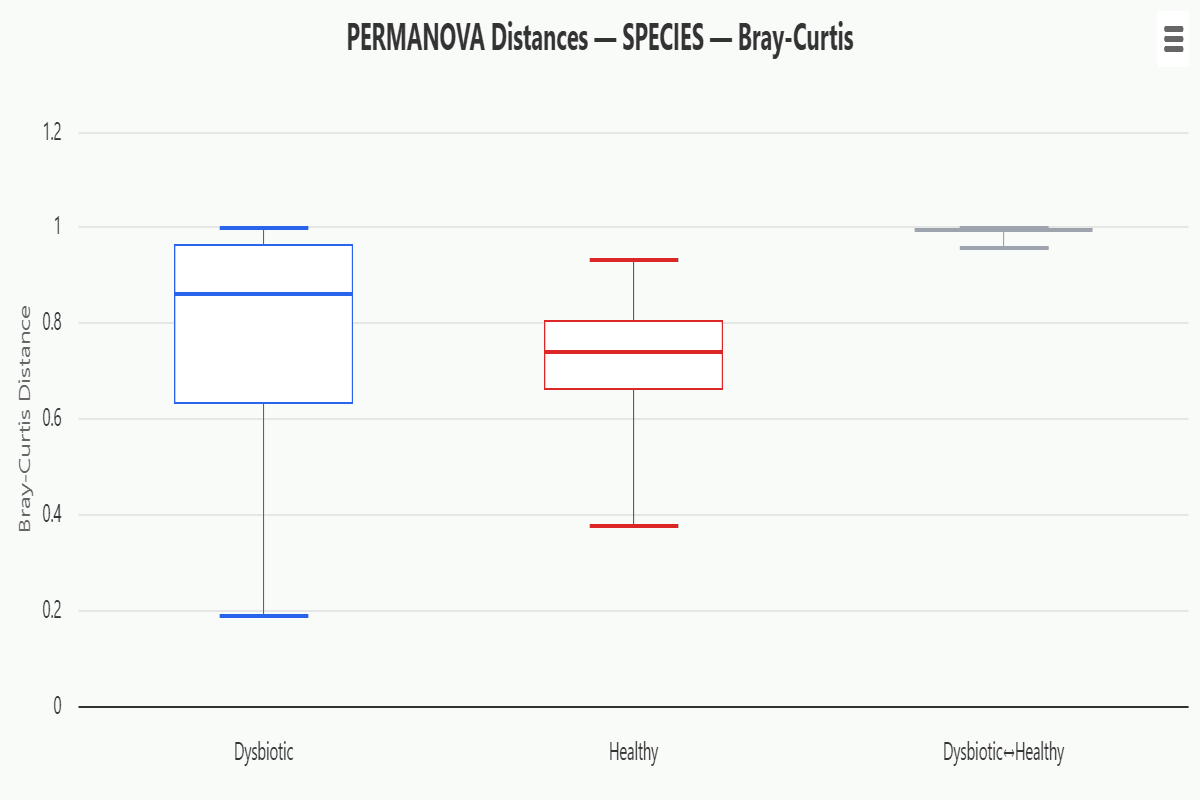
group-distance-boxplots
Diagramas de caja de distancias de Bray-Curtis intra-grupo versus inter-grupo. PERMANOVA R² y valor p cuantifican la fracción de varianza explicada por agrupamiento. La estadística R de ANOSIM mide el grado de separación de grupos.
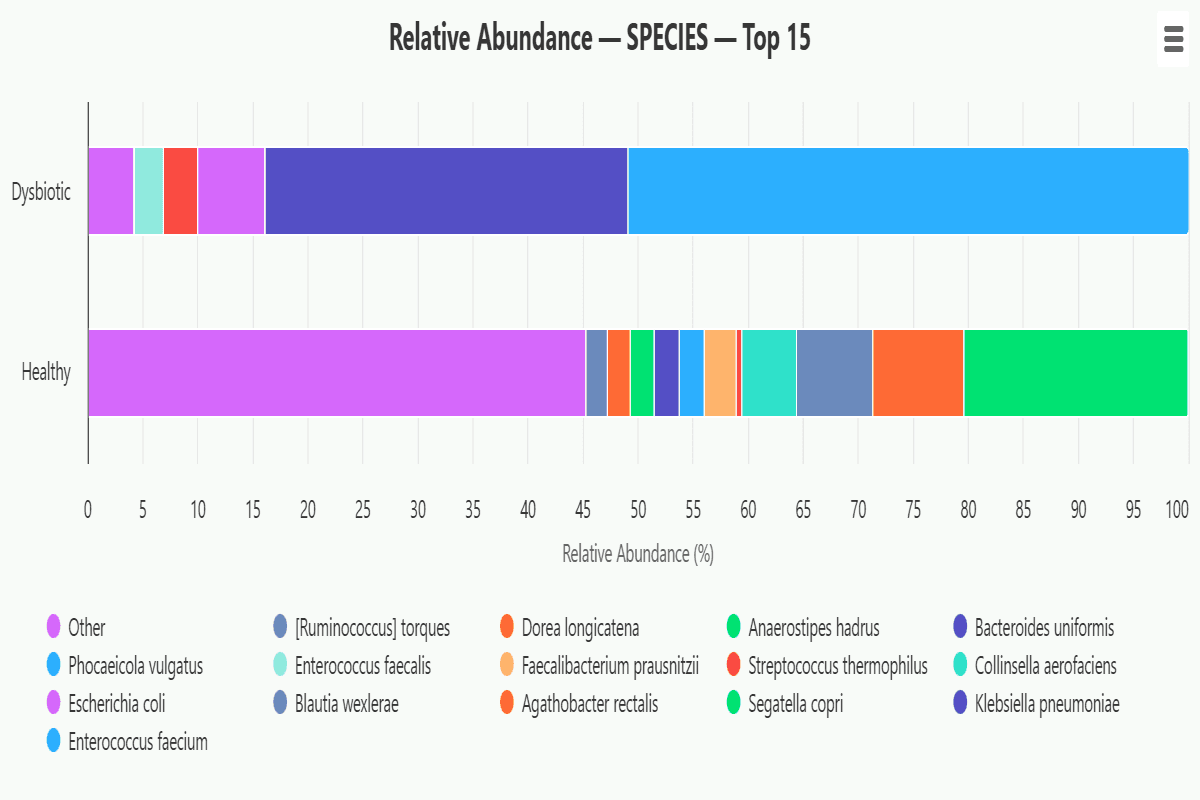
group-relative-abundance
Abundancia relativa promediada por grupo como barras apiladas al 100% en el rango taxonómico seleccionado. Cada barra muestra la composición proporcional media a través de todas las muestras del grupo, permitiendo comparación directa a nivel de grupo.
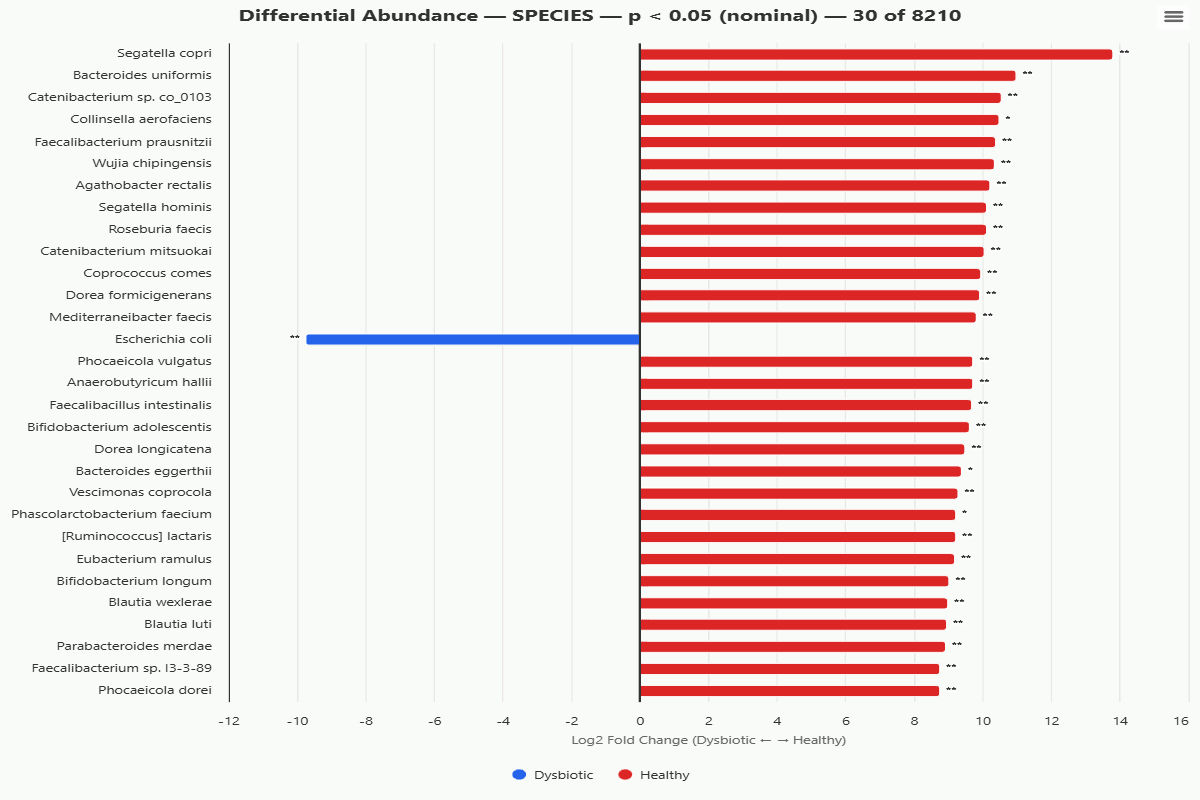
group-differential-abundance
Gráfico de barras de taxones con diferencias significativas de abundancia entre grupos (prueba de Kruskal-Wallis, corrección FDR de Benjamini-Hochberg). El color indica qué grupo tiene mayor abundancia. Solo se muestran taxones que pasan el umbral de significancia.
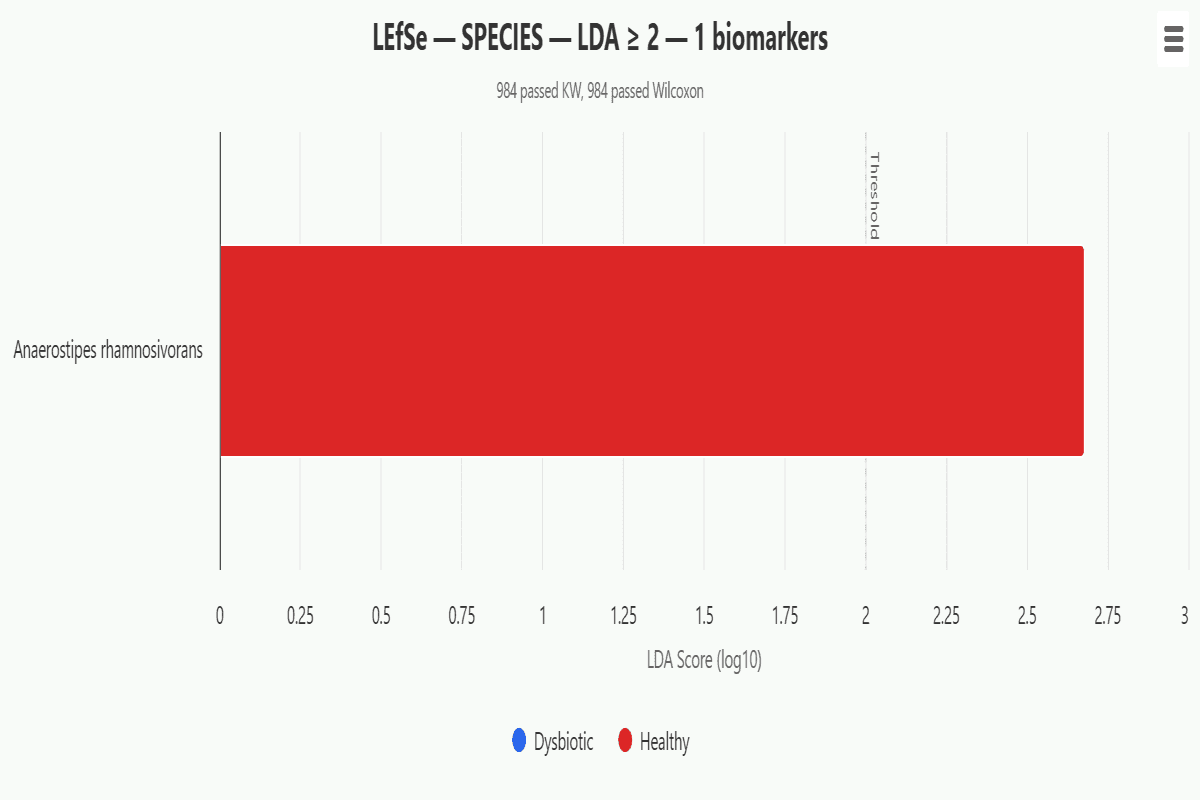
group-lefse
LEfSe (Análisis de Discriminante Lineal de Tamaño del Efecto) gráfico de biomarcadores. Las barras horizontales muestran puntuaciones de LDA para taxones que discriminan significativamente entre grupos. Las puntuaciones de LDA más altas indican una asociación más fuerte con el grupo respectivo.
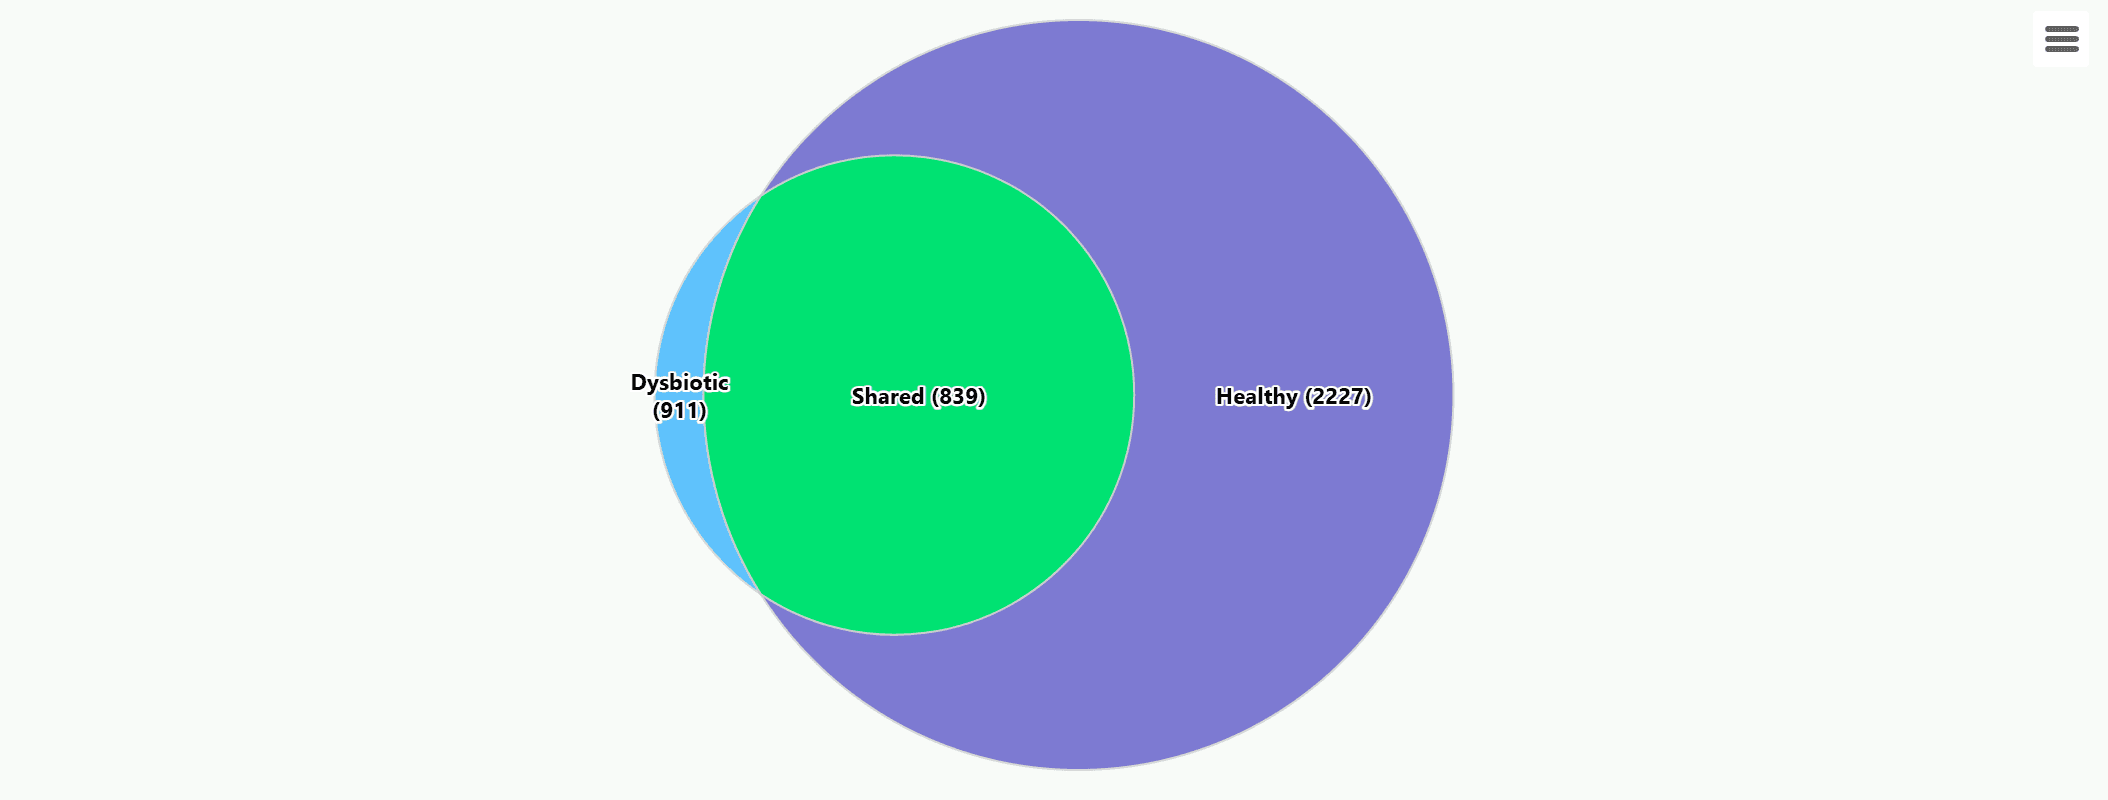
group-shared-taxa
Diagrama de Venn mostrando taxones compartidos y únicos a través de grupos experimentales. El conjunto de taxones de cada grupo es la unión de todos los taxones detectados en cualquier muestra perteneciente a ese grupo. Haga clic en regiones para ver la lista específica de taxones con conteos de lecturas.
group-classification
Gráfico de columnas apiladas mostrando lecturas clasificadas versus no clasificadas medias por grupo experimental. Las barras de error representan desviación estándar a través de muestras dentro de cada grupo. La información emergente muestra desglose de porcentaje y conteo de muestras por grupo.
group-distribution
Gráfico de columnas agrupadas mostrando conteos de lecturas medios para los principales N taxones en el nivel taxonómico seleccionado, agrupados por grupo experimental. Las barras de error muestran desviación estándar. Permite comparación de patrones de abundancia taxonómica entre grupos.
group-heatmap
Mapa de calor de conteos de lecturas transformados logarítmicamente (log₁₀) medios por grupo experimental (columnas) y taxones (filas). La intensidad del color refleja abundancia, permitiendo comparación visual rápida de perfiles taxonómicos a través de grupos.
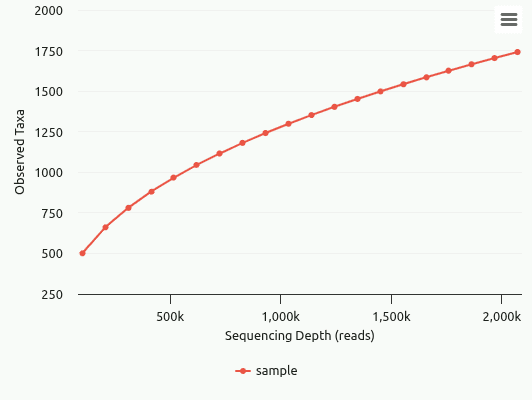
rarefaction
Curva de rarefacción trazando taxones observados versus profundidad de lectura submuestreada en el rango seleccionado. Calculada analíticamente usando la expectativa hipergeométrica. Una curva que se estabiliza indica profundidad de secuenciación suficiente; una curva aún ascendente sugiere submuestreo.
rank-abundance
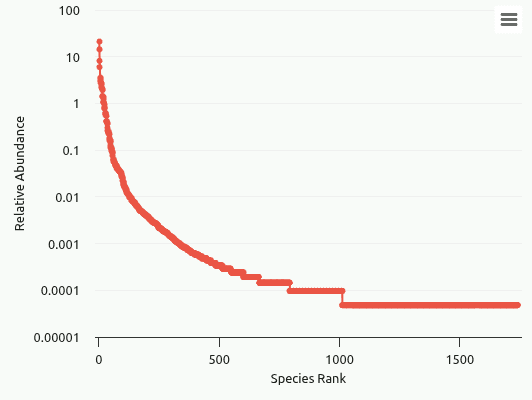
Curva de abundancia clasificada (gráfico de Whittaker) con taxones clasificados por abundancia relativa decreciente en un eje y logarítmico. La longitud de la curva a lo largo del eje x refleja riqueza, mientras que la pendiente indica equitatividad — una caída pronunciada significa que pocos taxones dominan.
comp-rarefaction
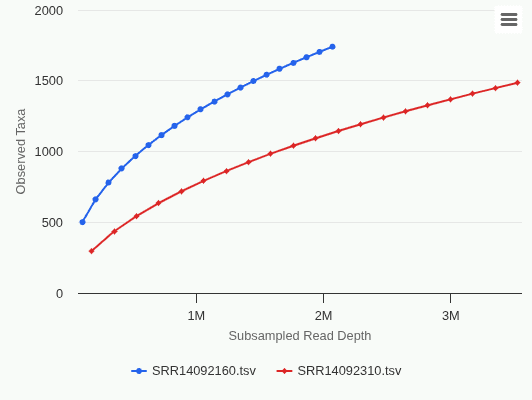
Curvas de rarefacción superpuestas para todas las muestras cargadas. Permite comparación visual del esfuerzo de secuenciación y saturación taxonómica a través de muestras.
comp-rank-abundance
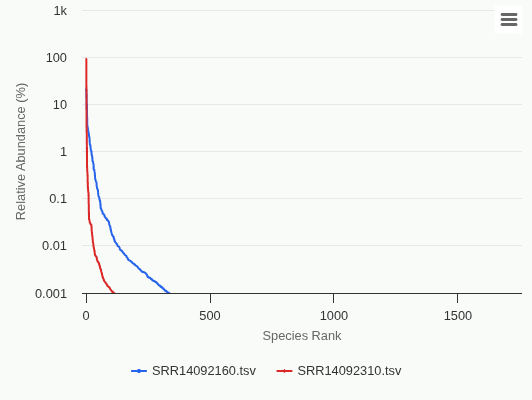
Curvas de abundancia clasificadas superpuestas para todas las muestras cargadas. Curvas más pronunciadas indican comunidades más desequilibradas dominadas por menos taxones.
group-taxonomic-sunburst
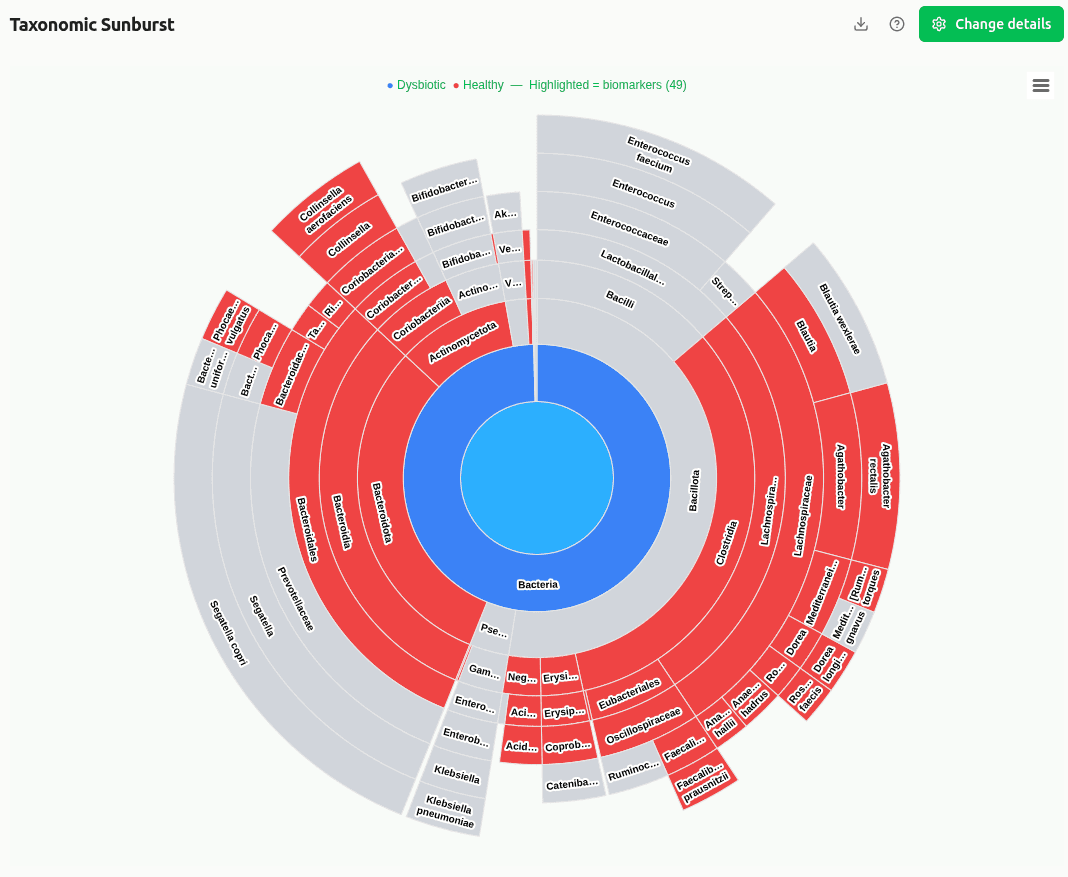
Sunburst interactivo mostrando la jerarquía taxonómica completa como anillos concéntricos. Los nodos de biomarcadores de LEfSe están coloreados por su grupo enriquecido; nodos no significativos son grises. Haga clic en cualquier segmento de anillo para profundizar.
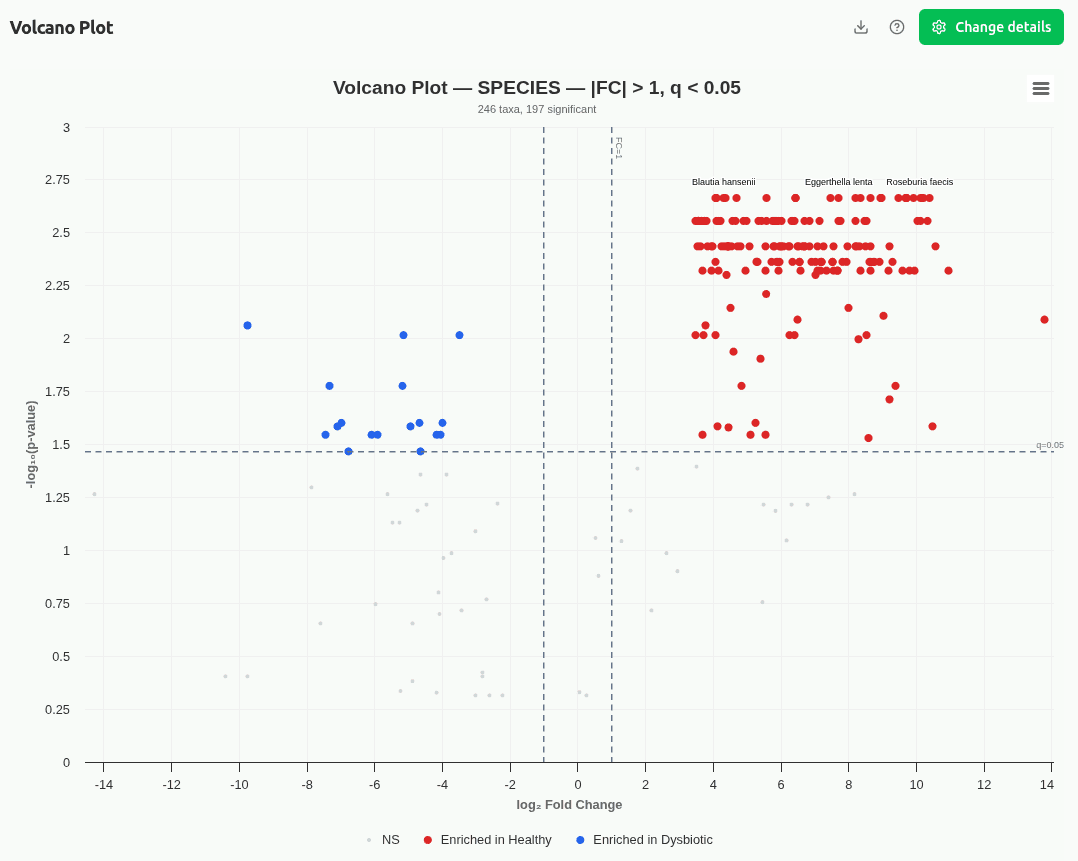
group-volcano
Gráfico de volcán: cambio de pliegue log₂ (x) versus −log₁₀ valor p ajustado (y). Los puntos por encima de la línea horizontal pasan significancia (FDR de BH). Los puntos coloreados están enriquecidos significativamente en el grupo respectivo.